
Acoustic modelling from the signal domain using CNNs
3. Neural network architecture
此处描述了在本文当中所使用的网络结构,和所提取的关键特征(key features)。首先,描述了两个新型的网络结构:the network-in-network nonlinearity和the statistics extraction layer(NIN非线性结构和统计信息提取层)。
3.1 Network-in-Network nonlinearity
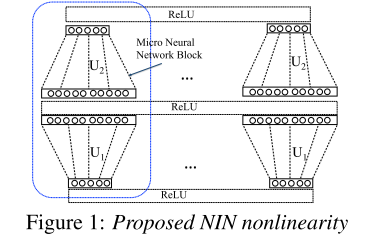
如图(1)所示,该网络结构是一个多对多的非线性系统,由两个块对角阵组成,在使用的过程中,在同一层中,所有的NIN模块是参数共享的,且互相之间不重叠(non-overlapping)。
在NIN的内部,转换块(transformation block)\(U_1\)是尺寸为\(m\times k\)的矩阵,将尺寸为\(m\)的输入映射到维度为\(k\)的高维空间中,然后使用Relu函数进行非线性映射;\(U_2\)是尺寸为\(k\times n\)的矩阵,将非线性变化后的\(k\)维变量映射到\(n\)为空间当中,再进行Relu非线性映射。该NIN模块在论文中称之为“micro neural network blocks”。
如果,NIN模块在单层网络中共享权值,那么\(U_1\)的每一列可以解释为一维卷积核,且卷积核的尺寸为\(m\),卷积的步长为\(m\)。
对于此处的理解:
\[
x \cdot U_{(m,k)}=x \cdot [u_1,u_2 \cdots u_k]=[x\cdot u_1,x\cdots u_2 \cdots x\cdot u_k]
\]
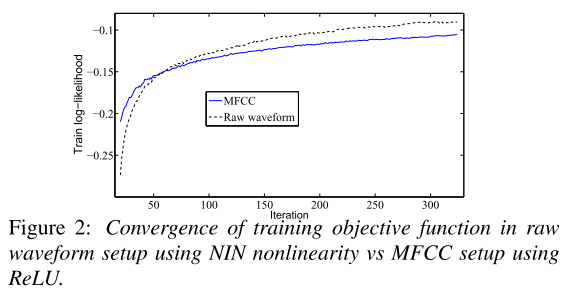
在图(2)当中,将本文提出的网络与基于MFCC的基线系统目标函数的收敛情况进行对比,可以得到:本文提出的网络目标函数的收敛速度较快,且收敛之后的目标函数的数值较好。
Acoustic modelling from the signal domain using CNNs的更多相关文章
- 基于SincNet的原始波形说话人识别
speaker recognition from raw waveform with SincNet Mirco Ravanelli, Yoshua Bengio 作为一种可行的替代i-vector的 ...
- 论文翻译:2018_Deep Learning for Acoustic Echo Cancellation in Noisy and Double-Talk Scenarios
论文地址:深度学习用于噪音和双语场景下的回声消除 博客地址:https://www.cnblogs.com/LXP-Never/p/14210359.html 摘要 传统的声学回声消除(AEC)通过使 ...
- 论文翻译:2020_Attention Wave-U-Net for Acoustic Echo Cancellation
论文地址:http://www.interspeech2020.org/uploadfile/pdf/Thu-1-10-10.pdf Attention Wave-U-Net 的回声消除 摘要 提出了 ...
- Paper List ABOUT Deep Learning
Deep Learning 方向的部分 Paper ,自用.一 RNN 1 Recurrent neural network based language model RNN用在语言模型上的开山之作 ...
- Deep Learning方向的paper
转载 http://hi.baidu.com/chb_seaok/item/6307c0d0363170e73cc2cb65 个人阅读的Deep Learning方向的paper整理,分了几部分吧,但 ...
- Introduction to CELP Coding
Speex is based on CELP, which stands for Code Excited Linear Prediction. This section attempts to in ...
- Tips on Acoustic Signal Processing
1.声音的三个主要的主观属性(即音量.音调.音色).音色(Timbre)是指不同的声音的频率表现在波形方面总是有与众不同的特性,音色的不同取决于不同的泛音.频率的高低决定声音的音调,振幅的大小决定声音 ...
- 论文翻译:2020_Joint NN-Supported Multichannel Reduction of Acoustic Echo, Reverberation and Noise
论文地址:https://ieeexploreieee.fenshishang.com/abstract/document/9142362 神经网络支持的回声.混响和噪声联合多通道降噪 摘要 我们考虑 ...
- 《The challenge of realistic music generation: modelling raw audio at scale》论文阅读笔记
The challenge of realistic music generation: modelling raw audio at scale 作者:Deep mind三位大神 出处:NIPS ...
随机推荐
- Win7 Win8 Win10取不到机器码的处理办法
1.更改UAC也就是用户账户的控制权限 2.以管理员身份运行软件
- 调试HDF0308-A50的相机驱动。
使用rk3128做为主芯片: 使用andriod5.1-sdk软件包. 1.在rk3128-86v.dts 中加入头文件 #include "rk3128-cif-sensor.dtsi&q ...
- FileStream说明
FileStream(String, FileMode) FileStream(String path, FileMode) 文件打开模式:(FileMode)包括6个枚举 Append:追加 ...
- 理解 ASP.NET Web API 中的 HttpParameterBinding
背景 问题的起因是这样的.群里面一个哥们儿发现在使用 ASP.NET WebAPI 时,不能在同一个方法签名中使用多次 FromBodyAttribute 这个 Attribute .正好我也在用 W ...
- HTTP 学习心得
一.什么是HTTP? 超文本传输协议(HTTP,HyperText Transfer Protocol)是互联网上应用最为广泛的一种网络协议.所有的WWW文件都必须遵守这个标准.设计HTTP最初的目的 ...
- html跳动的心实现代码
<style> .box{ width: 200px; height: 400px; positio ...
- tensorflow_目标识别object_detection_api,RuntimeError: main thread is not in main loop,fig = plt.figure(frameon=False)_tkinter.TclError: no display name and no $DISPLAY environment variable
最近在使用目标识别api,但是报错了: File "/usr/local/lib/python2.7/dist-packages/tensorflow/python/ops/script_o ...
- Django 缓存
官方文档 缓存的出现就是为了减轻对数据库的压力和加快内存访问的速度.我们的访问请求最终都是返回一个大的字符串,缓存就是将这段字符串直接存储起来,下次你来了,不用经过view去数据库或者内存拿到数据再渲 ...
- EOS
1.移植性特别差,例如用Eclipse,idea,等其他集成工具开发之后的项目,难以快速的搭建到EOS集成工具中(例如逻辑流,数据结构等)2.项目框架的局限性大,底层封装的框架或者组件迭代性较差,很难 ...
- 我们一起踩过的坑----react(antd)(一)
1.}] && ){ ){ ){ ||){ ){ );); , }; }); }, beforeUpload: (file) => { ...