
Stanford机器学习---第一讲. Linear Regression with one variable
原文:http://blog.csdn.net/abcjennifer/article/details/7691571
本栏目(Machine learning)包括单参数的线性回归、多参数的线性回归、Octave Tutorial、Logistic Regression、Regularization、神经网络、机器学习系统设计、SVM(Support Vector Machines 支持向量机)、聚类、降维、异常检测、大规模机器学习等章节。所有内容均来自Standford公开课machine learning中Andrew老师的讲解。(https://class.coursera.org/ml/class/index)
第一章-------单参数线性回归 Linear Regression with one variable
(一)、Cost Function
线性回归是给出一系列点假设拟合直线为h(x)=theta0+theta1*x, 记Cost Function为J(theta0,theta1)
之所以说单参数是因为只有一个变量x,即影响回归参数θ1,θ0的是一维变量,或者说输入变量只有一维属性。
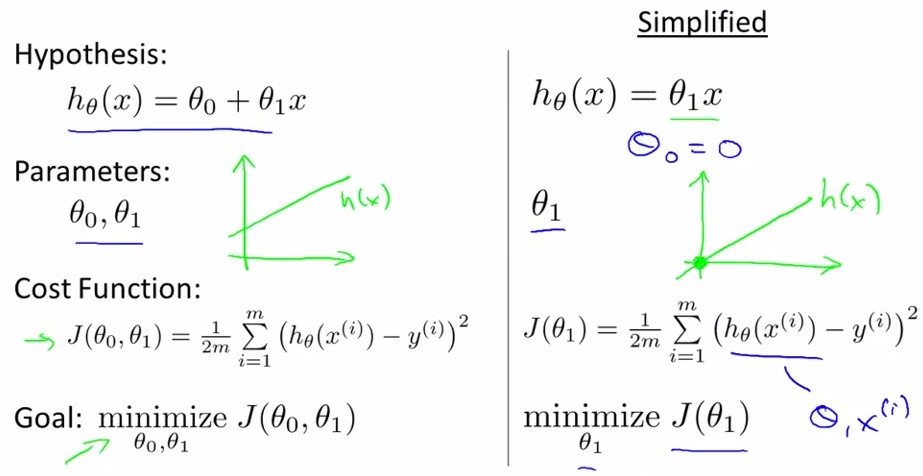
下图中为简化模式,只有theta1没有theta0的情况,即拟合直线为h(x)=theta1*x
左图为给定theta1时的直线和数据点
 ×
右图为不同theta1下的cost function J(theta1)
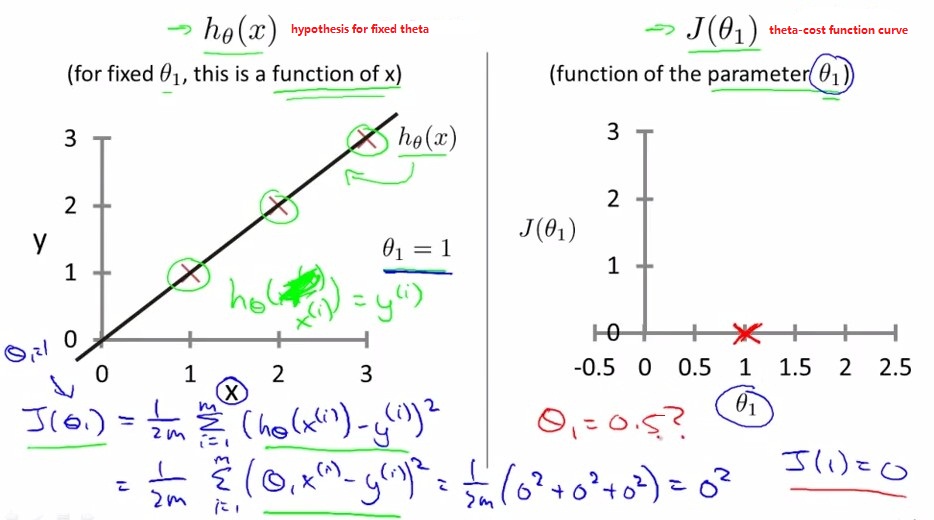
cost function plot:

当存在两个参数theta0和theta1时,cost function是一个三维函数,这种样子的图像叫bowl-shape function

将上图中的cost function在二维上用不同颜色的等高线映射为如下右图,可得在左图中给定一个(theta0,theta1)时又图中显示的cost function.
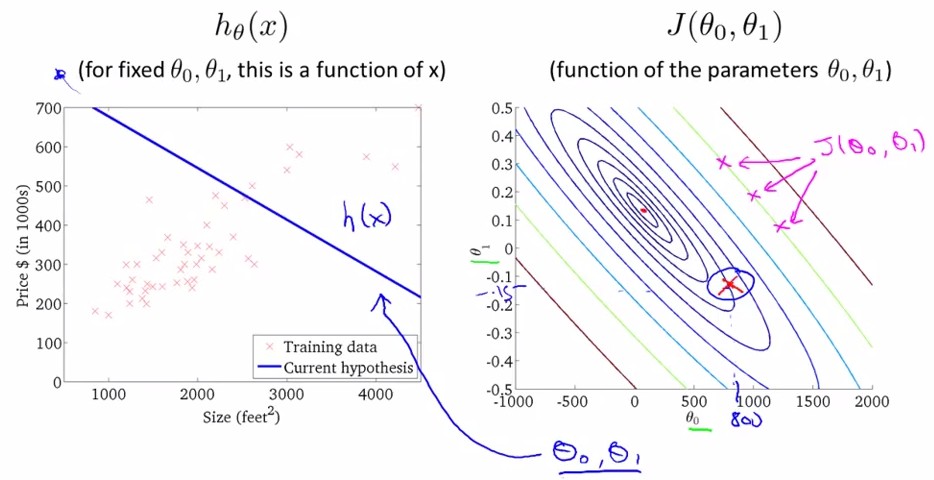

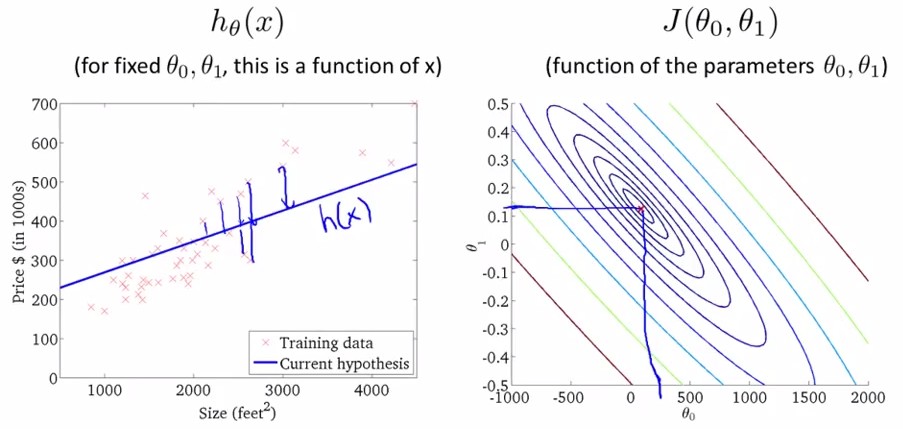
我们的目的是最小化cost function,即上图中最后一幅图,theta0=450,theta1=0.12的情况。
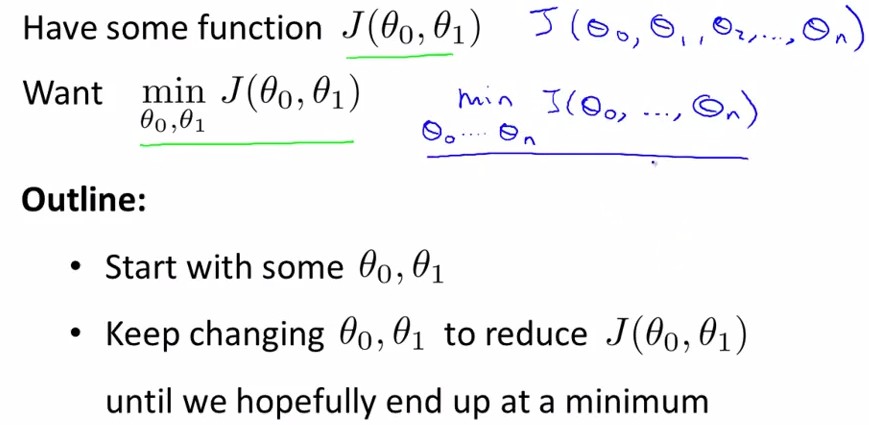
(二)、Gradient descent
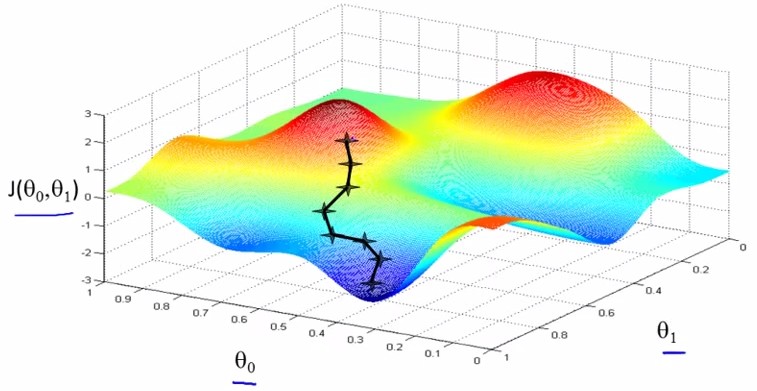
gradient descent是指梯度下降,为的是将cost funciton 描绘出之后,让参数沿着梯度下降的方向走,并迭代地不断减小J(theta0,theta1),即稳态。
每次沿着梯度下降的方向:
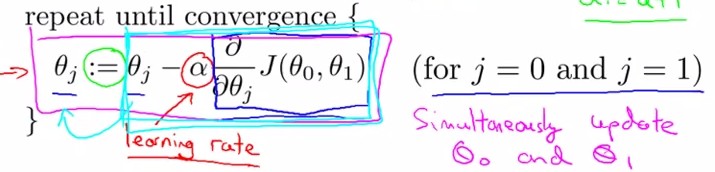
参数的变换公式:其中标出了梯度(蓝框内)和学习率(α):
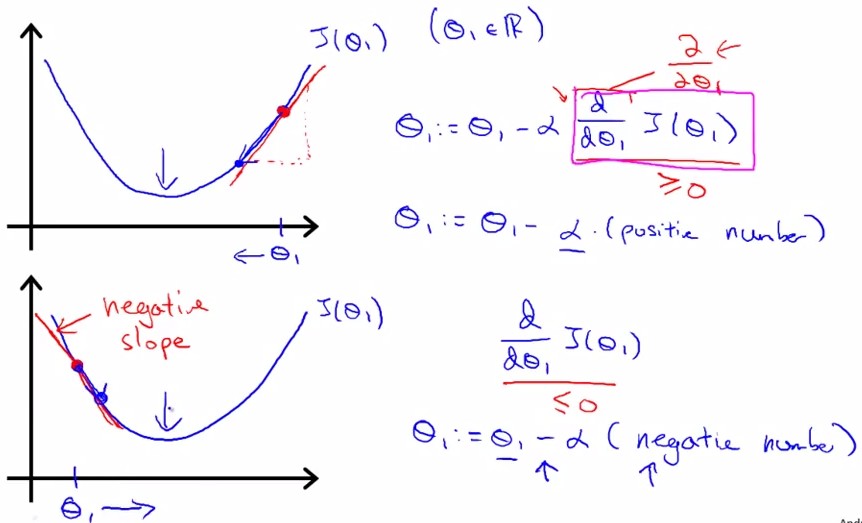
gradient即J在该点的切线斜率slope,tanβ。下图所示分别为slope(gradient)为正和负的情况:
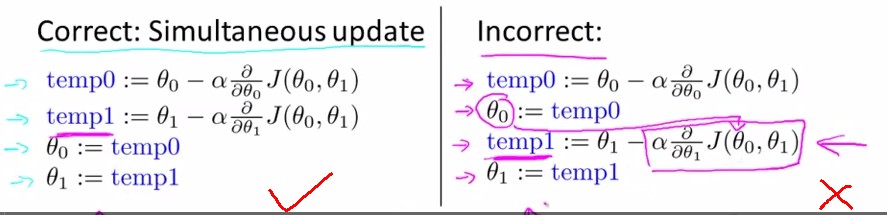
同时更新theta0和theta1,左边为正解:
关于学习率:
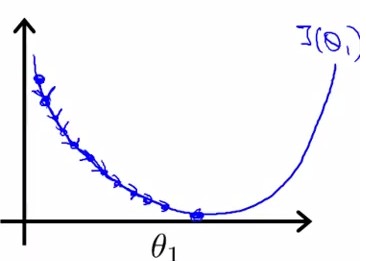
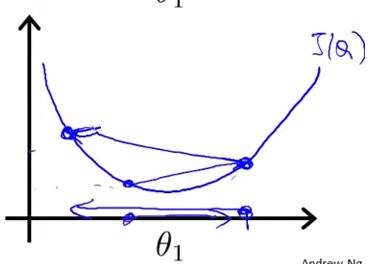
α太小:学习很慢; α太大:容易过学习
所以如果陷入局部极小,则slope=0,不会向左右变换
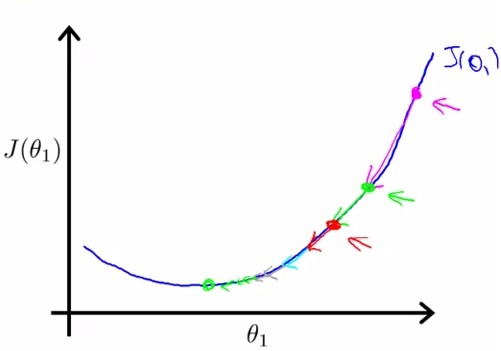
本图表示:无需逐渐减小α,就可以使下降幅度逐渐减小(因为梯度逐渐减小):
求导后:
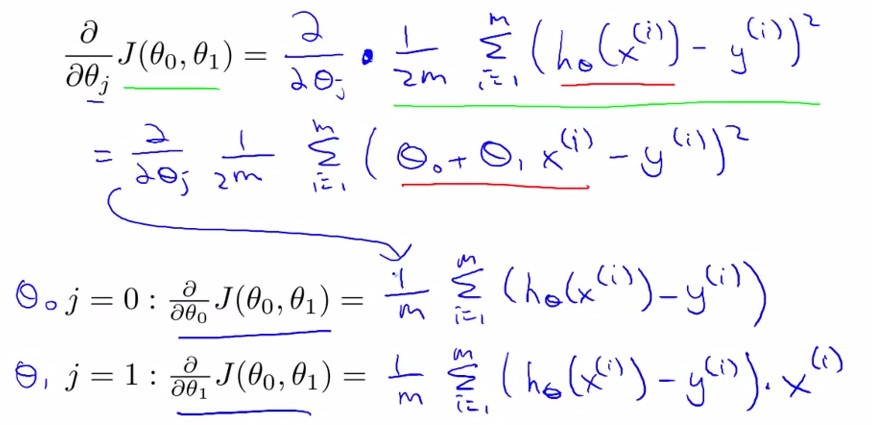
由此我们得到:
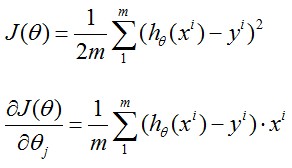
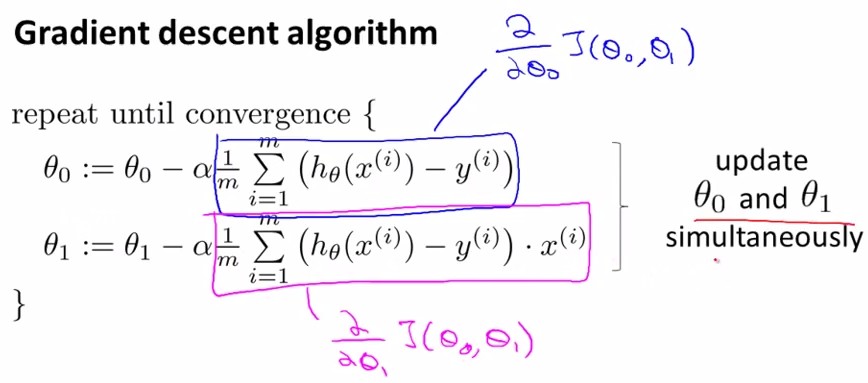
其中x(i)表示输入数据x中的第i组数据
Stanford机器学习---第一讲. Linear Regression with one variable的更多相关文章
- 机器学习笔记1——Linear Regression with One Variable
Linear Regression with One Variable Model Representation Recall that in *regression problems*, we ar ...
- 李宏毅老师机器学习第一课Linear regression
机器学习就是让机器学会自动的找一个函数 学习图谱: 1.regression example appliation estimating the combat power(cp) of a pokem ...
- Stanford机器学习---第二讲. 多变量线性回归 Linear Regression with multiple variable
原文:http://blog.csdn.net/abcjennifer/article/details/7700772 本栏目(Machine learning)包括单参数的线性回归.多参数的线性回归 ...
- 机器学习 (一) 单变量线性回归 Linear Regression with One Variable
文章内容均来自斯坦福大学的Andrew Ng教授讲解的Machine Learning课程,本文是针对该课程的个人学习笔记,如有疏漏,请以原课程所讲述内容为准.感谢博主Rachel Zhang的个人笔 ...
- Andrew Ng机器学习 一: Linear Regression
一:单变量线性回归(Linear regression with one variable) 背景:在某城市开办饭馆,我们有这样的数据集ex1data1.txt,第一列代表某个城市的人口,第二列代表在 ...
- 机器学习笔记-1 Linear Regression(week 1)
1.Linear Regression with One variable Linear Regression is supervised learning algorithm, Because th ...
- Andrew Ng机器学习编程作业: Linear Regression
编程作业有两个文件 1.machine-learning-live-scripts(此为脚本文件方便作业) 2.machine-learning-ex1(此为作业文件) 将这两个文件解压拖入matla ...
- 【cs229-Lecture2】Linear Regression with One Variable (Week 1)(含测试数据和源码)
从Ⅱ到Ⅳ都在讲的是线性回归,其中第Ⅱ章讲得是简单线性回归(simple linear regression, SLR)(单变量),第Ⅲ章讲的是线代基础,第Ⅳ章讲的是多元回归(大于一个自变量). 本文的 ...
- MachineLearning ---- lesson 2 Linear Regression with One Variable
Linear Regression with One Variable model Representation 以上篇博文中的房价预测为例,从图中依次来看,m表示训练集的大小,此处即房价样本数量:x ...
随机推荐
- Android--多选自动搜索提示
一. 效果图 常见效果,在搜素提示选中之后可以继续搜索添加,选中的词条用特殊字符分开 二. 布局代码 <MultiAutoCompleteTextView android:id="@+ ...
- AngularJS开发指南6:AngularJS表单详解
表单控件(input, select, textarea )是用来获取用户输入的.表单则是一组有联系的表单控件的集合. 用户能通过表单和表单控件提供验证的服务,知道自己的输入是否合法.这样能让用户交互 ...
- iOS---cell-自适应高度
RootViewController: // // RootViewController.m // UI__cell自适应高度 // // Created by dllo on 16/3/15. // ...
- iOS开发小技巧--利用运行时得到隐藏的成员变量
一.关于运行时,已经从网络上摘抄了一片文章,这里只有项目中自己的简单使用 -- 查找隐藏的成员变量 导入头文件 可以获得隐藏的成员变量,方法,属性等 代码: 打印效果图:
- Maven-环境快速搭建
Jdk 1.5以上java开发环境. Eclipse IDE 一个. Maven 3.0.3下载地址: http://maven.apache.org/docs/3.0.3/release-note ...
- 【UVA 11462】 Age Sort(基数排序)
题 题意 给你最多2000000个数据,大小是1到99的数,让你排序输出. 分析 快排也可以过.不过这题本意是要基数排序(桶排序),就是读入年龄age, a[age]++,然后输出时,从1到99岁(看 ...
- Dancing Links初学记
记得原来备战OI的时候,WCX大神就研究过Dancing Links算法并写了一篇blog.后来我还写了个搜索策略的小文章( http://www.cnblogs.com/pdev/p/3952279 ...
- openSSL命令、PKI、CA、SSL证书原理
相关学习资料 http://baike.baidu.com/view/7615.htm?fr=aladdin http://www.ibm.com/developerworks/cn/security ...
- FatMouse的交易问题
想按照某个值排序,用sort()函数,结果想了半天不知道用数组怎么解决,然后看了答案,才知道原来可以用struct,想想我真是笨死了.. 原题描述以及答案如下: Problem Description ...
- IOS基础之 (七) 分类Category
一 Category 分类:Category(类目,类别) (OC有) 命名:原来的类+类别名(原来的类名自动生成,只要写后面的类别名,一般以模块名为名.比如原来类 Person,新建分类 Ct,新建 ...