
oracle利用redo恢复
oracle媒介恢复(Media Recovery)
官方资料
https://docs.oracle.com/database/121/ADMQS/GUID-CBC5870F-2C9A-4F67-B5E9-D65049AD1E8E.htm#ADMQS09112
翻译如下:
如果还原存档的重做日志文件和数据文件,则必须先执行介质恢复,然后才能打开数据库。归档重做日志文件中未反映在数据文件中的任何数据库事务都将应用于数据文件,从而在打开数据库之前将它们置于事务一致状态。
介质恢复需要控制文件,数据文件(通常从备份恢复)以及包含自备份数据文件以来的更改的联机和归档重做日志文件。介质恢复通常用于从介质故障中恢复,例如丢失文件或磁盘,或用户错误,例如删除表的内容。
媒体恢复可以是完全恢复或时间点恢复。完全恢复可以应用于单个数据文件,表空间或整个数据库。时间点恢复适用于整个数据库(有时也适用于单个表空间,具有Oracle Recover Manager(RMAN)的自动化帮助)。
在完全恢复中,您可以还原备份数据文件,并将存档和联机重做日志文件中的所有更改应用于数据文件。数据库在发生故障时返回其状态,可以在不丢失数据的情况下打开。
在时间点恢复中,您将数据库返回到过去用户选择的时间的内容。您可以还原在目标时间之前创建的数据文件的备份以及从备份创建到目标时间的一整套归档重做日志文件。恢复将备份时间和目标时间之间的更改应用于数据文件。目标时间之后的所有更改都将被丢弃。
RMAN使您可以执行数据库的完整和时间点恢复。但是,本文档重点介绍完全恢复。
“执行用户定向恢复”
有关时间点恢复的更多详细信息,请参见“Oracle数据库备份和恢复用户指南”
案例分析实践
例1:数据库正常关闭后redo丢失
oracle在正常关闭过程中会将buffer cache中的脏块都写入数据文件,同时执行全面检查点,保证数据库一致性,所以关闭丢失redo日志,可以以resetlogs打开数据库不丢失数据。实际上reodo不丢失的话,oracle默认以noresetlogs打开数据库。
正常关闭数据库会同步校验各文件,使得重新启动的时候文件时间点一致并且不用进行崩溃恢复(Crash Recovery)
- 正常关闭数据库
SQL> shutdown immediate

Database closed.

Database dismounted.

ORACLE instance shut down. - 删除redo日志
-rw-r----- 1 oracle oinstall   9748480 Jul 10 14:55 control01.ctl

-rw-r----- 1 oracle oinstall  52429312 Jul 10 04:00 redo01.log

-rw-r----- 1 oracle oinstall  52429312 Jul 10 11:00 redo02.log

-rw-r----- 1 oracle oinstall  52429312 Jul 10 14:55 redo03.log

-rw-r----- 1 oracle oinstall 660611072 Jul 10 14:55 sysaux01.dbf

-rw-r----- 1 oracle oinstall 786440192 Jul 10 14:55 system01.dbf

-rw-r----- 1 oracle oinstall  30416896 Jul 10 14:45 temp01.dbf

-rw-r----- 1 oracle oinstall  94380032 Jul 10 14:55 undotbs01.dbf

-rw-r----- 1 oracle oinstall   5251072 Jul 10 14:55 users01.dbf

[oracle@zml-rhel6 orcl63]$ rm -f redo0*

[oracle@zml-rhel6 orcl63]$ ll

total 1523900

-rw-r----- 1 oracle oinstall   9748480 Jul 10 14:55 control01.ctl

-rw-r----- 1 oracle oinstall 660611072 Jul 10 14:55 sysaux01.dbf

-rw-r----- 1 oracle oinstall 786440192 Jul 10 14:55 system01.dbf

-rw-r----- 1 oracle oinstall  30416896 Jul 10 14:45 temp01.dbf

-rw-r----- 1 oracle oinstall  94380032 Jul 10 14:55 undotbs01.dbf

-rw-r----- 1 oracle oinstall 5251072 Jul 10 14:55 users01.dbf - 启动数据库至MOUNT
SQL> startup mount

ORACLE instance started.

Total System Global Area 4993982464 bytes

Fixed Size            2261808 bytes

Variable Size         1040190672 bytes

Database Buffers     3942645760 bytes

Redo Buffers            8884224 bytes

Database mounted. - 执行不完全恢复
SQL> recover database until cancel;

Media recovery complete. - resetlogs打开数据库
SQL> alter database open resetlogs;

Database altered.
启动成功。resetlogs的解释参见:oracle的resetlogs机制浅析
linux系统中因为文件句柄的原因,即便在oracle open状态下删除redo日志,依然可以正常运行,同时也能正常关闭。如下例子说明:
open状态删除redo
-rw-r----- 1 oracle oinstall   9748480 Jul 10 15:05 control01.ctl

-rw-r----- 1 oracle oinstall  52429312 Jul 10 15:05 redo01.log

-rw-r----- 1 oracle oinstall  52429312 Jul 10 15:02 redo02.log

-rw-r----- 1 oracle oinstall  52429312 Jul 10 15:02 redo03.log

-rw-r----- 1 oracle oinstall 660611072 Jul 10 15:02 sysaux01.dbf

-rw-r----- 1 oracle oinstall 786440192 Jul 10 15:02 system01.dbf

-rw-r----- 1 oracle oinstall  30416896 Jul 10 14:45 temp01.dbf

-rw-r----- 1 oracle oinstall  94380032 Jul 10 15:02 undotbs01.dbf

-rw-r----- 1 oracle oinstall   5251072 Jul 10 15:02 users01.dbf

[oracle@zml-rhel6 orcl63]$ rm -f redo0*- 查看占用redo文件的进程
[oracle@zml-rhel6 orcl63]$ lsof|grep redo

lsof: WARNING: can't stat() fuse.gvfs-fuse-daemon file system /root/.gvfs

      Output information may be incomplete.

oracle    27082    oracle  258u      REG                8,3  52429312    6684835 /u01/app/oracle/oradata/orcl63/redo01.log (deleted)

oracle    27082    oracle  259u      REG                8,3  52429312    6684838 /u01/app/oracle/oradata/orcl63/redo02.log (deleted)

oracle    27082    oracle  260u      REG                8,3  52429312    6684839 /u01/app/oracle/oradata/orcl63/redo03.log (deleted)
[oracle@zml-rhel6 orcl63]$ ps -ef|grep 27082
oracle 27082 1 0 14:59 ? 00:00:00 ora_lgwr_orcl63
oracle 28808 23232 0 15:08 pts/2 00:00:00 grep 27082可以看到redo log文件被系统标记为deleted,但是没有真正的删除,该文件正在被进程lgwr占用。linux的文件句柄会在应用程序关闭后才会释放文件,所以此期间即便删除了也可以正常关闭数据库。此后再以resetlogs启动便可。
例2:数据库异常关闭(kill or shutdown abort)的恢复
数据库异常关闭kill或shutdown abort,这个时候文件状态可能不一致。若检查点信息一致,则做崩溃恢复。若检查点信息不一致(正好在更新文件头)则需要做介质恢复。
以下演示redo不丢失和丢失的情况
一、redo不丢失
- shutdown abort关闭数据库
SQL> shutdown abort

ORACLE instance shut down. - 启动到MOUNT
SQL> startup mount

ORACLE instance started.

Total System Global Area 4993982464 bytes

Fixed Size            2261808 bytes

Variable Size         1040190672 bytes

Database Buffers     3942645760 bytes

Redo Buffers            8884224 bytes

Database mounted. - 查询控制文件中记录的数据文件的检查点信息以及END SCN信息
SQL> select file#,checkpoint_change#,last_change# from v$datafile;

     FILE# CHECKPOINT_CHANGE# LAST_CHANGE#

---------- ------------------ ------------

     1          1602035

     2          1602035

     3          1602035

     4          1602035
可以看到END SCN为NULL,说明数据库上次是异常关闭。
数据库正常运行过程中,该END SCN号始终为NULL。而当数据库正常关闭时,会进行完全检查点,并将检查点SCN号更新该字段。而崩溃时,Oracle还来不及更新该字段,则该字段仍然为NULL。当SMON进程发现该字段为空时,就知道实例在上次没有正常关闭,于是由SMON进程就开始进行实例恢复了。
- 打开数据库
SQL> alter database open;

Database altered.
查看此过程的告警日志:
(从告警日志红色标注内容可知,打开过程中,数据库进行了crash recovery,应用redo日志进行前滚和回滚操作)Wed Jul 11 16:16:49 2018
alter database open
Beginning crash recovery of 1 threads
parallel recovery started with 15 processes
Started redo scan
Completed redo scan
read 175 KB redo, 97 data blocks need recovery
Started redo application at
Thread 1: logseq 9, block 782
Recovery of Online Redo Log: Thread 1 Group 3 Seq 9 Reading mem 0
Mem# 0: /u01/app/oracle/oradata/orcl63/redo03.log
Completed redo application of 0.13MB
Completed crash recovery at
Thread 1: logseq 9, block 1133, scn 1622464
97 data blocks read, 97 data blocks written, 175 redo k-bytes read
Wed Jul 11 16:16:49 2018
Thread 1 advanced to log sequence 10 (thread open)
Thread 1 opened at log sequence 10
Current log# 1 seq# 10 mem# 0: /u01/app/oracle/oradata/orcl63/redo01.log
Successful open of redo thread 1
MTTR advisory is disabled because FAST_START_MTTR_TARGET is not set
Wed Jul 11 16:16:49 2018
SMON: enabling cache recovery
[] Successfully onlined Undo Tablespace 2.
Undo initialization finished serial:0 start:2869436558 end:2869436588 diff:30 (0 seconds)
Verifying file header compatibility for 11g tablespace encryption..
Verifying 11g file header compatibility for tablespace encryption completed
SMON: enabling tx recovery
Database Characterset is ZHS16GBK
No Resource Manager plan active
replication_dependency_tracking turned off (no async multimaster replication found)
Starting background process QMNC
Wed Jul 11 16:16:50 2018
QMNC started with pid=36, OS id=16458
Completed: alter database open
Wed Jul 11 16:16:50 2018
db_recovery_file_dest_size of 41820 MB is 0.00% used. This is a
user-specified limit on the amount of space that will be used by this
database for recovery-related files, and does not reflect the amount of
space available in the underlying filesystem or ASM diskgroup.
Wed Jul 11 16:16:50 2018
Starting background process CJQ0
Wed Jul 11 16:16:50 2018
CJQ0 started with pid=38, OS id=16472 ---------------------------------------------------------------------------------------------------------
关于应用redo日志进行前滚和回滚的说明如下: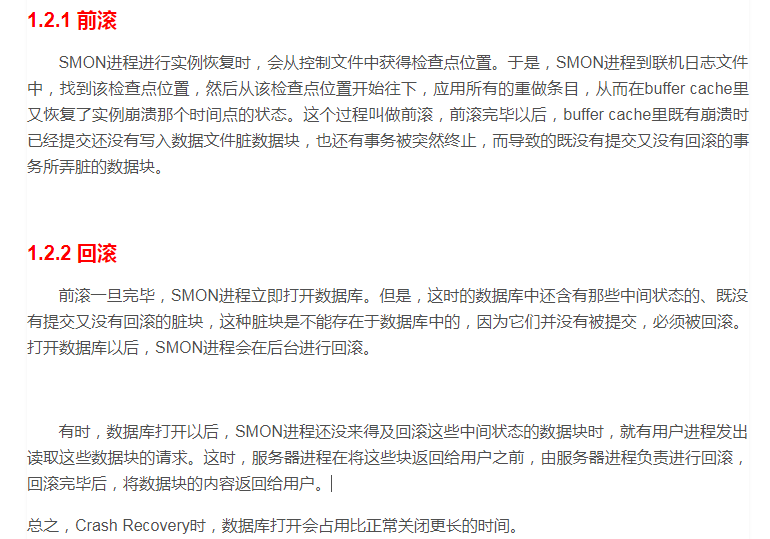
二、redo丢失(数据库处于归档模式下,归档不丢失)
(归档没有用,数据库异常关闭,数据库未进行完全检查点,需要redo进行crash recovery,而异常关闭时,归档进行可能都没有来得及将redo日志刷到归档日志中。这种情况只能通过不完全恢复后,修改参数文件允许resetlogs启动,强制以resetlogs,即不一致启动,但是可能导致ora-00600。如果有ora-00600则要重装数据库了。)
- 归档模式下shutdown immediate关闭数据库
SQL> archive log list

Database log mode           Archive Mode

Automatic archival           Enabled

Archive destination           USE_DB_RECOVERY_FILE_DEST

Oldest online log sequence     8

Next log sequence to archive   10

Current log sequence           10

SQL> shutdown abort

ORACLE instance shut down. - 删除redo日志
[oracle@zml-rhel6 orcl63]$ ls -rlt

total 1698848

-rw-r----- 1 oracle oinstall  52429312 Jul 11 16:59 redo03.log

-rw-r----- 1 oracle oinstall  52429312 Jul 11 16:59 redo02.log

-rw-r----- 1 oracle oinstall  94380032 Jul 11 16:59 undotbs01.dbf

-rw-r----- 1 oracle oinstall 786440192 Jul 11 16:59 system01.dbf

-rw-r----- 1 oracle oinstall 681582592 Jul 11 16:59 sysaux01.dbf

-rw-r----- 1 oracle oinstall   5251072 Jul 11 16:59 users01.dbf

-rw-r----- 1 oracle oinstall  30416896 Jul 11 16:59 temp01.dbf

-rw-r----- 1 oracle oinstall  52429312 Jul 11 17:00 redo01.log

-rw-r----- 1 oracle oinstall   9748480 Jul 11 17:00 control01.ctl

[oracle@zml-rhel6 orcl63]$ rm -f redo0* - 启动到mount
SQL> startup mount

ORACLE instance started.

Total System Global Area 4993982464 bytes

Fixed Size            2261808 bytes

Variable Size         1040190672 bytes

Database Buffers     3942645760 bytes

Redo Buffers            8884224 bytes

Database mounted. - 查询控制文件中记录的数据文件的检查点信息以及END SCN信息
SQL> select file#,checkpoint_change#,last_change# from v$datafile;

     FILE# CHECKPOINT_CHANGE# LAST_CHANGE#

---------- ------------------ ------------

     1          1627660

     2          1627660

     3          1627660

     4          1627660
LAST_CHANGE#为NULL,异常关闭
- 打开数据库
参考资料
https://blog.csdn.net/liaocongyuan1314/article/details/50847529
总结:只有current和active状态的redo日志丢失或损坏,且数据库异常关闭,如kill或者abort,才会丢失数据!其他都可以进行恢复。
oracle利用redo恢复的更多相关文章
- ORACLE 利用SCN恢复误delete的表
--kg是误删除的表 SQL> select count(*) from kg; COUNT(*) ---------- 820861 SQL> delete from kg; ...
- 【转】ORACLE的REDO与UNDO
一.什么是redo?redo:oracle在在线或者归档重做日志文件中的记录的信息,外以出现失败时可以利用这些数据来"重放"事务.每个oracle数据都至少有二个在线重做日志组,每 ...
- oracle 利用flashback将备库激活为read wirte(10g 及上)
oracle 利用flashback将备库激活为read wirte(10g 及上) 环境: OS: CENTOS 6.5 X64 DB: ORACLE 10.2.0.5 主库操作: SQL> ...
- 利用RMAN恢复整个数据库
利用RMAN恢复整个数据库案例一 适合场合:恢复的目录一致,同时备份的过程中有归档日志 恢复的数据库目录和down机的数据库一致,还有一个就是RMAN备份的时候已经备份了归档日志. 备份脚本: run ...
- rman恢复方案和oracle异机恢复
这篇文章主要介绍了rman恢复方案和oracle异机恢复,需要的朋友可以参考下 注:①恢复的前提是已经做好备份②完全恢复数据库是数据库遇到故障,在恢复时候没有丢失任何已经提交事物数据的恢复不完全恢复数 ...
- oracle 11g 数据库恢复技术 ---01 重做日志
一 redo log Oracle数据库中的三大核心文件分别是数据文件(data file).重做日志(redo log)和控制文件(control file).数据文件保证了数据库的持久性,是保存修 ...
- Oracle的实例恢复解析
在数据库服务器异常断电重启后,数据库会进行实例恢复,那么实例恢复的过程中Oracle做了什么操作呢?参考官网在这里做一下解释,菜鸟水平有限,欢迎勘正. 首先说下实例恢复的定义: Instance re ...
- 删除Oracle Online Redo 测试
删除Oracle Online Redo 测试 SQL> select * from v$log; GROUP# THREAD# SEQUENCE# BYTES BLOCKS ...
- 11g RAC 如何备份OCR,利用备份恢复OCR,ocrdump
OCR备份 OCR的备份有2种方式,自动备份和手工备份. 自动备份策略: Oracle Clusterware 每隔4小时,CRSD 进程会自动对OCR 进行一次备份,在任意时刻,oracle 总会保 ...
随机推荐
- (二)Basic Concepts 基本概念
Basic Concepts There are a few concepts that are core to Elasticsearch. Understanding these concepts ...
- 如何使用 IDEA 创建项目并且上传到 GitHub
在 GitHub中 注册创建账号 :https://github.com 下载安装 Git : https://git-scm.com 安装成功后打开 Git Bash,输入下列命令,设置 Git 全 ...
- 基于aws api gateway的asp.net core验证
本文是介绍aws 作为api gateway,用asp.net core用web应用,.net core作为aws lambda function. api gateway和asp.net core的 ...
- Redis入门之增删改查等常用命令总结
Redis是用C语言实现的,一般来说C语言实现的程序"距离"操作系统更近,执行速度相对会更快. Redis使用了单线程架构,预防了多线程可能产生的竞争问题. 作者对于Redis源代 ...
- C#调用Delphi DLL获取字符串(C# IntPtr 与 string互转 )
前因后果 调用一门锁的dll实现读取酒店IC卡数据,直接用Readme里的方法出错. 函数声明: 一.读卡函数 ************************ Delphi 调用 ****** ...
- OSGI嵌入tomcat应用服务器(gem-web)——tomcat插件环境搭建
相关的资源下载,参考:https://www.cnblogs.com/dyh004/p/10642769.html 新建普通的plugin工程 新建工程运行环境 在工程中,新建运行环境 新建存放运行环 ...
- PHP实现微信企业付款
一.封装微信企业付款类WeiXinPayToUser,如下图代码所示: class WeixinPayToUser { /** * API 参数 * @var array * 'mch_appid' ...
- mybatis 使用resultMap实现表间关联
AutoMapping auto mapping,直译过来就是自动映射,工作原理大概如下: 假设我们有一张表,表名为person,包含id,name,age,addr这4个字段 mysql> d ...
- BeanShell用法汇总(部分摘抄至网络)
说明:本文部分资料摘抄至 来源: http://www.cnblogs.com/puresoul/p/4915350.html 来源: http://www.cnblogs.com/puresoul/ ...
- Lodop条形码竖条和值右端不对齐的解决方法
当Lodop条形码设置的宽度比较短,数值比较多的时候,会出现条码的竖条和右端不对齐.个人测试了一下,发现解决办法有三种:1.增加条形码的宽度.2.隐藏条码本身的值,用text文本代替.3.修改条形码下 ...