
hadoop项目实战--ETL--(三)实现mysql表到HIVE表的全量导入与增量导入
一 在HIVE中创建ETL数据库
->create database etl;
二 在工程目录下新建MysqlToHive.py 和conf文件夹
在conf文件夹下新建如下文件,最后的工程目录如下图
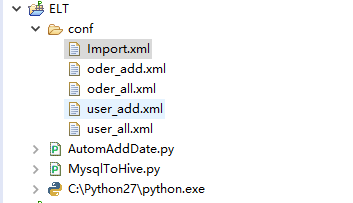
三 源码
Import.xml
<?xml version="1.0" encoding="UTF-8"?>

<root>

	<importtype>

		<value>add</value>    <!-- 增量导入或者全导入 -->

	</importtype>

	<task type="all">

		<table>user_all</table> <!-- 数据库中需要增量导入的第一张表名 -->

		<table>oder_all</table> <!-- 数据库中需要增量导入的第一张表名 -->

	</task>

	<task type="add">

		<table>user_add</table> <!-- 数据库中需要增量导入的第一张表名 -->

		<table>oder_add</table> <!-- 数据库中需要增量导入的第一张表名 -->

	</task>

</root>
oder_add.xml
<?xml version="1.0" encoding="UTF-8"?>

<root>

	<sqoop-shell type="import">

		<param key="connect">jdbc:mysql://192.168.0.154:3306/db_etl</param> <!-- 数据库连接地址 -->

		<param key="username">root</param> <!-- 数据库用户名 -->

		<param key="password">123456</param> <!-- 数据库密码 -->

		<param key="table">oderinfo</param><!-- 数据库中待导出的表名 -->

		<param key="hive-database">etl</param> <!-- 指定导入到HIVE的哪个数据库中 -->

		<param key="hive-partition-key">dt</param>   <!-- 通过时间分区 -->

		<param key="hive-partition-value">$dt</param>

		<param key="hive-import"></param>

		<param key="check-column">crt_time</param> <!-- 增量导入检查的列 -->

		<param key="incremental">lastmodified</param> <!-- 按照时间簇来进行增量导入 -->

		<param key="last-value">23:59:59</param> <!-- 增量导入时间划分点 -->

		<param key="num-mappers">1</param>   <!-- 使用map任务个数 -->

		<param key="split-by">id</param> <!-- 将表按照id水平切分交给map处理  -->

	</sqoop-shell>

</root>
oder_all.xml
<?xml version="1.0" encoding="UTF-8"?>

<root>

	<sqoop-shell type="import">

		<param key="connect">jdbc:mysql://192.168.0.154:3306/db_etl</param>   <!-- 数据库连接地址 -->

		<param key="username">root</param><!-- 数据库用户名 -->

		<param key="password">123456</param><!-- 数据库密码 -->

		<param key="table">oderinfo</param><!-- 数据库中待导出的表名 -->

		<param key="hive-database">etl</param> <!-- 指定导入到HIVE的哪个数据库中 -->

		<param key="hive-partition-key">dt</param>   <!-- 通过时间分区 -->

		<param key="hive-partition-value">$dt</param>

		<param key="hive-import"></param>

		<param key="create-hive-table"></param>   <!-- 在hive中新建一张同名同结构的表 -->

		<param key="hive-overwrite"></param> <!-- 覆盖原来以存在的表 -->

		<param key="num-mappers">1</param>   <!-- 使用map任务个数 -->

		<param key="split-by">id</param> <!-- 将表按照id水平切分交给map处理  -->

	</sqoop-shell>

</root>
user_add.xml
<?xml version="1.0" encoding="UTF-8"?>

<root>

	<sqoop-shell type="import">

		<param key="connect">jdbc:mysql://192.168.0.154:3306/db_etl</param> <!-- 数据库连接地址 -->

		<param key="username">root</param> <!-- 数据库用户名 -->

		<param key="password">123456</param> <!-- 数据库密码 -->

		<param key="table">userinfo</param><!-- 数据库中待导出的表名 -->

		<param key="hive-database">etl</param> <!-- 指定导入到HIVE的哪个数据库中 -->

		<param key="hive-partition-key">dt</param>   <!-- 通过时间分区 -->

		<param key="hive-partition-value">$dt</param>

		<param key="hive-import"></param>

		<param key="check-column">crt_time</param> <!-- 增量导入检查的列 -->

		<param key="incremental">lastmodified</param> <!-- 按照时间簇来进行增量导入 -->

		<param key="last-value">23:59:59</param> <!-- 增量导入时间划分点 -->

		<param key="num-mappers">1</param>   <!-- 使用map任务个数 -->

		<param key="split-by">id</param> <!-- 将表按照id水平切分交给map处理  -->

	</sqoop-shell>

</root>
user_all.xml
<?xml version="1.0" encoding="UTF-8"?>

<root>

	<sqoop-shell type="import">

		<param key="connect">jdbc:mysql://192.168.0.154:3306/db_etl</param>   <!-- 数据库连接地址 -->

		<param key="username">root</param><!-- 数据库用户名 -->

		<param key="password">123456</param><!-- 数据库密码 -->

		<param key="table">userinfo</param><!-- 数据库中待导出的表名 -->

		<param key="hive-database">etl</param> <!-- 指定导入到HIVE的哪个数据库中 -->

		<param key="hive-partition-key">dt</param>   <!-- 通过时间分区 -->

		<param key="hive-partition-value">$dt</param>

		<param key="hive-import"></param>

		<param key="create-hive-table"></param>   <!-- 在hive中新建一张同名同结构的表 -->

		<param key="hive-overwrite"></param> <!-- 覆盖原来以存在的表 -->

		<param key="num-mappers">1</param>   <!-- 使用map任务个数 -->

		<param key="split-by">id</param> <!-- 将表按照id水平切分交给map处理  -->

	</sqoop-shell>

</root>
MysqlToHive.py
# _*_ coding:UTF-8 _*_

'''

Created on 2016��12��1��

@author: duking

'''

import datetime

import os

import xml.etree.ElementTree as ET

import collections

#获取昨天时间

def getYesterday():

    today=datetime.date.today()

    oneday=datetime.timedelta(days=1)

    yesterday=today-oneday

    return yesterday

def Resolve_Conf(dt):

    #获取当前工程目录

    PROJECT_DIR = os.getcwd()

    #获得配置文件名

    conf_file = PROJECT_DIR + "\conf\Import.xml"

    #解析配置文件

    xml_tree = ET.parse(conf_file)

    #提取出本次导入的类型  全导入或者增量导入  通过配置import.xml中的plan标签的value值设定

    import_types = xml_tree.findall('./importtype')

    for import_type in import_types:

        aim_types = import_type.findall('./value')

        for i in range(len(aim_types)):

            aim_type = aim_types[i].text

    #获得task元素

    tasks = xml_tree.findall('./task')

    #用来保存待执行的sqoop命令的集合

    cmds = []

    for task in tasks:

        #获得导入类型,增量导入或者全量导入

        import_type = task.attrib["type"]

        #如果task的标签导入类型与设定类型不同,结束本次循环

        if(import_type != aim_type):

            continue

        #获得表名集合

        tables = task.findall('./table')

        #迭代表名集合,解析表配置文件

        for i in range(len(tables)):

            #表名

            table_name = tables[i].text

            #表配置文件名

            table_conf_file = PROJECT_DIR + "\conf\\" + table_name + ".xml"

            #解析表配置文件

            xmlTree = ET.parse(table_conf_file)

            #获取sqoop-shell 节点

            sqoopNodes = xmlTree.findall("./sqoop-shell")

            #获取sqoop 命令类型

            sqoop_cmd_type = sqoopNodes[0].attrib["type"]

            #首先组装成sqoop命令头

            command = "sqoop " + sqoop_cmd_type

            #获取

            praNodes = sqoopNodes[0].findall("./param")

            #用来保存param的信息的有序字典

            cmap = collections.OrderedDict()

            #将所有param中的key-value存入字典中

            for i in range(len(praNodes)):

                #获取key的属性值

                key = praNodes[i].attrib["key"]

                #获取param标签中的值

                value = praNodes[i].text

                #保存到字典中

                cmap[key] = value

            #迭代字典将param的信息拼装成字符串

            for key in cmap:

                value = cmap[key]

                #如果不是键值对形式的命令 或者值为空,跳出此次循环

                if(value == None or value == "" or value == " "):

                    value = ""

                if(key == "hive-partition-value"):

                    value = value.replace('$dt',str(dt))

                #合成前一天的时间

                if(key == "last-value"):

                    value = '"' + str(dt) + " " + value + '"'

                #拼装为命令

                command += " --" + key + " " + value + " "

            #将命令加入至待执行的命令集合

            cmds.append(command)

    return cmds

#python 模块的入口:main函数

if __name__ == '__main__':

    dt = getYesterday();

    #解析配置文件,生成相应的HQL语句

    cmds = Resolve_Conf(dt)

    #迭代集合,执行命令

    for i in range(len(cmds)):

        cmd = cmds[i]

        print cmd

        #执行导入过秤

        os.system(cmd)
hadoop项目实战--ETL--(三)实现mysql表到HIVE表的全量导入与增量导入的更多相关文章
- MySQL数据库企业集群项目实战(阶段三)
MySQL数据库企业集群项目实战(阶段三) 作者 刘畅 时间 2020-10-25 目录 1 架构拓扑图 1 1.1 方案一 1 1.2 方案二 2 ...
- Hadoop项目实战-用户行为分析之应用概述(三)
1.概述 本课程的视频教程地址:<项目工程准备> 本节给大家分享的主题如下图所示: 下面我开始为大家分享今天的第三节的内容——<项目工程准备>,接下来开始分享今天的内容. 2. ...
- Hadoop项目实战-用户行为分析之应用概述(二)
1.概述 本课程的视频教程地址:<项目整体概述> 本节给大家分享的主题如下图所示: 下面我开始为大家分享第二节的内容——<项目整体概述>,下面开始今天的分享内容. 2.内容 从 ...
- Selenium Web 自动化 - 项目实战(三)
Selenium Web 自动化 - 项目实战(三) 2016-08-10 目录 1 关键字驱动概述2 框架更改总览3 框架更改详解 3.1 解析新增页面目录 3.2 解析新增测试用例目录 3. ...
- Hadoop项目实战-用户行为分析之应用概述(一)
1.概述 本课程的视频教程地址:<Hadoop 回顾> 好的,下面就开始本篇教程的内容分享,本篇教程我为大家介绍我们要做一个什么样的Hadoop项目,并且对Hadoop项目的基本特点和其中 ...
- Vue2+VueRouter2+webpack 构建项目实战(三):配置路由,运行页面
制作.vue模板文件 通过前面的两篇博文的学习,我们已经建立好了一个项目.问题是,我们还没有开始制作页面.下面,我们要来做页面了. 我们还是利用 http://cnodejs.org/api 这里公开 ...
- (转载)Android项目实战(三十二):圆角对话框Dialog
Android项目实战(三十二):圆角对话框Dialog 前言: 项目中多处用到对话框,用系统对话框太难看,就自己写一个自定义对话框. 对话框包括:1.圆角 2.app图标 , 提示文本,关闭对话 ...
- mysql的全量备份与增量备份
mysql的全量备份与增量备份 全量备份:可以使用mysqldump直接备份整个库或者是备份其中某一个库或者一个库中的某个表. 备份所有数据库:[root@my ~]# mysqldump -uroo ...
- mysql全量备份与增量备份
mysql全量备份与增量备份 1.全量备份 全量备份就是把数据库中所有的数据进行备份. 备份所有库: mysqldump -uroot -p456 -S /data/3306/mysql.sock ...
随机推荐
- linux平台mysql密码设破解
1.先停止mysql服务 service mysqld stop 2.启动mysql服务 并跳过权限认证 mysqld_safe --skip-grant-tables 3.打开另外一个终端 登录my ...
- spring boot上传 下载图片。
https://blog.csdn.net/a625013/article/details/52414470 build.gradle buildscript { repositories { mav ...
- 使用 Mirantis Fuel9.0 部署 OpenStack M
Mirantis Fuel 9 可以实现部署OpenStack M版本web化,管理员只需简单规划就能部署复杂的openstack 组件 安装Fuel9.0 下载官方IOS镜像 https://www ...
- 第一篇 Python图片处理模块PIL(pillow)
本篇包含:一.Image类的属性:1.Format 2.Mode 3.Size 4.Palette 5.Info 二.类的函数:1.New ...
- Object-C-系统类型对象归档
系统类型主要是指NSString NSDictionary,NSArray,NSData,NSNumber 类型数据(包括对应可变类型); 这些类型已经实现了NSCoding协议,支持归档, 写入方法 ...
- AOAPC I: Beginning Algorithm Contests (Rujia Liu) Volume 6. Mathematical Concepts and Methods
uva 106 这题说的是 说计算 x^2 + y^2 = z^2 xyz 互质 然后计算个数和 在 N内 不在 勾股数之内的数的个数 然后去找需要的 维基百科上 看到 另 n*m*2 =b ...
- Python: str.split()和re.split()的区别
str.split() 单一分隔符,使用str.split()即可 str.split不支持正则及多个切割符号,不感知空格的数量 re.split() 多个分隔符,复杂的分隔情况,使用re.split ...
- Ubuntu系统下查看显卡相关信息
查看显卡信息 root@ubuntu:/home/ubuntu# lspci |grep -i vga 02:00.0 VGA compatible controller: NVIDIA Corpor ...
- 由于防火墙限制无法访问linux服务器上的tomcat应用
使用的是CentOS6.4系统. 问题重现: tomcat服务是启动的, 但无法访问服务器上的tomcat应用页面. 解决办法: 在防火墙配置中设置端口: 命令: # cd /etc/sysconfi ...
- WindowsServer-性能计数器
https://jingyan.baidu.com/article/59703552e764e48fc00740dd.html