
大数据笔记(二)——Apache Hadoop的体系结构
一.分布式存储
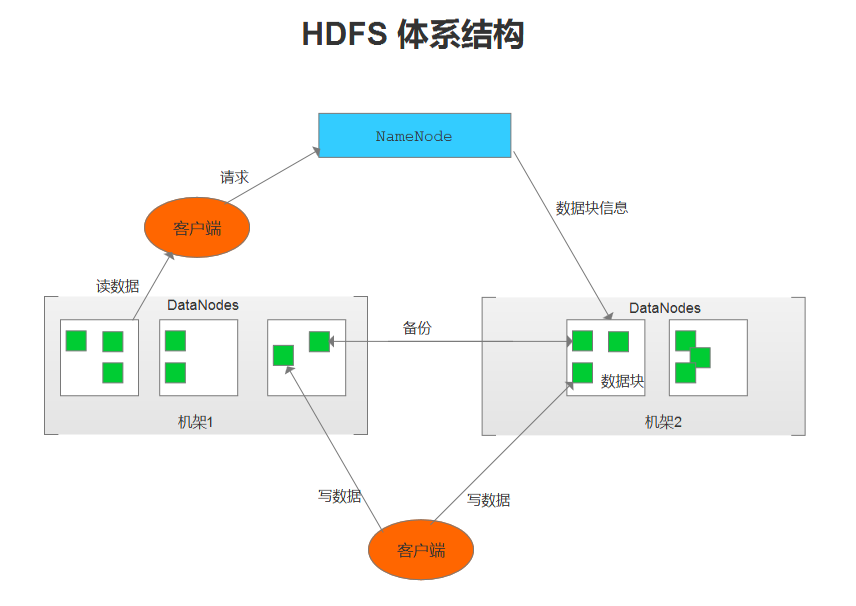
- NameNode(名称节点)
1.维护HDFS文件系统,是HDFS的主节点。
2.接收客户端的请求:上传、下载文件、创建目录等。
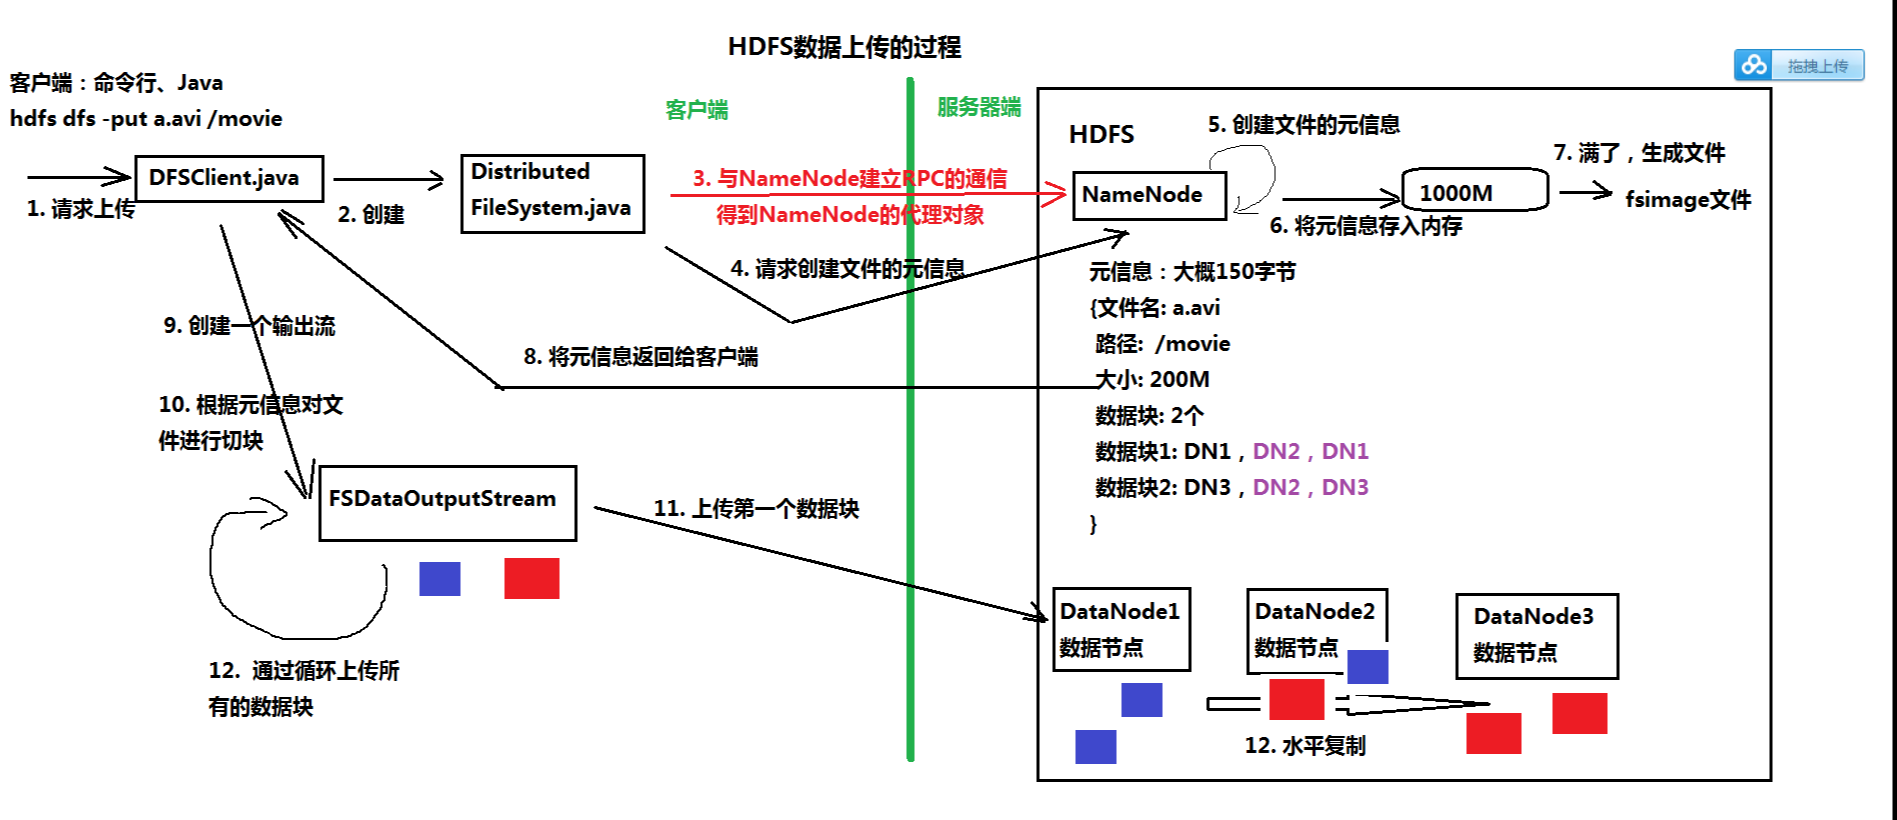
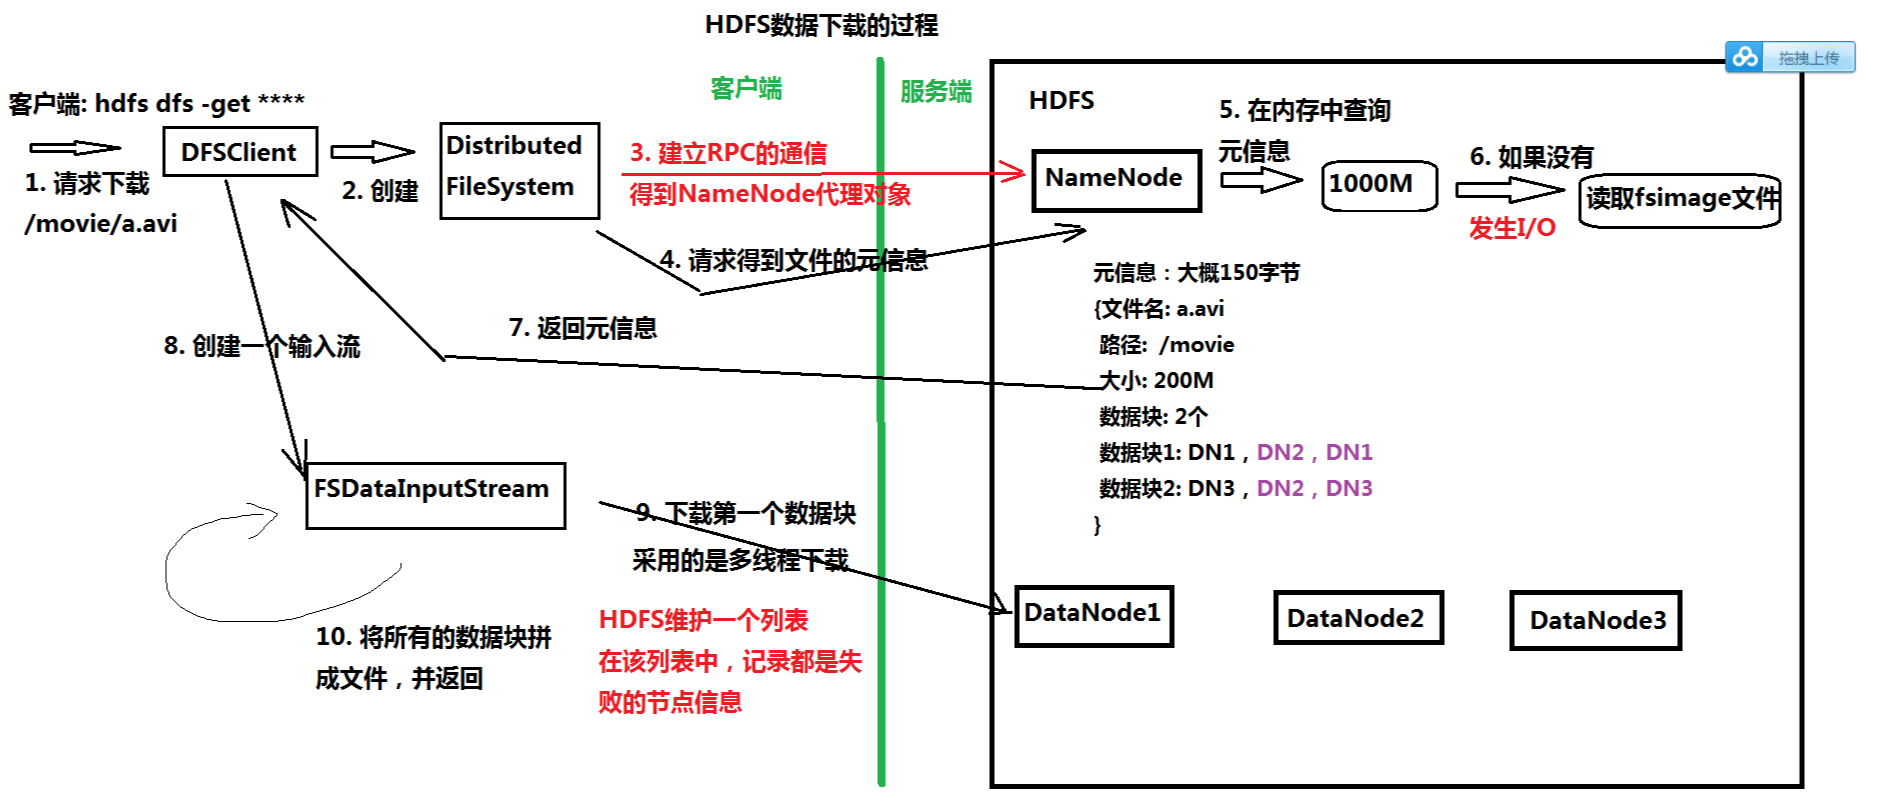
3.记录客户端操作的日志(edits文件),保存了HDFS最新的状态
1)Edits文件保存了自最后一次检查点之后所有针对HDFS文件系统的操作,比如:增加文件、重命名文件、删除目录等
2)保存目录:$HADOOP_HOME/tmp/dfs/name/current
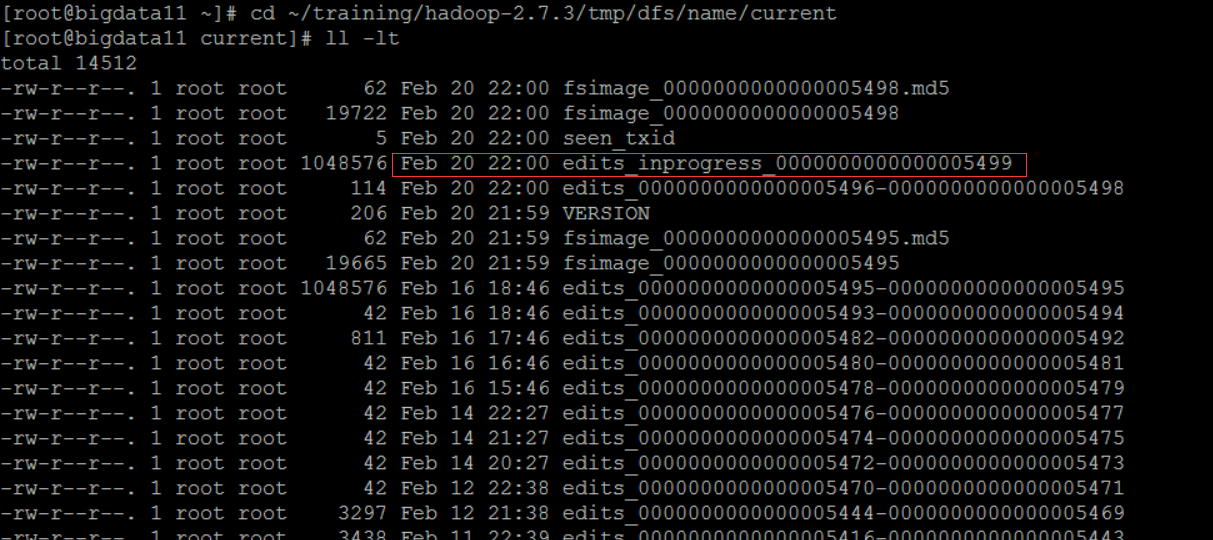
可以使用 hdfs oev -i 命令将日志(二进制)输出为 XML文件
hdfs oev -i edits_inprogress_0000000000000005499 -o ~/temp/log.xml
4.维护文件元信息,将内存中不常用的文件元信息保存在硬盘上(fsimage文件)
1)fsimage是HDFS文件系统存于硬盘中的元数据检查点,里面记录了自最后一次检查点之前HDFS文件系统中所有目录和文件的序列化信息
2)保存目录:edits
3)可以使用 hdfs oev -i 命令将日志(二进制)输出为 XML文件
- DataNode(数据节点)
1.以数据块为单位,保存数据
1)Hadoop1.0的数据块大小:64M
2)Hadoop2.0的数据库大小:128M
2.在全分布模式下,至少两个DataNode节点
3.数据保存的目录:由 hadoop.tmp.dir 参数指定
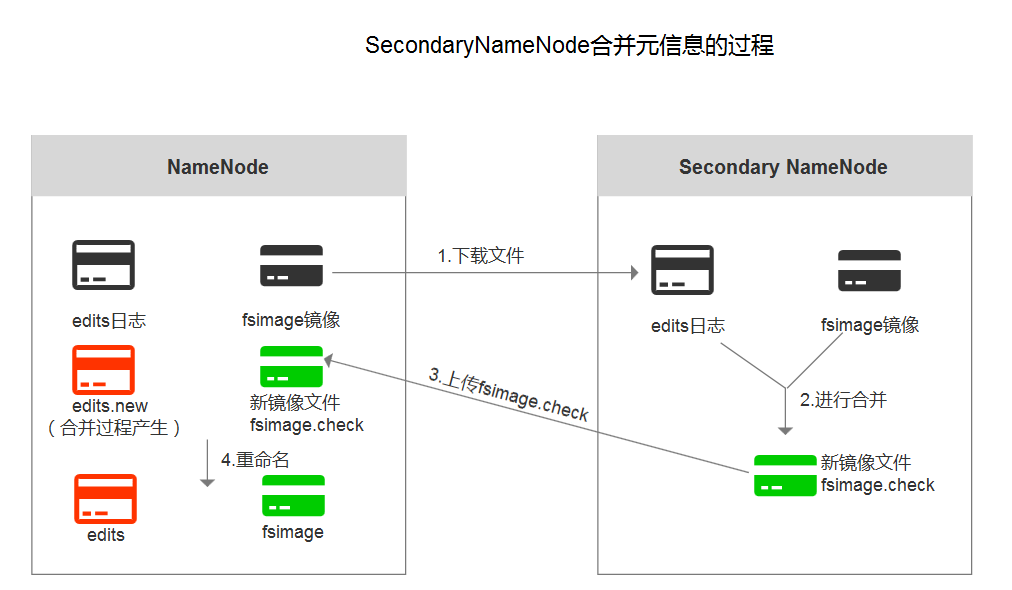
- Secondary NameNode(第二名称节点)
1.主要作用:合并日志
2.合并时机:HDFS发出检查点的时候
3.日志合并过程:
- HDFS存在的问题
1)NameNode单点故障问题
解决方案:Hadoop2.0中,使用Zookeeper实现NameNode的HA功能
2)NameNode压力过大,且内存受限,影响系统扩展性
解决方案:Hadoop2.0中,使用NameNode联盟实现水平扩展
二.YARN:分布式计算(MapReduce)
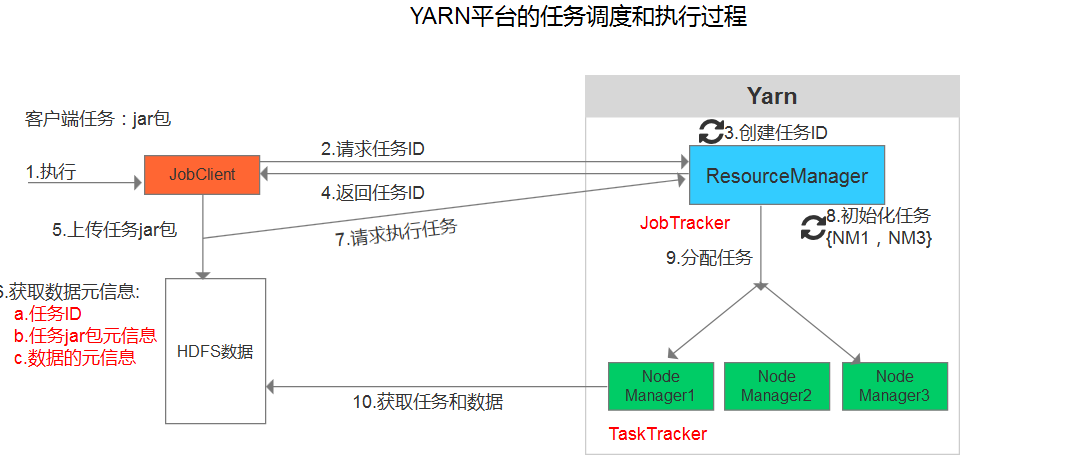
- ResourceManager(资源管理器)
1.接收客户端的请求,执行任务
2.分配资源
3.分配任务
- NodeManager(节点管理器:运行任务 MapReduce)
从 DataNode上获取数据,执行任务
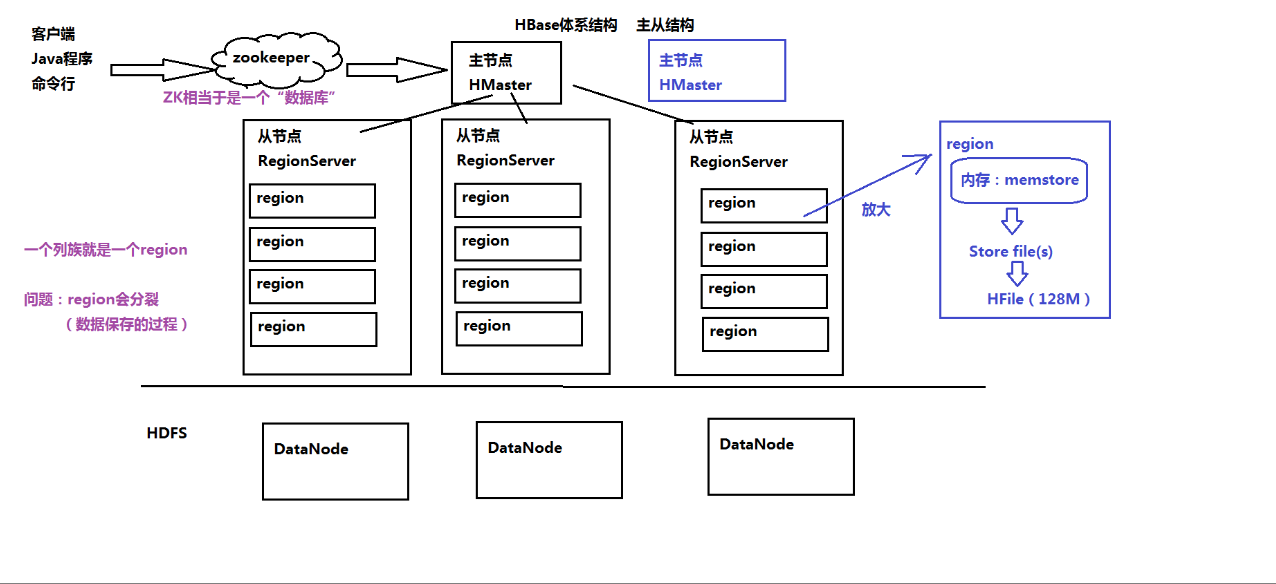
三.HBase的体系结构
大数据笔记(二)——Apache Hadoop的体系结构的更多相关文章
- 大数据笔记13:Hadoop安装之Hadoop的配置安装
1.准备Linux环境 1.0点击VMware快捷方式,右键打开文件所在位置 -> 双击vmnetcfg.exe -> VMnet1 host-only ->修改subnet ip ...
- 大数据软件安装之Hadoop(Apache)(数据存储及计算)
大数据软件安装之Hadoop(Apache)(数据存储及计算) 一.生产环境准备 1.修改主机名 vim /etc/sysconfig/network 2.修改静态ip vim /etc/udev/r ...
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- 玩转大数据系列之Apache Pig高级技能之函数编程(六)
原创不易,转载请务必注明,原创地址,谢谢配合! http://qindongliang.iteye.com/ Pig系列的学习文档,希望对大家有用,感谢关注散仙! Apache Pig的前世今生 Ap ...
- 大数据平台搭建(hadoop+spark)
大数据平台搭建(hadoop+spark) 一.基本信息 1. 服务器基本信息 主机名 ip地址 安装服务 spark-master 172.16.200.81 jdk.hadoop.spark.sc ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
- 大数据学习系列之六 ----- Hadoop+Spark环境搭建
引言 在上一篇中 大数据学习系列之五 ----- Hive整合HBase图文详解 : http://www.panchengming.com/2017/12/18/pancm62/ 中使用Hive整合 ...
- 阿里巴巴飞天大数据架构体系与Hadoop生态系统
很多人问阿里的飞天大数据平台.云梯2.MaxCompute.实时计算到底是什么,和自建Hadoop平台有什么区别. 先说Hadoop 什么是Hadoop? Hadoop是一个开源.高可靠.可扩展的分布 ...
- 决战大数据之二:CentOS 7 最新JDK 8安装
决战大数据之二:CentOS 7 最新JDK 8安装 [TOC] 修改hostname # hostnamectl set-hostname node1 --static # reboot now 重 ...
- 大数据实时计算工程师/Hadoop工程师/数据分析师职业路线图
http://edu.51cto.com/roadmap/view/id-29.html http://my.oschina.net/infiniteSpace/blog/308401 大数据实时计算 ...
随机推荐
- SpringBoot 使用JPA+MySQL+Thymeleaf 总结 二
SpringBoot 使用JPA+MySQL+Thymeleaf 总结 一 SpringBoot 使用JPA+MySQL+Thymeleaf 总结 二 方法一 使用原生sql查询 或者 为方法名增加 ...
- [LeetCode] 154. 寻找旋转排序数组中的最小值 II
题目链接 : https://leetcode-cn.com/problems/find-minimum-in-rotated-sorted-array-ii/ 题目描述: 假设按照升序排序的数组在预 ...
- Scrapy 教程(八)-分布式爬虫
scrapy 本身并不是一个分布式框架,而 Scrapy-redis 库使得分布式成为可能: Scrapy-redis 并没有重构框架,而是基于redis数据库重写了框架的某些组件. 分布式框架要解决 ...
- 常用的 Python 标准库都有哪些?
标准库:os 操作系统,time 时间,random 随机,pymysql 连接数据库,threading 线程,multiprocessing进程,queue 队列. 第三方库:django 和 f ...
- c# WPF SVG 文件的引用(SharpVectors)
原文:c# WPF SVG 文件的引用(SharpVectors) 阿里巴巴矢量图标库提供了大量的 SVG 图标:https://www.iconfont.cn/ 但是 WPF 本身不支持 SVG 格 ...
- 移动前端不得不了解的Meta标签
http://ghmagical.com/article/page/id/PSeJR0rPd34k
- webpack面试题(转载)
1:webpack打包原理 把所有依赖打包成一个bundle.js文件,通过代码分割成单元片段并按需加载. 2:webpack的优势 (1) webpack是以commonJS的形式来书写 ...
- ssm中web配置各框架的配置文件路径方式
一.在web文件中配置 使用逗号隔开 二.在applicationContext.xml文件中配置或引用 以下是引用方式 注: <import />标签要放在所有bean配置的最前面.
- docker配置Nginx
创建及进入docker容器$docker run -p 80 --name web01 -i -t ubuntu /bin/bash 创建html文件夹$mkdir -p /var/www/html ...
- MTK6261之检测是否插了T卡
T卡的更目录可用SRV_FMGR_CARD_DRV 其宏定义如下: #define SRV_FMGR_CARD_DRV FS_GetDrive(FS_DRIVE_V_REMOVABLE, 1, FS_ ...