
Linux基于Hadoop2.8.0集群安装配置Hive2.1.1及基础操作
前言
安装Apache Hive前提是要先安装hadoop集群,并且hive只需要在hadoop的namenode节点集群里安装即可,安装前需保证Hadoop已启(动文中用到了hadoop的hdfs命令)。
关于如何安装Hadoop集群请参照:CentOS7搭建Hadoop2.8.0集群及基础操作与测试
下载Apache Hadoop
下载
地址:http://hive.apache.org/downloads.html
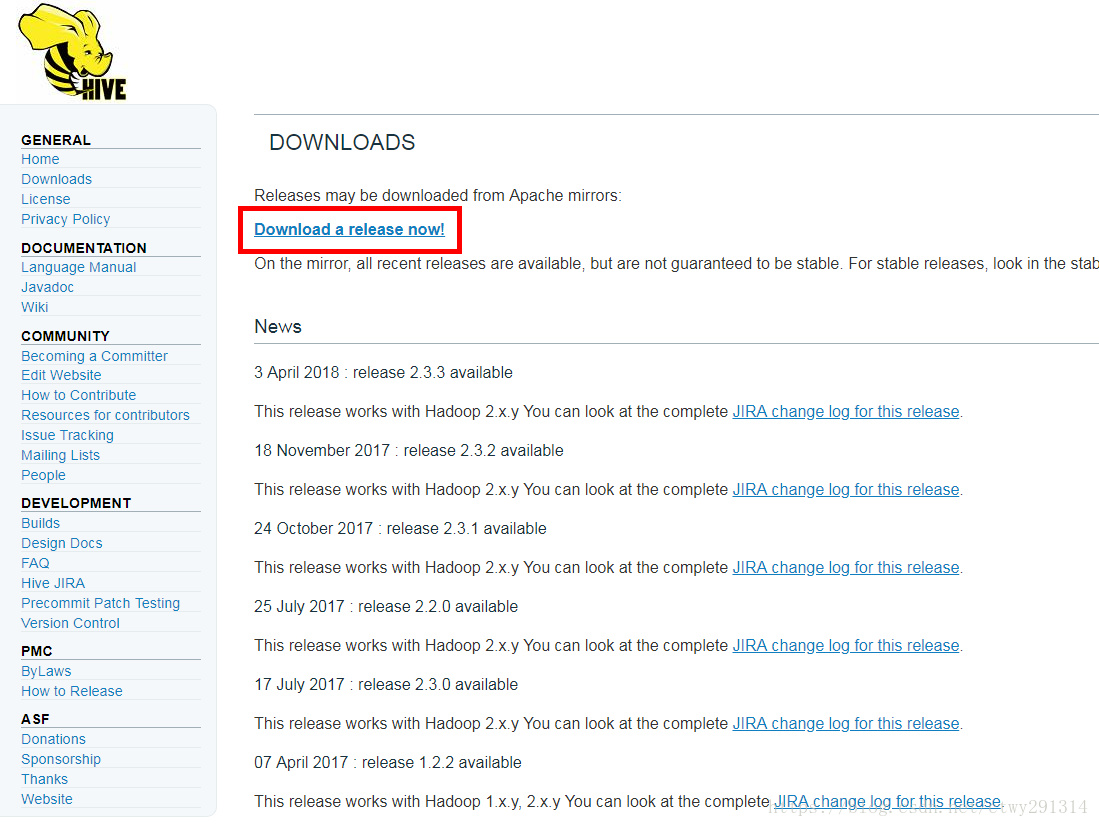
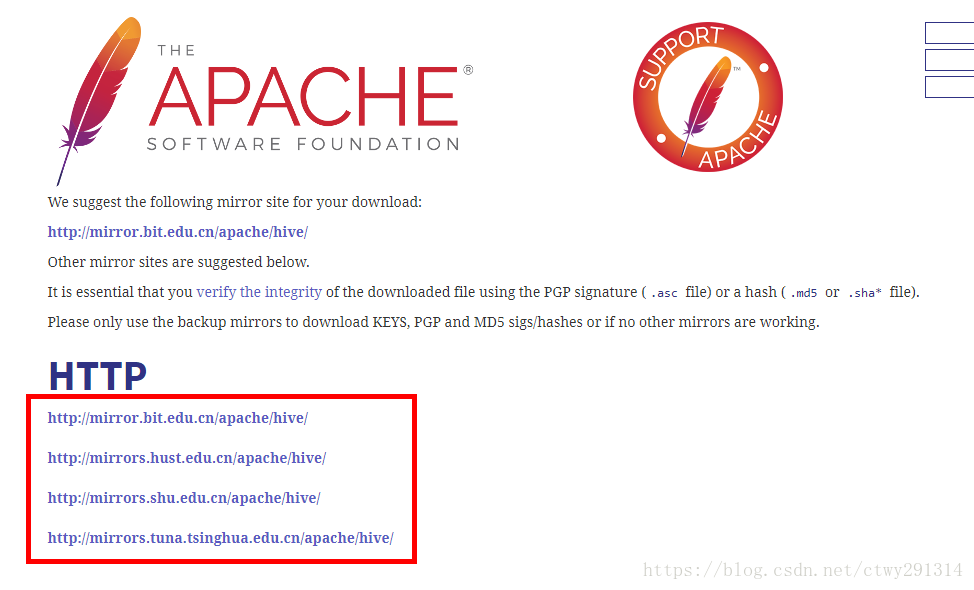
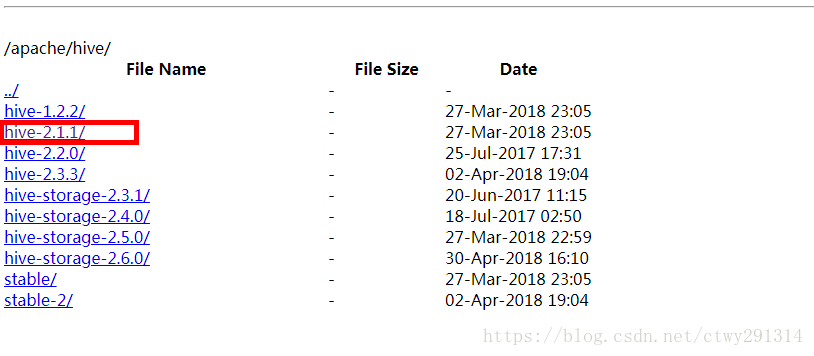
wget http://mirrors.hust.edu.cn/apache/hive/hive-2.1.1/apache-hive-2.1.1-bin.tar.gz解压
tar -zxvf apache-hive-2.1.1-bin.tar.gz移动文件夹
mv apache-hive-2.1.1-bin /usr/local/hadoop/配置环境变量
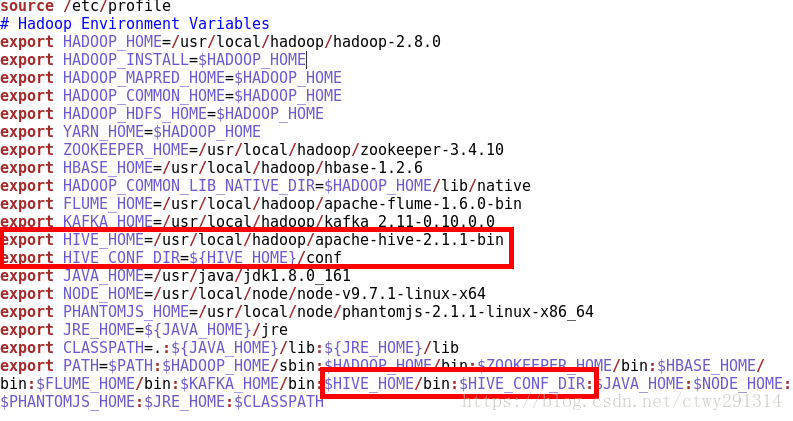
立即生效
source ~/.bashrc修改配置
配置hive-site.xml
进入目录$HIVE_HOME/conf,将hive-default.xml.template文件复制一份并改名为hive-site.xml
#进入hive配置文件目录$HIVE_HOME/conf

cd $HIVE_HOME/conf

#拷贝并重命名

cp hive-default.xml.template hive-site.xml
因为
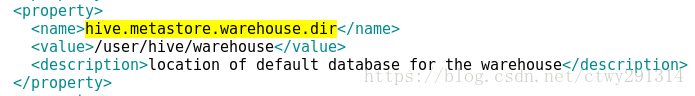
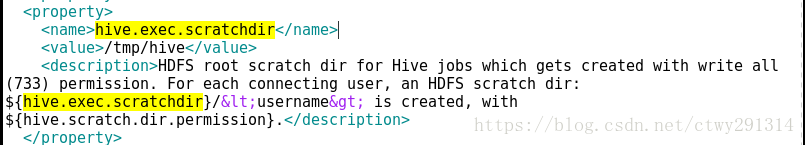
所以要让hadoop新建/user/hive/warehouse目录,执行命令:
$HADOOP_HOME/bin/hadoop fs -mkdir -p /user/hive/warehouse给刚才新建的目录赋予读写权限,执行命令:
$HADOOP_HOME/bin/hadoop fs -chmod 777 /user/hive/warehouse 让hadoop新建/tmp/hive/目录,执行命令:
$HADOOP_HOME/bin/hadoop fs -mkdir -p /tmp/hive/给刚才新建的目录赋予读写权限,执行命令:
$HADOOP_HOME/bin/hadoop fs -chmod 777 /tmp/hive检查hdfs目录是否创建成功
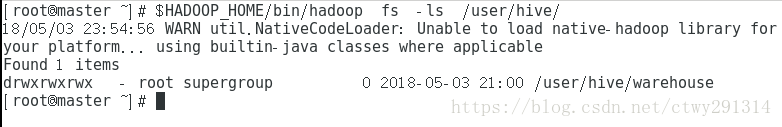
检查/user/hive/warehouse目录是否创建成功,执行命令:
$HADOOP_HOME/bin/hadoop fs -ls /user/hive/如图:
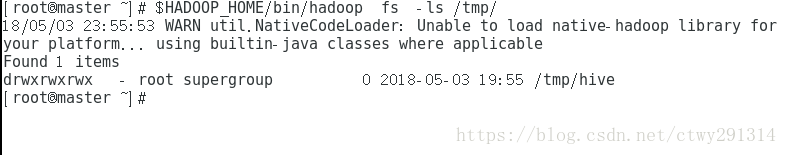
检查/tmp/hive是否创建成功,执行命令:
$HADOOP_HOME/bin/hadoop fs -ls /tmp/如图:
修改hive-site.xml中的临时目录
将hive-site.xml文件中的${system:java.io.tmpdir}替换为hive的临时目录,例如我替换为 /usr/local/hadoop/apache-hive-2.1.1-bin/tmp,该目录如果不存在则要自己手工创建,并且赋予读写权限。
如图:
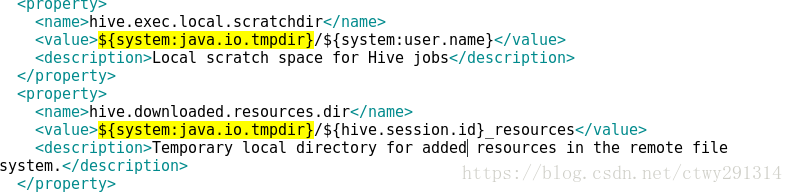
替换为
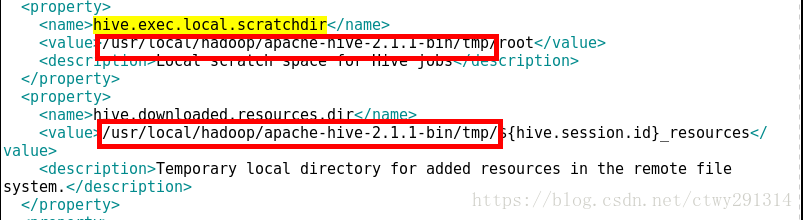
将${system:user.name}都替换为root
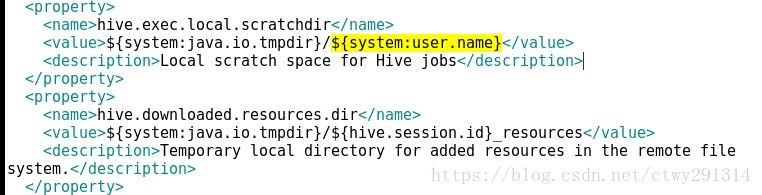
替换为
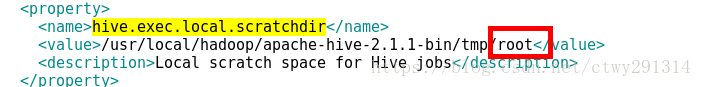
切记要全部替换,以上只为示例。
修改hive-site.xml数据库相关的配置
本文使用postgres数据库,如需了解请参照Linux安装postgresql及基础操作
搜索javax.jdo.option.ConnectionURL,将该name对应的value修改为Postgres的地址,例如我修改后是:

     <name>javax.jdo.option.ConnectionURL</name>

     <value>jdbc:postgresql://192.168.174.200:5432/postgres?charSet=utf-8</value>

搜索javax.jdo.option.ConnectionDriverName,将该name对应的value修改为MySQL驱动类路径,例如我的修改后是:

	<name>javax.jdo.option.ConnectionDriverName</name>

    <value>org.postgresql.Driver</value>

搜索javax.jdo.option.ConnectionUserName,将对应的value修改为MySQL数据库登录名:

    <name>javax.jdo.option.ConnectionUserName</name>

    <value>postgre</value>

搜索javax.jdo.option.ConnectionPassword,将对应的value修改为MySQL数据库的登录密码:

     <name>javax.jdo.option.ConnectionPassword</name>

     <value>postgre</value>

搜索hive.metastore.schema.verification,将对应的value修改为false:

    <name>hive.metastore.schema.verification</name>

    <value>false</value>
上传postgres驱动包到lib目录
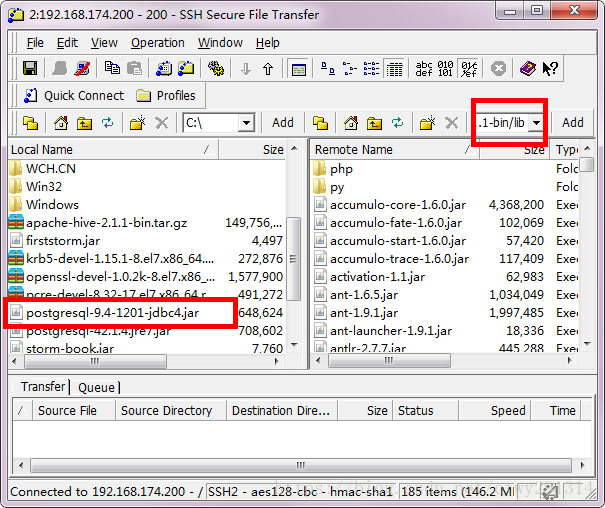
将postgres驱动包上载到Hive的lib目录下,例如我是上载到/usr/local/hadoop/apache-hive-2.1.1-bin/lib目录下。
新建hive-env.sh文件并进行修改
进入到/opt/hive/apache-hive-2.1.1-bin/conf目录,命令:
cd /opt/hive/apache-hive-2.1.1-bin/conf
将hive-env.sh.template文件复制一份,并且改名为hive-env.sh,命令:
cp hive-env.sh.template hive-env.sh打开hive-env.sh配置并且添加以下内容:
vim hive-env.sh

export  HADOOP_HOME=/usr/local/hadoop/hadoop-2.8.0

export  HIVE_CONF_DIR=/usr/local/hadoop/apache-hive-2.1.1-bin/conf

export  HIVE_AUX_JARS_PATH=/usr/local/hadoop/apache-hive-2.1.1-bin/lib
启动与测试
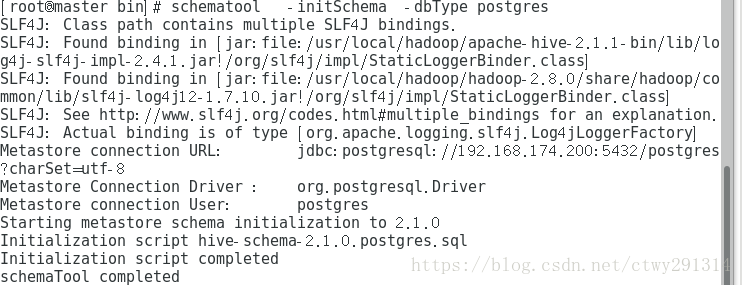
对postgres数据库进行初始化
进入到hive的bin目录 执行命令:
cd /usr/local/hadoop/apache-hive-2.1.1-bin/bin对数据库进行初始化,执行命令:
schematool -initSchema -dbType postgres如图:
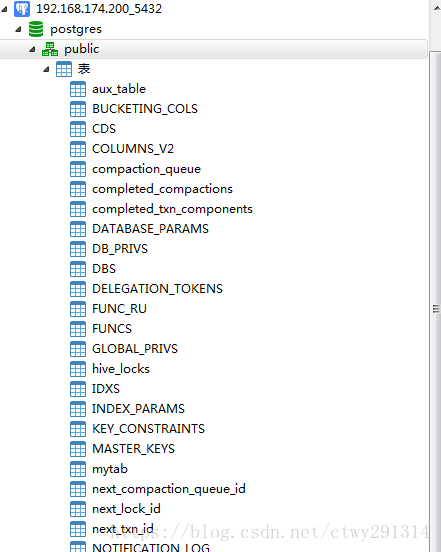
执行成功后,hive数据库里已经有一堆表创建好了
如图:
启动hive
进入到hive的bin目录执行命令:
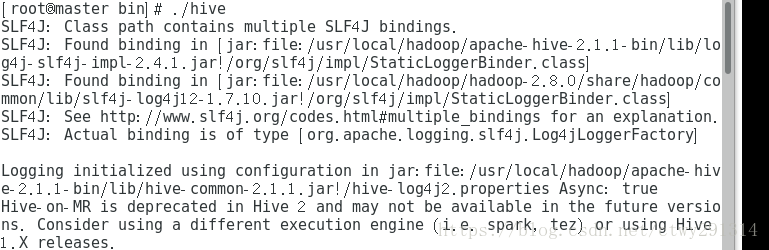
cd /usr/local/hadoop/apache-hive-2.1.1-bin/bin执行hive脚本进行启动,执行命令:
./hive如图:
以上Hive配置完成
Linux基于Hadoop2.8.0集群安装配置Hive2.1.1及基础操作的更多相关文章
- CentOS下Hadoop-2.2.0集群安装配置
对于一个刚开始学习Spark的人来说,当然首先需要把环境搭建好,再跑几个例子,目前比较流行的部署是Spark On Yarn,作为新手,我觉得有必要走一遍Hadoop的集群安装配置,而不仅仅停留在本地 ...
- Linux下Hadoop2.6.0集群环境的搭建
本文旨在提供最基本的,可以用于在生产环境进行Hadoop.HDFS分布式环境的搭建,对自己是个总结和整理,也能方便新人学习使用. 基础环境 JDK的安装与配置 现在直接到Oracle官网(http:/ ...
- hadoop2.20.0集群安装教程
一.安装的需要软件及集群描述 1.软件: Vmware9.0:虚拟机 Hadoop2.2.0:Apache官网原版稳定版本 JDK1.7.0_07:Oracle官网版本 Ubuntu12.04LTS: ...
- hadoop2.2.0集群安装和配置
hadoop2.0已经发布了稳定版本了,增加了很多特性,比如HDFS HA.YARN等. 注意:apache提供的hadoop-2.2.0的安装包是在32位操作系统编译的,因为hadoop依赖一些C+ ...
- hadoop2.2.0集群安装
位说明. 位).Jdk使用的1.7(1.6也可以).网络配置好,相互可以ping通,java环境安装完毕. 第一部分 Hadoop 2.2 下载 位). 下载地址:http://apache.cl ...
- 最新版spark1.1.0集群安装配置
和分布式文件系统和NoSQL数据库相比而言,spark集群的安装配置还算是比较简单的: 很多教程提到要安装java和scala,但我发现spark最新版本是包含scala的,JRE采用linux内嵌的 ...
- Ubuntu 14.04下Hadoop2.4.1集群安装配置教程
一.环境 系统: Ubuntu 14.04 64bit Hadoop版本: hadoop 2.4.1 (stable) JDK版本: OpenJDK 7 台作为Master,另3台作为Slave. 所 ...
- linux 搭建elk6.8.0集群并破解安装x-pack
一.环境信息以及安装前准备 1.组件介绍 *Filebeat是一个日志文件托运工具,在你的服务器上安装客户端后,filebeat会监控日志目录或者指定的日志文件,追踪读取这些文件(追踪文件的变化,不停 ...
- Ubuntu12.04-x64编译Hadoop2.2.0和安装Hadoop2.2.0集群
本文Blog地址:http://www.cnblogs.com/fesh/p/3766656.html 本文对Hadoop-2.2.0源码进行重新编译(64位操作系统下不重新编译会有版本问题) ...
随机推荐
- easyui 无限级数tree[menulist1 = GetMenuList(sm2,menulist1);]
// 左侧导航加载 function addNav(data) { $.each(data,function(i, sm1) { var menulist1 = "<ul id='tt ...
- 软件安装——彻底卸载MySQL
如果你的电脑里装过MySQL,想再重新安装MySQL的时候可能就会因为前一版本卸载不彻底而出现错误.最常见的就是安装好后设置参数的最后一步验证时,会在Execute configurattion步骤中 ...
- 在CentOS7中配置网络时常见的LSB加载失败问题
前几天,为了给OpenNebula扩展新的主机节点,对CentOS7的网络进行了配置.本以为网络配置只需要简单修改ifcfg-eth0即可,但是在重启网络服务时却遇到了一个LSB加载失败的问题(Fai ...
- 【转】i18n实现前端国际化(实例)
源地址:https://www.jianshu.com/p/ea93efef5155 i18n实现前端国际化(实例) 0.1442018.08.27 16:25:10字数 246阅读 10563 在今 ...
- C/C++中动态内存分配
代码段:用来存放程序执行代码的一块内存区域.这部分内存大小在程序运行前已经知道,通常属于只读,其中包括只读的字符串常量,不可改变 BBS段:用来存放存放程序中未初始化的全局变量及静态变量,属于静态内存 ...
- 高级软件测试技术(测试管理工具实践day2)
今天在紧张的学习之余,我们小组选定了bugzilla,并且打算在今天晚上刚进行下载安装. 在安装bugzilla需要的软件有MySQL数据库软件,activeperl软件,bugzilla安装包,II ...
- Maps.newHashMap 和 new HashMap的区别
区别: (1)Map<String, Object> result = new HashMap<String,Object>(); 这种是java原生API写法,需要你手动加泛 ...
- 分类汇总统计mysql数据库一个字段中不同的记录的总和
方法1.用 if 语句,如下例. 方法2.用case when then else 语句,用法如同if. mysql> select sum(if(id<500,1,0)),sum(if( ...
- edusoho 支持同一账号多人同时登录
文件: ./src/Topxia/WebBundle/Listener/UserLoginTokenListener.php 函数: public function onGetUserLoginLis ...
- 数位dp好题整理+自己wa过的细节记录
花(fa)神的数论题 三倍经验:烦人的数学作业 windy数 手机号码 同类分布(博客先鸽着) 板子固然好,细节无限多. 花式wa题法,警示后来人. 1.手残害人不浅 (蒟蒻的我掉坑里不止一次) 2. ...