
Pyspider抓取静态页面
近期,我想爬一批新闻资讯的内容。新闻类型的网址很多,我想看看有没有一个网页上能包罗尽可能多的新闻网站呢,于是就发现了下面这个网页
http://news.hao123.com/wangzhi
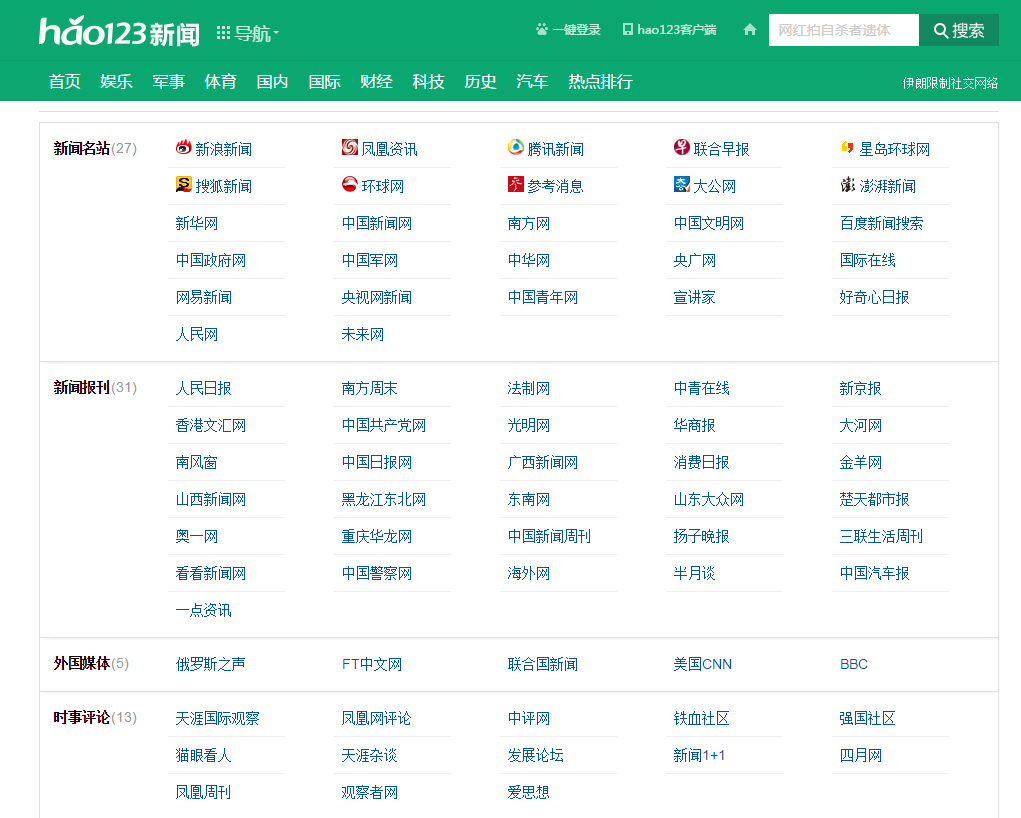
这个页面的下边还有地方新闻的分类
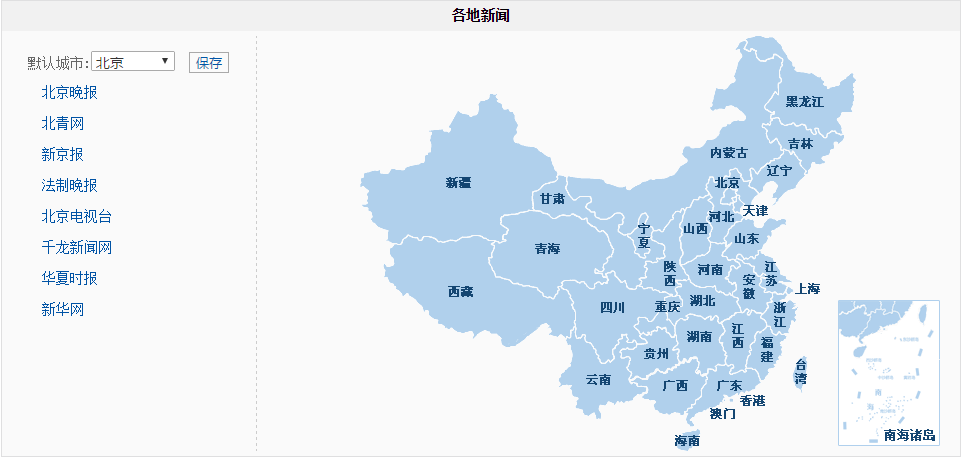
1、爬取目标
按类型分的网址列表
按地方分的网址列表
2、按类型
 #!/usr/bin/env python

 # -*- encoding: utf-8 -*-

 # Created on 2018-01-02 15:44:54

 # Project: financeNews

 from pyspider.libs.base_handler import *

 class Handler(BaseHandler):

     crawl_config = {

     }

     def __init__(self):

         self.url = 'http://news.hao123.com/wangzhi'

     @every(minutes=24 * 60)

     def on_start(self):

         self.crawl(self.url,callback=self.index_page)

     @config(age=10 * 24 * 60 * 60)

     def index_page(self, response):

         return [{

             "group" : x('.content-title').text(),

             "websites" : [a.text() for a in x('li a').items()]

         } for x in response.doc('.mod-content').items()]
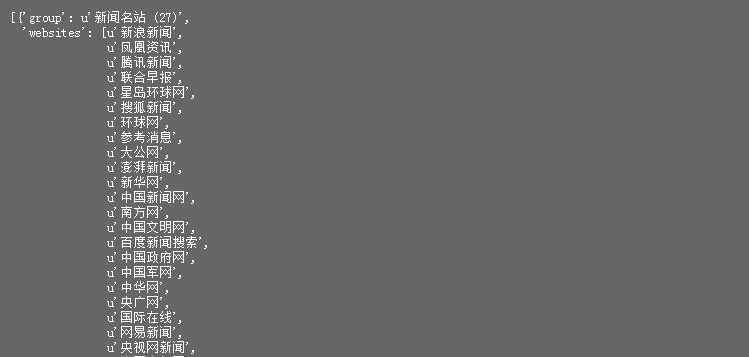
运行结果
3、按地方
 #!/usr/bin/env python

 # -*- encoding: utf-8 -*-

 # Created on 2018-01-02 15:44:54

 # Project: financeNews

 from pyspider.libs.base_handler import *

 class Handler(BaseHandler):

     crawl_config = {

     }

     def __init__(self):

         self.url = 'http://news.hao123.com/wangzhi'

     @every(minutes=24 * 60)

     def on_start(self):

         self.crawl(self.url,callback=self.index_page)

     @config(age=10 * 24 * 60 * 60)

     def index_page(self, response):

         return [{

             "city" : x.attr('id')[5:],

             "websites" : [a.text() for a in x('li a').items()]

         } for x in response.doc('.page').items()]
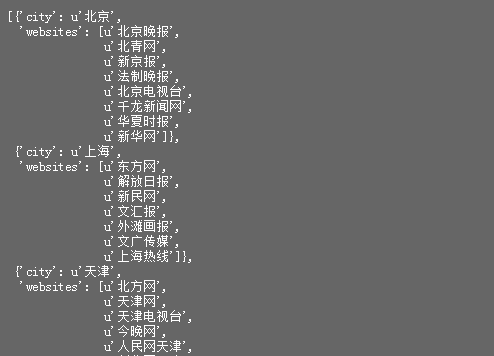
运行结果
4、知识点小结
4.1 __init__()方法为对象创建完成后的初始化方法,自动执行,可以自定义一些全局属性
4.2 "city" : x.attr('id')[5:]
取属性id的值,并从第6个字符截取
4.3 可以在return中多级遍历,数组套数组
4.4 pyspider提供了元素选择帮助功能,可以快捷选取元素,但不是非常精确
Pyspider抓取静态页面的更多相关文章
- python3.4学习笔记(十三) 网络爬虫实例代码,使用pyspider抓取多牛投资吧里面的文章信息,抓取政府网新闻内容
python3.4学习笔记(十三) 网络爬虫实例代码,使用pyspider抓取多牛投资吧里面的文章信息PySpider:一个国人编写的强大的网络爬虫系统并带有强大的WebUI,采用Python语言编写 ...
- Python爬虫之一 PySpider 抓取淘宝MM的个人信息和图片
ySpider 是一个非常方便并且功能强大的爬虫框架,支持多线程爬取.JS动态解析,提供了可操作界面.出错重试.定时爬取等等的功能,使用非常人性化. 本篇通过做一个PySpider 项目,来理解 Py ...
- 利用curl抓取远程页面内容
最基本的操作如下 $curlPost = 'a=1&b=2';//模拟POST数据$cookie_file = tempnam('./temp','kie');//可选,保存ses ...
- php curl抓取远程页面内容的代码
使用php curl抓取远程页面内容的例子. 代码如下: <?php /** * php curl抓取远程网页内容 * edit by www.jbxue.com */ $curlPost = ...
- php抓取ajax页面返回图片。
要抓取的页面:http://pic.hao123.com/ 当我们往下滚动的时候,图片是用ajax来动态获取的.这就需要我们仔细分析页面了. 可以看到,异步加载的ajax文件为: http://pic ...
- C#抓取AJAX页面的内容
原文 C#抓取AJAX页面的内容 现在的网页有相当一部分是采用了AJAX技术,所谓的AJAX技术简单一点讲就是事件驱动吧(当然这种说法可能很不全面),在你提交了URL后,服务器发给你的并不是所有是页面 ...
- Scrapy爬取静态页面
Scrapy爬取静态页面 安装Scrapy框架: Scrapy是python下一个非常有用的一个爬虫框架 Pycharm下: 搜索Scrapy库添加进项目即可 终端下: #python2 sudo p ...
- 简易数据分析 13 | Web Scraper 抓取二级页面
这是简易数据分析系列的第 13 篇文章. 不知不觉,web scraper 系列教程我已经写了 10 篇了,这 10 篇内容,基本上覆盖了 Web Scraper 大部分功能.今天的内容算这个系列的最 ...
- 用C#抓取AJAX页面的内容
现在的网页有相当一部分是采用了AJAX技术,不管是采用C#中的WebClient还是HttpRequest都得不到正确的结果,因为这些脚本是在服务器发送完毕后才执行的! 但我们用IE浏览页面时是正常的 ...
随机推荐
- git从入门到放弃
到你想进行版本控制的文件所在的目录下(该目录即是工作区) 查看状态 git status 初始化 git init 添加到暂存区 git add 提交到版本库 git commit -m " ...
- HDU3829(KB10-J 二分图最大独立集)
Cat VS Dog Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 125536/65536 K (Java/Others)Total ...
- Python面试题都在这里了
转自武沛齐博客:http://www.cnblog.com/wupeiqi/ 第一部分 Python基础篇(80题) 为什么学习Python? 通过什么途径学习的Python? Python和Java ...
- vue实现倒计时的插件 时间戳 刷新 跳转 都不影响
工作当中需要开发一个倒计时插件,于是开始网上先拿来主义,发现好多倒计时的插件,刷新都会变成从头再来,于是自己用vue2.0写了一个插件,测试已经通过,直接上代码 如下是组件代码: <templa ...
- 设计模式(9)--Composite(组合模式)--结构型
1.模式定义: 组合模式属于对象的结构模式,有时又叫做“部分——整体”模式.组合模式将对象组织到树结构中,可以用来描述整体与部分的关系.组合模式可以使客户端将单纯元素与复合元素同等看待. 2.模式特点 ...
- HTML5 简单归纳 -- 前端知识 (一)
HTML5简介 1.h5不是一个新语言,它是HTML语言第五次重大修改--版本 2. 2014年 h5 3.支持:目前所有的主流浏览器都支持h5,IE8以下不支持 4.特性: a:抛弃了h4中不 ...
- requireJS基本概念及使用流程(2)
上一篇我们一起研究了研究requireJS,这一篇我们来说一说requireJS具体的使用过程 其实很简单的,我总结了总结就是分为四步走 第一步:在页面中引入requireJS并且引入入口文件 第二步 ...
- MonkeyRunner进坑——errors importing other modules
后知后觉,刚知道Android提供了MonkeyRunner这么个东西,能用来干嘛呢,官方文档介绍得很清楚.简单说,可以用Python程序通过API, installs an Android appl ...
- EL表达式和标签
1.什么是EL expression language 表达式语言 特点: 语言简单,使用方便 .${表达式}. 提供自动类型转换的功能 如果返回结果为null时 String -- ”” Numbe ...
- 【mongoDB运维篇③】replication set复制集
介绍 replicattion set 多台服务器维护相同的数据副本,提高服务器的可用性,总结下来有以下好处: 数据备份与恢复 读写分离 MongoDB 复制集的结构以及基本概念 正如上图所示,Mon ...