
利用scrapy获取抽屉新热榜的标题和内容以及新闻地址保存到本地
1、安装scrapy
pip3 install scrapy
2、打开terminal,cd 到想要创建程序的目录下
3、创建一个scrapy项目
在终端输入:scrapy startproject my_first_scrapy(项目名)
4、在终端输入:cd my_first_scrapy 进入到项目目录下
5、新建爬虫:
输入: scrapy genspider chouti chouti.com (chouti: 爬虫名称, chouti.com : 要爬取的网站的起始网址)
6、在pycharm中打开my_first_scrapy,就可以看到刚才创建的项目:

7、打开settings.py可以对项目相关参数进行设置,如设置userAgent:
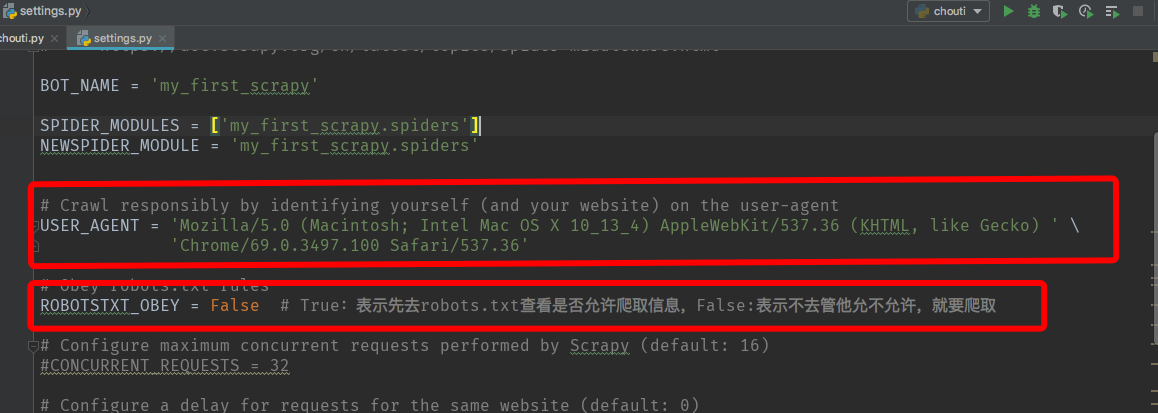
8、打开chouti.py编写代码:
# -*- coding: utf-8 -*-

"""

获取抽屉新热榜的标题和内容以及新闻地址保存到本地

"""

import scrapy

from scrapy.http import Request

from scrapy.http.response.html import HtmlResponse

from ..items import MyFirstScrapyItem

class ChoutiSpider(scrapy.Spider):

    name = 'chouti'

    allowed_domains = ['chouti.com']

    start_urls = ['http://chouti.com/']

    def parse(self, response):

        # print(response, type(response))  # <class 'scrapy.http.response.html.HtmlResponse'>

        # print(response.text)

        # 解析文本内容, 提取标题和简介,地址

        # 去页面中找id=content-list的div标签,再去这个div下找class=item的div

        items = response.xpath("//div[@id='content-list']/div[@class='item']")

        # "//"表示从html文件的根部开始找。"/"表示从儿子里面找。".//"表示相对的,及当前目录下的儿子里面找

        for item in items:

            # 当前目录下找class=part1的div标签,再找div标签下的a标签的文本信息text(),并且只取第一个

            # a标签后面可以加索引,表示取第几个a标签,如第一个:a[0]

            title = item.xpath(".//div[@class='part1']/a/text()").extract_first().strip()  # 去掉标题两端的空格

            href = item.xpath(".//div[@class='part1']/a/@href").extract_first().strip()  # 取href属性

            summary = item.xpath(".//div[@class='area-summary']/span/text()").extract_first()

            # print(1, title)

            # print(2, href)

            # print(3, summary)

            item_obj = MyFirstScrapyItem(title=title, href=href, summary=summary)  # 实例化

            yield item_obj  # 将数据交给pipelines

        # 获取页码

        page_list = response.xpath("//div[@id='dig_lcpage']//a/@href").extract()

        for url in page_list:

            url = "https://dig.chouti.com%s" % url

            yield Request(url=url, callback=self.parse)  # 下载页面内容
9、打开items.py写代码:
# -*- coding: utf-8 -*-

# Define here the models for your scraped items

#

# See documentation in:

# https://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class MyFirstScrapyItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    # 规则化:将要持久化的数据转化为某种格式

    title = scrapy.Field()

    href = scrapy.Field()

    summary = scrapy.Field()
10、打开pipelines.py写代码:
"""

1、先去类中找from_crawler

    有:执行且必须返回一个当前类的对象

    没有:不执行,则去执行构造方法__init__(self)并返回一个对象

2、再去执行"对象.其他方法"

"""

class MyFirstScrapyPipeline(object):

    def __init__(self, file_path):

        self.f = None

        self.file_path = file_path

    @classmethod

    def from_crawler(cls, crawler):

        """

        初始化时,用于创建pipelines对象

        :param crawler:

        :return:

        """

        file_path = crawler.settings.get("CHOUTI_NEWS_PATH")  # 存储文件的路径

        return cls(file_path)

    def open_spider(self, spider):

        """

        打开文件

        :param spider:提交数据过来的爬虫对象

        :return:

        """

        self.f = open(self.file_path, "a+", encoding="utf-8")

    def process_item(self, item, spider):

        """

        :param item: 爬虫中yield过来的item对象

        :param spider:提交数据过来的爬虫对象

        :return:

        """

        self.f.write(item["href"] + "\n")

        self.f.flush()  # 将内容强刷到硬盘进行保存

        return item

    def close_spider(self, spider):

        """

        关闭文件

        :param spider:提交数据过来的爬虫对象

        :return:

        """

        self.f.close()
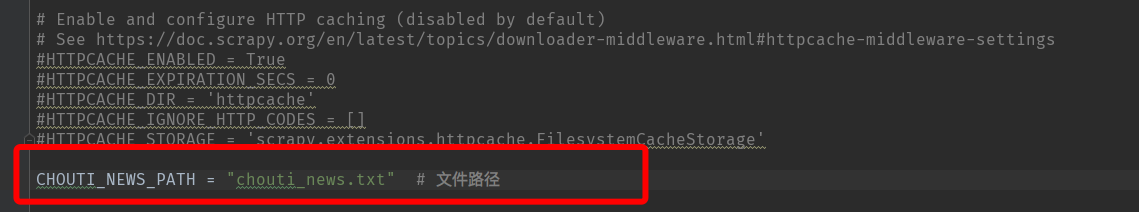
11、在settings.py中找到 ITEM_PIPELINES进行设置,并设置存储下载的新闻存储的文件路径:

12、运行爬虫项目,在终端输入:
scrapy crawl chouti(会打印日志) 或者 scrapy crawl chouti --nolog (不打印日志)
利用scrapy获取抽屉新热榜的标题和内容以及新闻地址保存到本地的更多相关文章
- 【IOS】模仿"抽屉新热榜"动态启动页YFSplashScreen
IOS最好要设置系统默认启动页面,不然进入应用就会突然闪现黑色画面 下图是我们要实现的效果: 总体思路:设置一个系统默认启动页面,在进入didFinishLaunchingWithOptions时, ...
- Python之路【第二十篇】:python项目之旧版抽屉新热榜
旧版抽屉新热榜 代码如下: <!DOCTYPE html> <html lang="en"> <head> <meta charset=& ...
- 【Python之路】特别篇--抽屉新热榜
登陆与注册 注册功能: 流程: 填写用户名,邮箱,获取邮箱验证码,填入密码 单击<下一步>按钮,完成注册! 1.获取邮箱验证码(具体步骤分析): 1.利用ajax 往后台传入邮箱, 2.后 ...
- 利用scrapy爬取腾讯的招聘信息
利用scrapy框架抓取腾讯的招聘信息,爬取地址为:https://hr.tencent.com/position.php 抓取字段包括:招聘岗位,人数,工作地点,发布时间,及具体的工作要求和工作任务 ...
- 用python实现的百度新歌榜、热歌榜下载器
首先声明,本工具仅仅为学习之用,不涉及版权问题,因为百度音乐里面的歌曲本身是可以下载的,而且现在百度也提供了”百度音乐播放器”,可以通过这个工具进行批量下载. 我当时做这个工具的时候,百度还没有提供” ...
- 了不起的 Deno:带你极速获取各大平台今日热榜
摘要:Deno 是一个 JavaScript/TypeScript 的运行时,默认使用安全环境执行代码,有着卓越的开发体验. 有人的地方就有江湖,有江湖的地方就有争论.前些天,继<[译]为什么如 ...
- (转)利用libcurl获取新浪股票接口, ubuntu和openwrt实验成功(三)
1. 利用 CURLOPT_WRITEFUNCTION 设置回调函数, 利用 CURLOPT_WRITEDATA 获取数据指针 官网文档如下 CALLBACK OPTIONS CURLOPT_WRI ...
- 全网趣味网站分享:今日热榜/Pixiv高级搜索/win10激活工具/songtaste复活/sharesome汤不热替代者
1.回形针手册 由科普类视频节目“回形针PaperClip”近期提出的一个实用百科工具计划,计划名称是回形针手册. 包含了当下科技,农业等等各行各业的各种相关信息,计划刚刚开始! 关于回形针手册的详细 ...
- 利用scrapy和MongoDB来开发一个爬虫
今天我们利用scrapy框架来抓取Stack Overflow里面最新的问题(),并且将这些问题保存到MongoDb当中,直接提供给客户进行查询. 安装 在进行今天的任务之前我们需要安装二个框架,分别 ...
随机推荐
- 桌面应用也可以提供HTTP文件下载
以往,我们肯定知道,在搞Web应用的时候,我们都可能会遇到提供文件下载的功能需求,比如我以前做的一个客户许可证管理系统,客户购买ERP系统后,通常我们会根据客户的机器的机器码生成一个许可文件,而这个许 ...
- UWP 动画
一:StoryBoard 一般翻译成演示图版或者故事板,就像电影中的情节串联板,它是一个动画时间线的容器. 二:动画的分类 简单动画:以Animation结尾,例如DoubleAnimat ...
- HDU6438(贪心技巧)
第一眼喜闻乐见的股票问题dp可以暴力,然鹅时间不允许. 于是考虑怎么贪. 这篇题解说得很生动了. 因为每支股票都有买入的潜力所以肯定都加在优先队列里. 然后考虑的是哪些需要加入两次.这是我第二次见到类 ...
- 面试王牌 JAVA并发
Java 并发 JavathreadSocketC#C++ 并发 Table of Contents 1 什么是并发问题. 2多线程死锁问题 2 java中synchronized的用法 3 Java ...
- AJPFX总结jvm运行时内存分布
jvm的运行过程中将java程序运行时数据区分为以下几个部分: (1)程序计数器:存储虚拟机字节码执行的地址 (2)java虚拟机栈:java方法运行时的局部变量表,操作数栈,方法出口等 ( ...
- AJPFX浅谈关于Java程序员缺乏面向对象的基本功的问题
为什么很多 Java 程序员会缺乏面向对象基本功?这得怪那些 Java 框架.现在 Java 的各种框架太发达.太傻瓜化了,导致很多程序员只需要按部就班.照着框架进行代码填空,基本已经丧失了 OOA ...
- AJAX中文乱码解决方案
通过AJAX获取数据中文乱码解决方案: @ResponseBody 作用: 该注解用于将Controller的方法返回的对象,通过适当的HttpMessageConverter转换为指定格式后,写入到 ...
- 编译安装LAMP之php(fpm模块)
一,准备工作实验平台为CentOS6.6,先下载所需的安装包,我使用的是php-5.4.26.tar.gz,下载地址 http://mirrors.sohu.com/php/ 编译安装的目录:/usr ...
- 使用libsvm实现文本分类
@Hcy(黄灿奕) 文本分类,首先它是分类问题,应该对应着分类过程的两个重要的步骤,一个是使用训练数据集训练分类器,另一个就是使用测试数据集来评价分类器的分类精度.然而,作为文本分类,它还具有文本这样 ...
- MongoDB最简单的入门教程之二 使用nodejs访问MongoDB
在前一篇教程 MongoDB最简单的入门教程之一 环境搭建 里,我们已经完成了MongoDB的环境搭建. 在localhost:27017的服务器上,在数据库admin下面创建了一个名为person的 ...