
机器学习(四) 机器学习(四) 分类算法--K近邻算法 KNN (下)
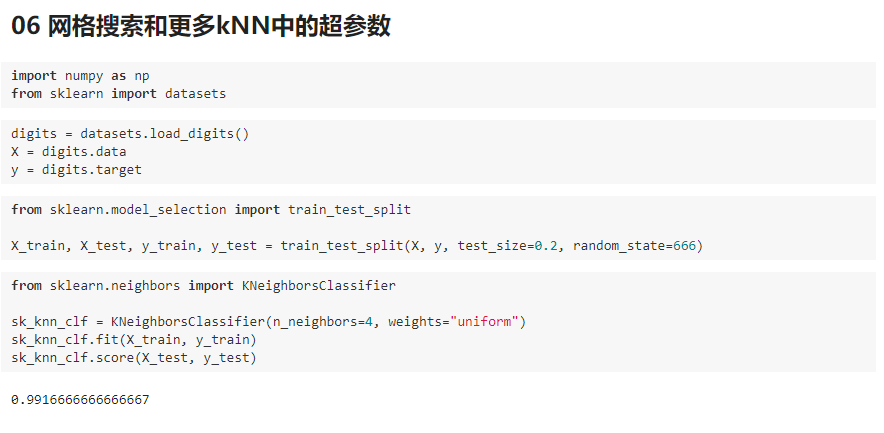
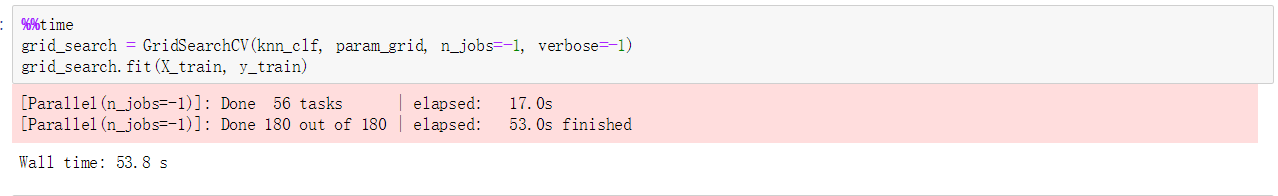
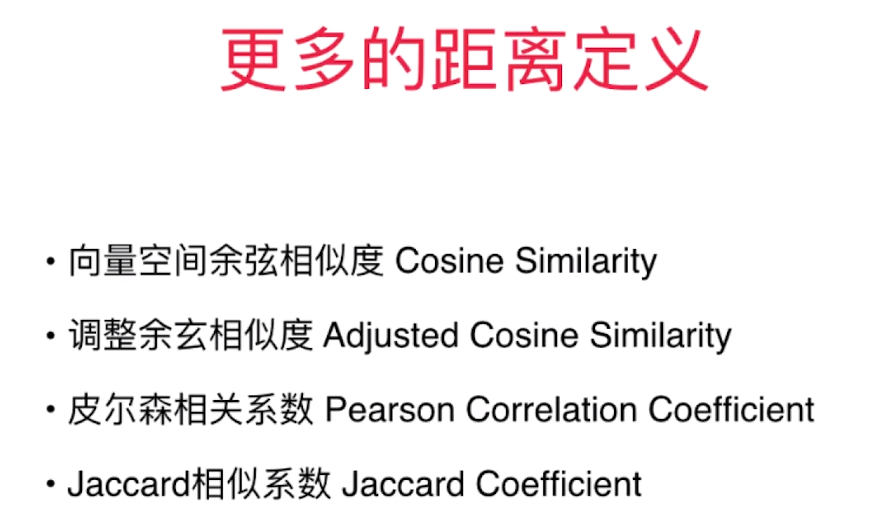
六、网格搜索与 K 邻近算法中更多的超参数

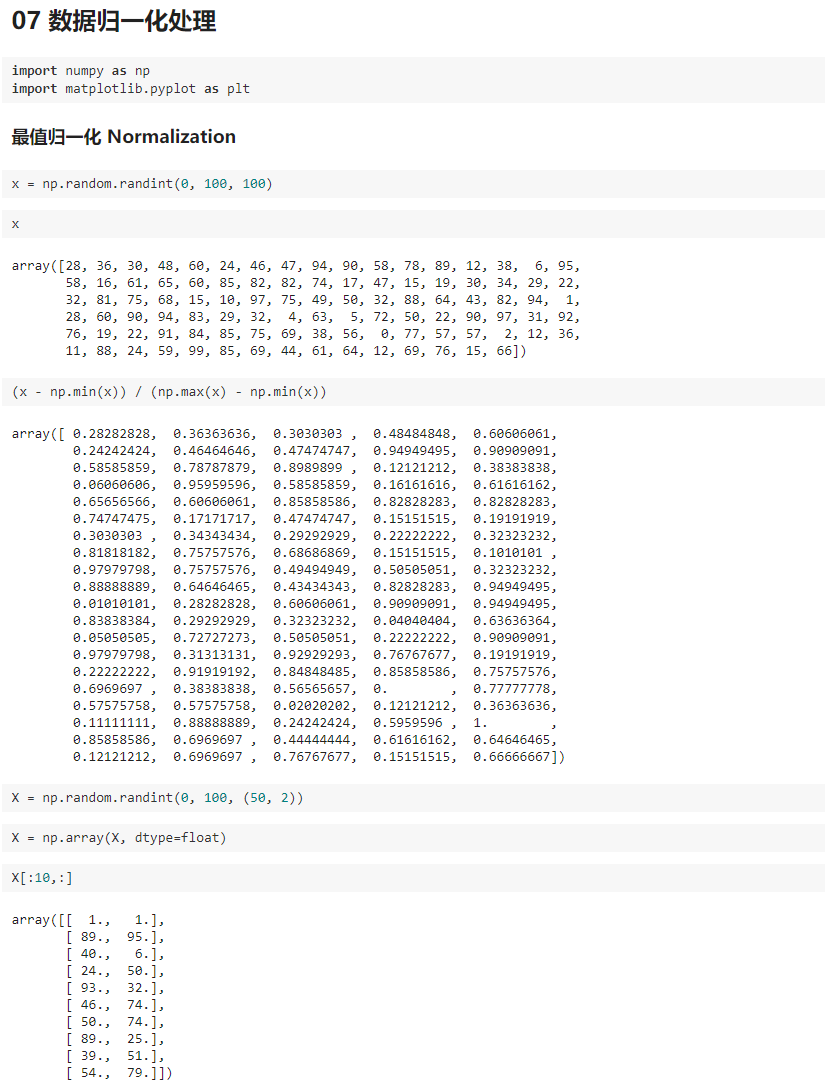
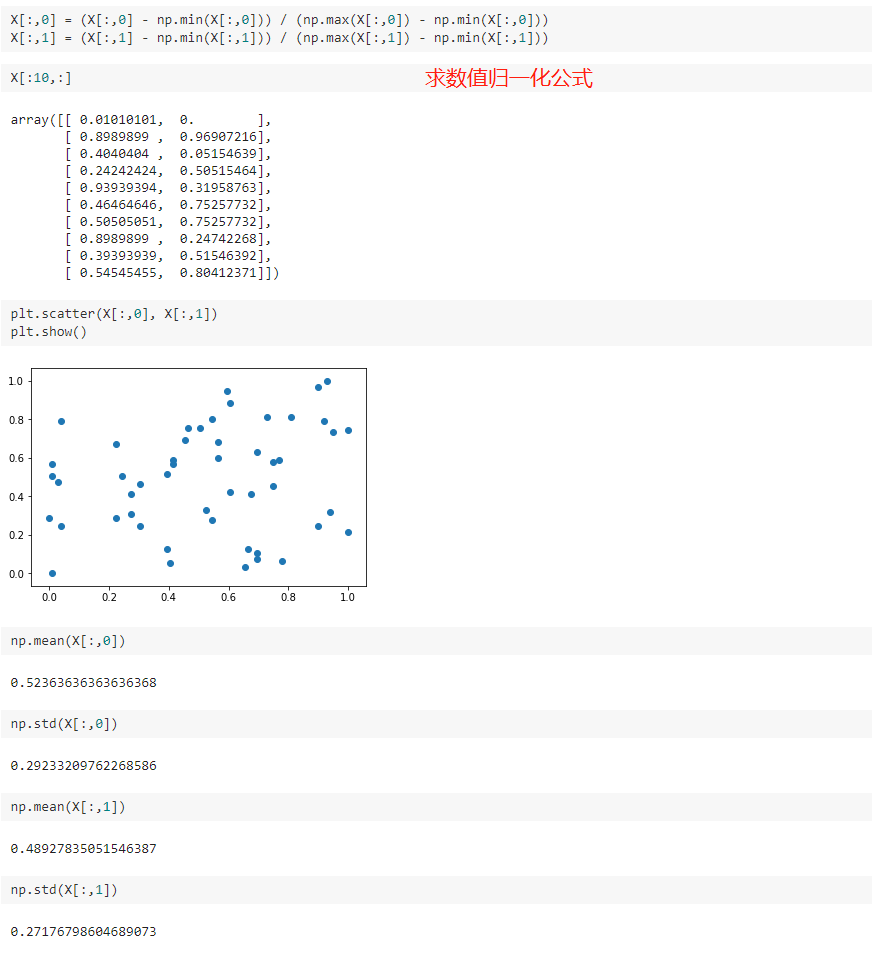
七、数据归一化 Feature Scaling

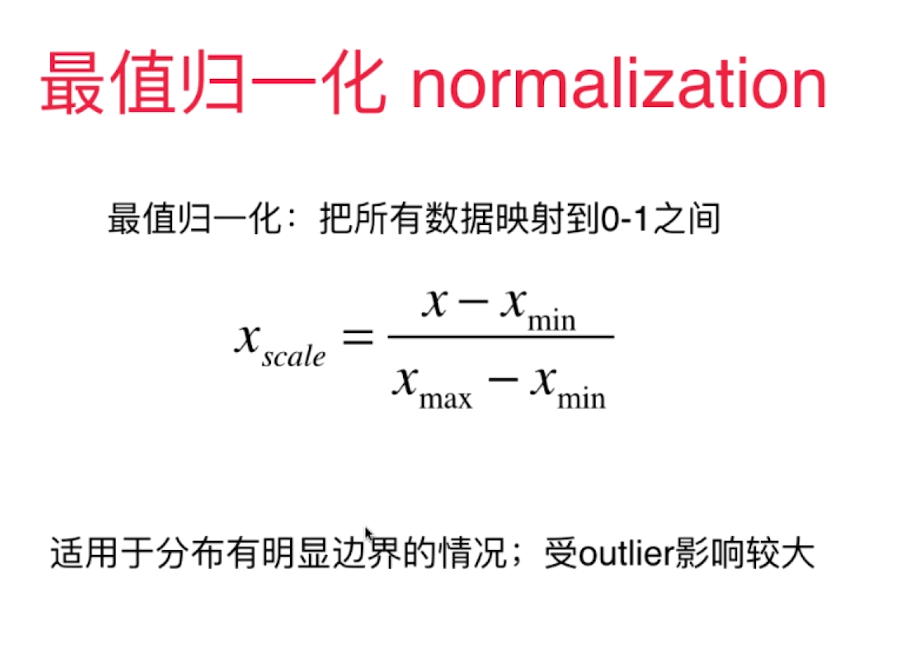
解决方案:将所有的数据映射到同一尺度


八、scikit-learn 中的 Scaler
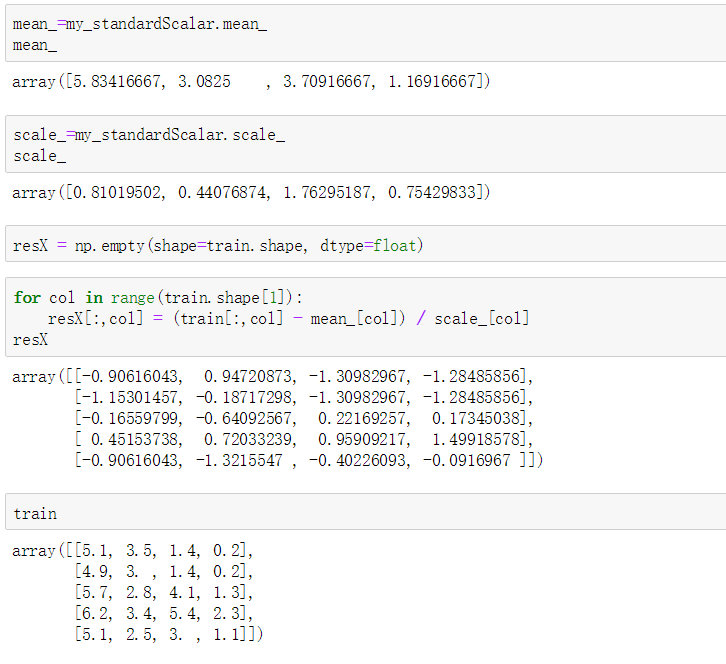
preprocessing.py
import numpy as np

class StandardScaler:

    def __init__(self):

        self.mean_ = None

        self.scale_ = None

    def fit(self, X):

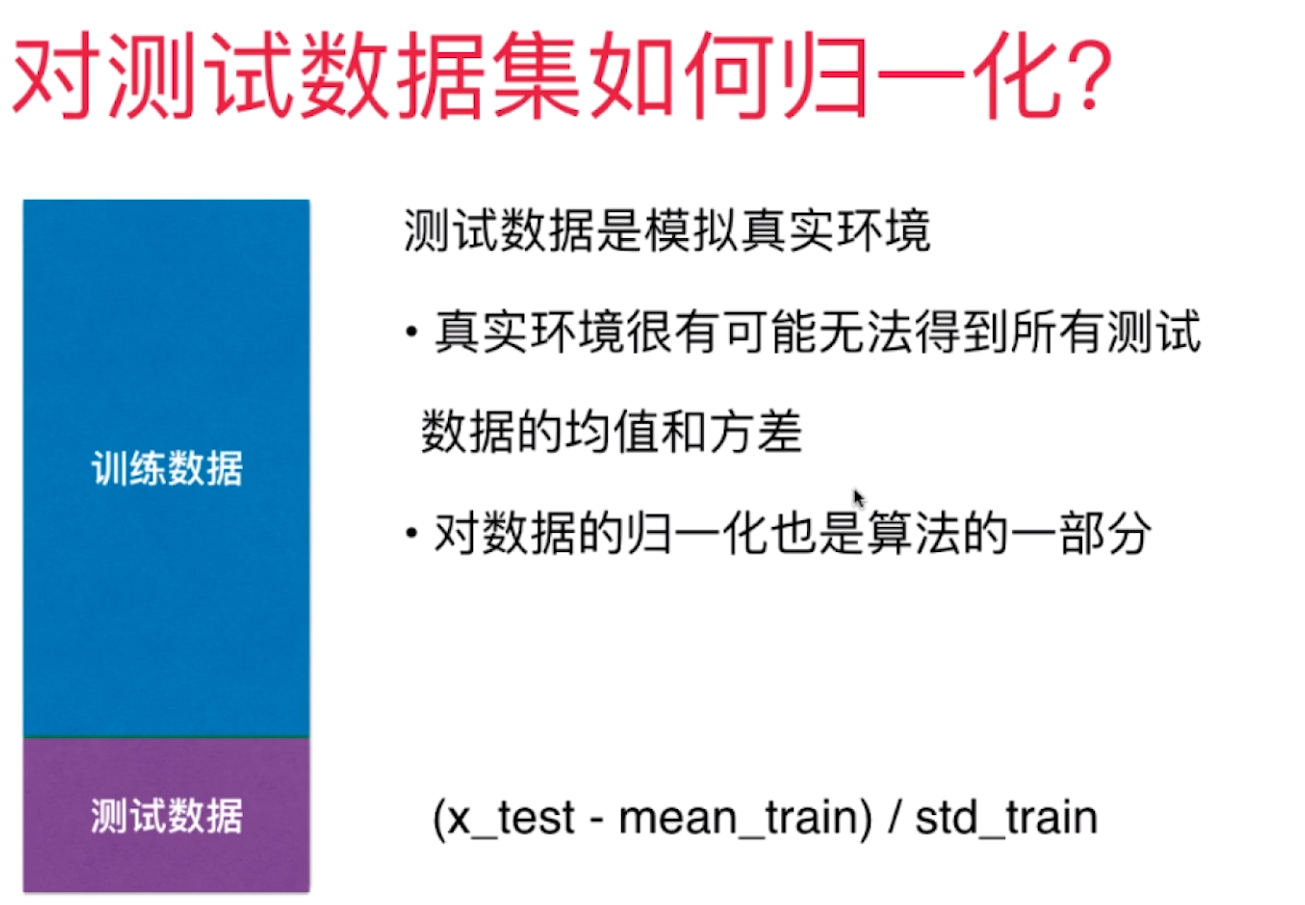
        """根据训练数据集X获得数据的均值和方差"""

        assert X.ndim == 2, "The dimension of X must be 2"

        self.mean_ = np.array([np.mean(X[:,i]) for i in range(X.shape[1])])

        self.scale_ = np.array([np.std(X[:,i]) for i in range(X.shape[1])])

        return self

    def transform(self, X):

        """将X根据这个StandardScaler进行均值方差归一化处理"""

        assert X.ndim == 2, "The dimension of X must be 2"

        assert self.mean_ is not None and self.scale_ is not None, \

               "must fit before transform!"

        assert X.shape[1] == len(self.mean_), \

               "the feature number of X must be equal to mean_ and std_"

        resX = np.empty(shape=X.shape, dtype=float)

        for col in range(X.shape[1]):

            resX[:,col] = (X[:,col] - self.mean_[col]) / self.scale_[col]

        return resX


九、更多有关 K 近邻算法的思考
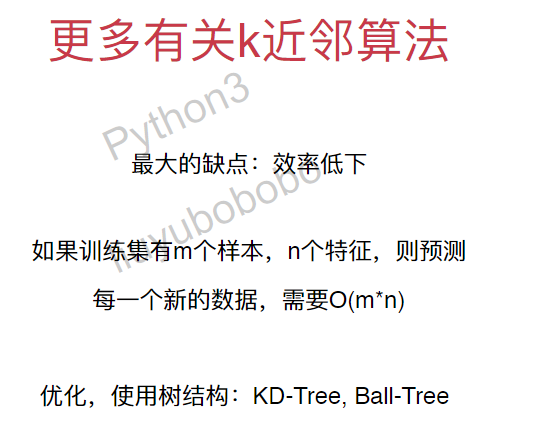
优点:



机器学习(四) 机器学习(四) 分类算法--K近邻算法 KNN (下)的更多相关文章
- 第4章 最基础的分类算法-k近邻算法
思想极度简单 应用数学知识少 效果好(缺点?) 可以解释机器学习算法使用过程中的很多细节问题 更完整的刻画机器学习应用的流程 distances = [] for x_train in X_train ...
- 机器学习(四) 分类算法--K近邻算法 KNN (上)
一.K近邻算法基础 KNN------- K近邻算法--------K-Nearest Neighbors 思想极度简单 应用数学知识少 (近乎为零) 效果好(缺点?) 可以解释机器学习算法使用过程中 ...
- python 机器学习(二)分类算法-k近邻算法
一.什么是K近邻算法? 定义: 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别. 来源: KNN算法最早是由Cover和Hart提 ...
- 分类算法----k近邻算法
K最近邻(k-Nearest Neighbor,KNN)分类算法,是一个理论上比较成熟的方法,也是最简单的机器学习算法之一.该方法的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的 ...
- 【学习笔记】分类算法-k近邻算法
k-近邻算法采用测量不同特征值之间的距离来进行分类. 优点:精度高.对异常值不敏感.无数据输入假定 缺点:计算复杂度高.空间复杂度高 使用数据范围:数值型和标称型 用例子来理解k-近邻算法 电影可以按 ...
- 最基础的分类算法-k近邻算法 kNN简介及Jupyter基础实现及Python实现
k-Nearest Neighbors简介 对于该图来说,x轴对应的是肿瘤的大小,y轴对应的是时间,蓝色样本表示恶性肿瘤,红色样本表示良性肿瘤,我们先假设k=3,这个k先不考虑怎么得到,先假设这个k是 ...
- 机器学习03:K近邻算法
本文来自同步博客. P.S. 不知道怎么显示数学公式以及排版文章.所以如果觉得文章下面格式乱的话请自行跳转到上述链接.后续我将不再对数学公式进行截图,毕竟行内公式截图的话排版会很乱.看原博客地址会有更 ...
- 02-16 k近邻算法
目录 k近邻算法 一.k近邻算法学习目标 二.k近邻算法引入 三.k近邻算法详解 3.1 k近邻算法三要素 3.1.1 k值的选择 3.1.2 最近邻算法 3.1.3 距离度量的方式 3.1.4 分类 ...
- k近邻算法
k 近邻算法是一种基本分类与回归方法.我现在只是想讨论分类问题中的k近邻法.k近邻算法的输入为实例的特征向量,对应于特征空间的点,输出的为实例的类别.k邻近法假设给定一个训练数据集,其中实例类别已定. ...
随机推荐
- Mosquito的优化——epoll优化(七)
本文由逍遥子撰写,转发请标注原址: http://blog.csdn.net/houjixin/article/details/46413583 或 http://houjixin.blog.163. ...
- 公司--下载svg图片
加载本地svg图片: SVGParserRenderer norDrawable = OtherPageConfigsManager.getInstance().getSVGParserRendere ...
- bzoj4519: [Cqoi2016]不同的最小割(分治最小割)
4519: [Cqoi2016]不同的最小割 题目:传送门 题解: 同BZOJ 2229 基本一样的题目啊,就最后用set记录一下就ok 代码: #include<cstdio> #inc ...
- 创建表空间及plsql查看远程表空间路径
-新建表空间,登录名和密码 --请尽量把表空间和别的系统分离,这里以Search为例子,登录名和密码以test为例子 create tablespace Search logging datafile ...
- jsp页面String path = request.getContextPath(); String basePath = request.getScheme() + "://" + request.getServerName() + ":" + request.getServerPort() + path + "/";作用!!!!!
转自:https://blog.csdn.net/kiwangruikyo/article/details/81130311 <%String path = request.getContext ...
- 21.boost Ford最短路径算法(效率低)
到某个节点最近距离 最短路径当前节点的父节点 完整代码 #include <iostream> #include <string> #incl ...
- python 3.x 学习笔记7 ( 模块 (修))
1.定义:模块:用来从逻辑上组织python代码(变量.函数.类.逻辑:实现一个功能),本质就是.py结尾的python文件包:用来从逻辑上组织模块的,本质就是一个目录(必须带有一个__init__. ...
- SVN Commit报错 svn: E155037: Previous operation has not finished; run 'cleanup' if it was interrupted
svn commit 文件出错 svn: E155037: Commit failed (details follow): svn: E155037: Previous operation has n ...
- 蛋白质GO信息的一些数据库
最近用到蛋白质序列数据,但是才发现蛋白质的编号主要分为两种:一种是ENSP开头,主要是在ensembl数据库查询asia.ensembl.org/Human/Search:而另一种是uniprot.w ...
- 预测一下web前端未来的6个趋势
2018年前端技术的发展也将进入到一个相对稳定的阶段, 就前端主流技术框架的发展而言,过去的几年里发展极快,在填补原有技术框架空白和不足的同时也渐渐趋于成熟. 未来前端在已经趋向成熟的技术方向上面将会 ...