
spark not serializable异常分析及解决方案
转载自: http://bigdataer.net/?p=569
1.背景
在使用spark开发分布式数据计算作业过程中或多或少会遇到如下的错误:
Serialization stack:

object not serializable (class:class: org.apache.hadoop.hbase.io.ImmutableBytesWritable, value: 30 30 30 30 30 30 32 34 32 30 32 37 37 32 31)

field (class: scala.Tuple2, name: _1, type: class java.lang.Object) ……
或者如下的错误:
org.apache.spark.SparkException: Task not serializable at org.apache.spark.util.ClosureCleaner …
表面意思都是无法序列化导致的。spark运行过程中为什么要序列化?下面来分析一下。
2.分析
spark处理的数据单元为RDD(即弹性分布式数据集),当我们要对RDD做诸如map,filter等操作的时候是在excutor上完成的。但是如果我们在driver中定义了一个变量,在map等操作中使用,则这个变量就要被分发到各个excutor,因为driver和excutor的运行在不同的jvm中,势必会涉及到对象的序列化与反序列化。如果这个变量没法序列化就会报异常。还有一种情况就是引用的对象可以序列化,但是引用的对象本身引用的其他对象无法序列化,也会有异常。
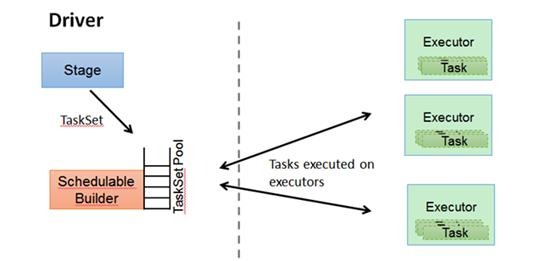
3.解决方案
(1) 举例
class UnserializableClass {

    def method(x:Int):Int={

        x*x

    }

}
另外,有如下的spark代码块:
object SparkTest {

  def main(args: Array[String]): Unit = {

  val conf = new SparkConf().setMaster("local[*]").setAppName("test")

  val sc = new SparkContext(conf)

  val rdd = sc.parallelize(1 to 10, 3)

  val usz = new UnserializableClass()

  rdd.map(x=>usz.method(x)).foreach(println(_))

  }

}
那么运行的时候就会抛出异常
Exception in thread “main” org.apache.spark.SparkException: Task not serializable

at org.apache.spark.util.ClosureCleaner$.ensureSerializable(ClosureCleaner.scala:304)

at org.apache.spark.util.ClosureCleaner$.org$apache$spark$util$ClosureCleaner$$clean(ClosureCleaner.scala:294)

at org.apache.spark.util.ClosureCleaner$.clean(ClosureCleaner.scala:122)

at org.apache.spark.SparkContext.clean(SparkContext.scala:2055)

at org.apache.spark.rdd.RDD$$anonfun$map$1.apply(RDD.scala:324)

at org.apache.spark.rdd.RDD$$anonfun$map$1.apply(RDD.scala:323)

at org.apache.spark.rdd.RDDOperationScope$.withScope(RDDOperationScope.scala:150)

at org.apache.spark.rdd.RDDOperationScope$.withScope(RDDOperationScope.scala:111)

at org.apache.spark.rdd.RDD.withScope(RDD.scala:316)

at org.apache.spark.rdd.RDD.map(RDD.scala:323)

at net.bigdataer.spark.SparkTest$.main(SparkTest.scala:16)
(2) 解决方案
1. 将不可序列化的对象定义在闭包内
object SparkTest {

  def main(args: Array[String]): Unit = {

  val conf = new SparkConf().setMaster("local[*]").setAppName("test")

  val sc = new SparkContext(conf)

  val rdd = sc.parallelize(1 to 10,3)

  rdd.map(x=>new UnserializableClass().method(x)).foreach(println(_)) //在map中创建UnserializableClass对象

  }

 }
2.将所调用的方法改为函数,在高阶函数中使用
class UnserializableClass {

  //method方法

  /*def method(x:Int):Int={

    x*x

  }*/

//method函数

  val method = (x:Int)=>x*x

}
在SparkTest中传入函数
object SparkTest {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local[*]").setAppName("test")

    val sc = new SparkContext(conf)

    val rdd = sc.parallelize(1 to 10,3)

    val usz  = new UnserializableClass()

    rdd.map(usz.method).foreach(println(_)) //注意这里传入的是函数

  }

}
3.给无法序列化的类加上java.io.Serializable接口
class UnserializableClass extends java.io.Serializable{ //加接口

  def method(x:Int):Int={

    x*x

  }

}
4.注册序列化类
以上三个方法基于UnserializableClass可以被修改来说的,假如UnserializableClass来自于第三方,你无法修改其源码就可以使用为其注册序列化类的方法。
object SparkTest {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local[*]").setAppName("test")

    conf.set("spark.serializer", "org.apache.spark.serializer.KryoSerializer") //指定序列化类为KryoSerializer

    conf.registerKryoClasses(Array(classOf[net.bigdataer.spark.UnserializableClass])) //将UnserializableClass注册到kryo需要序列化的类中

    val sc = new SparkContext(conf)

    val rdd = sc.parallelize(1 to 10,3)

    val usz  = new UnserializableClass()

    rdd.map(x=>usz.method(x)).foreach(println(_))

  }

}
第一种方法比较简单实用。
spark not serializable异常分析及解决方案的更多相关文章
- Java ConcurrentModificationException 异常分析与解决方案
Java ConcurrentModificationException 异常分析与解决方案http://www.2cto.com/kf/201403/286536.html java.util.Co ...
- 【转】Java ConcurrentModificationException 异常分析与解决方案--还不错
原文网址:http://www.2cto.com/kf/201403/286536.html 一.单线程 1. 异常情况举例 只要抛出出现异常,可以肯定的是代码一定有错误的地方.先来看看都有哪些情况会 ...
- Selenium常见异常分析及解决方案
pycharm中导入selenium报错 现象: pycharm中输入from selenium import webdriver, selenium标红 原因1: pycharm使用的虚拟环境中没有 ...
- hive on spark:return code 30041 Failed to create Spark client for Spark session原因分析及解决方案探寻
最近在Hive中使用Spark引擎进行执行时(set hive.execution.engine=spark),经常遇到return code 30041的报错,为了深入探究其原因,阅读了官方issu ...
- Canal 同步异常分析:Could not find first log file name in binary log index file
文章首发于[博客园-陈树义],点击跳转到原文Canal同步异常分析:Could not find first log file name in binary log index file. 公司搜索相 ...
- flume常见异常汇总以及解决方案
flume常见异常汇总以及解决方案 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 实际生产环境中,我用flume将kafka的数据定期的往hdfs集群中上传数据,也遇到过一系列的坑 ...
- 第一篇:Spark SQL源码分析之核心流程
/** Spark SQL源码分析系列文章*/ 自从去年Spark Submit 2013 Michael Armbrust分享了他的Catalyst,到至今1年多了,Spark SQL的贡献者从几人 ...
- Linux Kernel Oops异常分析
1.PowerPC小系统内核异常分析 1.1 异常打印 Unable to handle kernel paging request for data at address 0x36fef31eFa ...
- MySQL 外键异常分析
外键约束异常现象 如下测例中,没有违反引用约束的插入失败. create database `a-b`; use `a-b`; SET FOREIGN_KEY_CHECKS=0; create tab ...
随机推荐
- 渡鸦币(Raven)钱包交叉编译详解
1 环境准备 1.1 准备Ubuntu 准备虚拟机或物理机,操作系统为Ubuntu 16.04 1.2 安装Mingw sudo apt-get install g++-mingw-w64-i686 ...
- 提高.NET应用性能
提高.NET应用性能的方法 写在前面 设计良好的系统,除了架构层面的优良设计外,剩下的大部分就在于如何设计良好的代码,.NET提供了很多的类型,这些类型非常灵活,也非常好用,比如List,Dictio ...
- 读取json数据封装
前言:做自动化常用公共方法 import json class ReadJson(): def __init__(self): self.data = self.read_data() #读取JSON ...
- ELK实战搭建+x-pack安全认证
阅读目录: ELK日志平台入门简介1.1 ELK原理拓扑图1.2 Elasticsearch安装配置1.3 Kibana安装配置1.4 Kibana汉化及时区修改1.5 Logst ...
- 《Tsinghua oc mooc》第8~10讲 虚拟内存管理
资源 OS2018Spring课程资料首页 uCore OS在线实验指导书 ucore实验基准源代码 MOOC OS习题集 OS课堂练习 Piazza问答平台 暂时无法注册 第八讲 虚拟内存概念 为什 ...
- JAVA MAC 比较大小
2个MAC String mac_1="AAAAAAAAAAAA"; String mac_1="AAAAAAAAAAAB"; 方法一: int a = 0; ...
- 人机交互技术 Week 2_History of HCI
Recap: Interaction Design Interaction Design Designing interactive products to support people in the ...
- 洛谷 P1019单词接龙
看吧,多简单啊,没有人受伤的世界完成了. ...
- 利用Python进行数据分析_Pandas_数据加载、存储与文件格式
申明:本系列文章是自己在学习<利用Python进行数据分析>这本书的过程中,为了方便后期自己巩固知识而整理. 1 pandas读取文件的解析函数 read_csv 读取带分隔符的数据,默认 ...
- Python--字典的一些用法dict.items()
1.dict.items() 例子1: 以列表返回可遍历的(键, 值) 元组数组. dict = {'Name': 'Runoob', 'Age': 7} print ("Value : % ...