
[日志分析]Graylog2采集Nginx日志 主动方式
这次聊一下Graylog如何主动采集Nginx日志,分成两部分:
- 介绍一下 Graylog Collector Sidecar 是什么
- 如何配置 Graylog Collector Sidecar 采集nginx日志
一、首先介绍一下Graylog Collector Sidecar
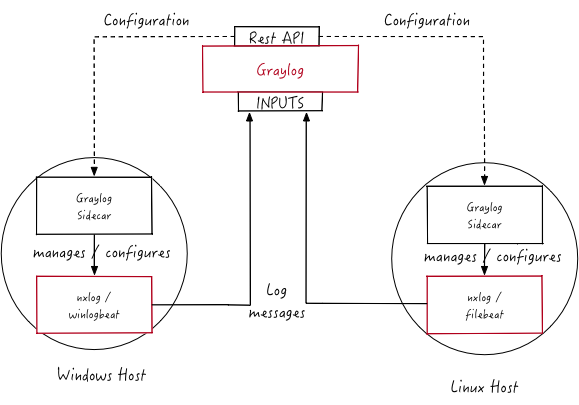
Graylog Collector Sidecar 是一个轻量级的日志采集器,通过访问graylog进行集中式管理,支持linux和windows系统。
Sidecar 守护进程会定期访问graylog的REST API接口获取Sidecar配置文件中定义的标签(tag),Sidecar在首次运行时会从graylog服务器拉取配置文件中指定标签(tag)的配置信息同步到本地。
目前Sidecar支持NXLog,Filebeat和Winlogbeat。他们都通过graylog中的web界面进行统一配置,支持Beats、CEF、Gelf、Json API、NetFlow等输出类型。
Graylog最厉害的在于可以在配置文件中指定Sidecar把日志发送到哪个graylog群集,并对graylog群集中的多个input进行负载均衡,这样在遇到日志量非常庞大的时候,graylog也能应付自如。
二、配置 Graylog Collector Sidecar 采集nginx日志
1、graylog服务器端配置:
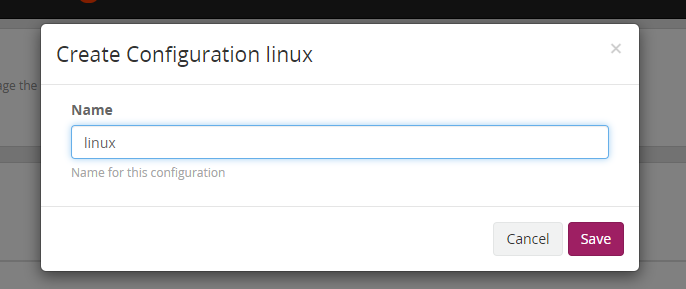
(1)导航栏 System/Collectors -> Collectors -> Manage Configurations -> Create configuration ,创建我们第一个名为linux的配置文件

(2)在输入栏写入配置文件的名字 linux ,表示这个是用来收集linux主机日志的配置文件,点击 save 保存
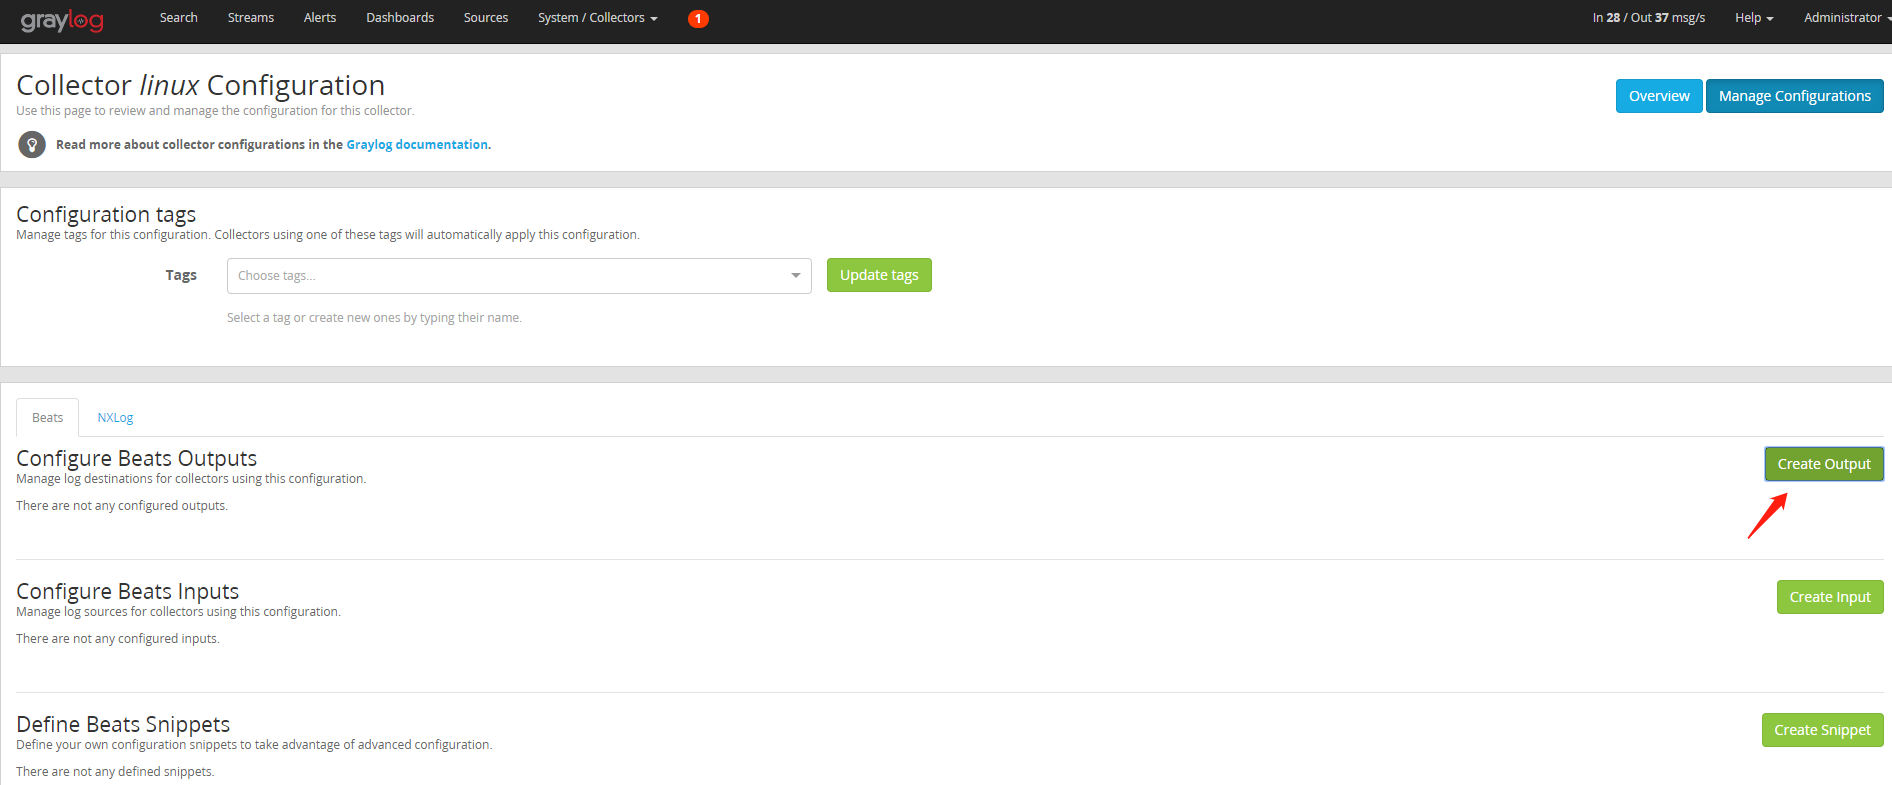
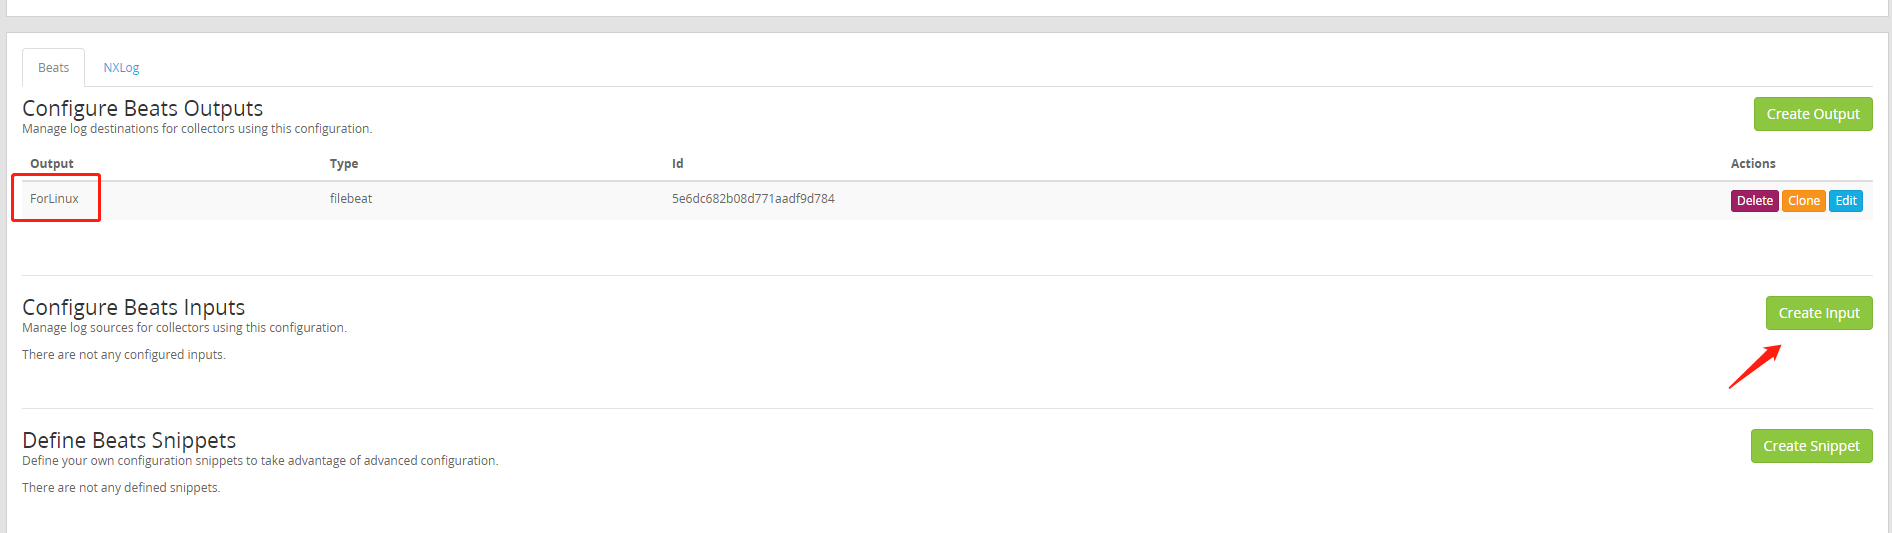
(3)创建 Beats Output ,我们在Configure Beats Outputs 中点击 Create Output ,Output 主要定义的是日志的类型以及它要流入的目标服务器(graylog),这就好比你寄出一个快递要写包裹接收的地址。
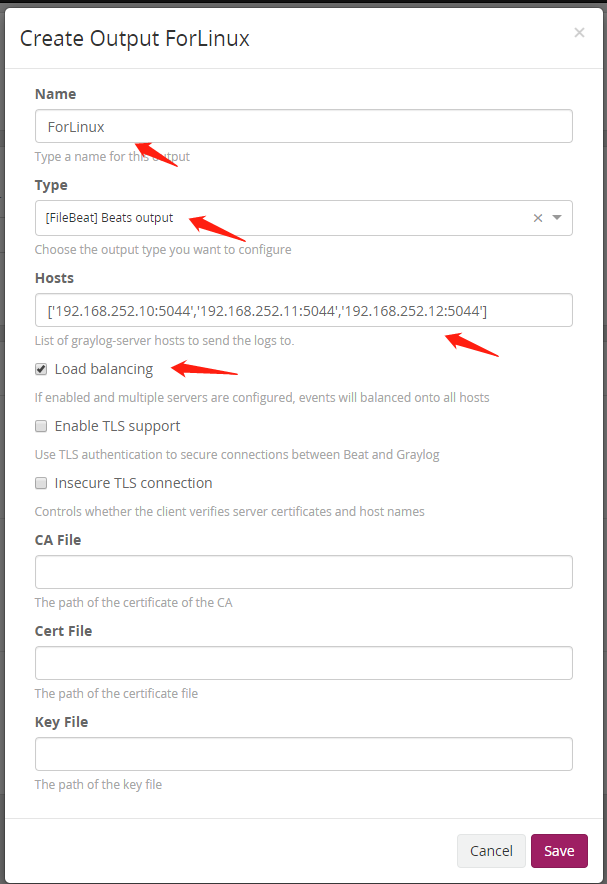
(4)Beats output 中需要填写的内容是output的名称(Name):ForLinux、类型(Type)我们选择Filebeat,Hosts里面填入的是graylog日志服务器的地址和端口(假设我们是三台graylog的集群192.168.252.10-12,5044是beats类型默认的端口),然后把Load balancing(负载均衡)选上,这样日志收集后就会轮询的向这三台主机发送日志了,最后点击 save 保存
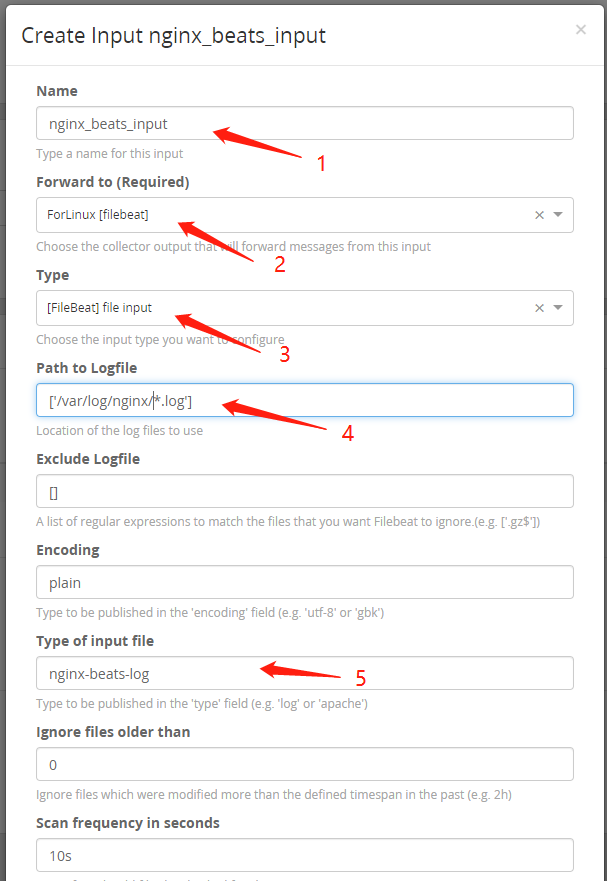
(5)Beats Output 创建完毕之后,我们还要创建一个Input,点击 Configure Beats Inputs 下的 Create Input 进行创建。input相当于是属于ForLinux 配置下的一个tag,它用来定义来源日志的信息。还用发快递举例,这个input相当于填写发件人的地址信息,告知对方是谁发出的并寄给 ForLinux ,ForLinux 配置里面就是写的接收人的地址信息,你可以定义多个Input来区分不同的发件人,也就是来源日志的类型。
(6)Beats Input中要填写的是Name(谁发的)、Forward to(发给谁)、Type(linux or windows)、Path to Logfile(相当于发件人的详细地址)、Type of input file(ES分析日志中的type字段,便于区分日志类型),最后点击save保存
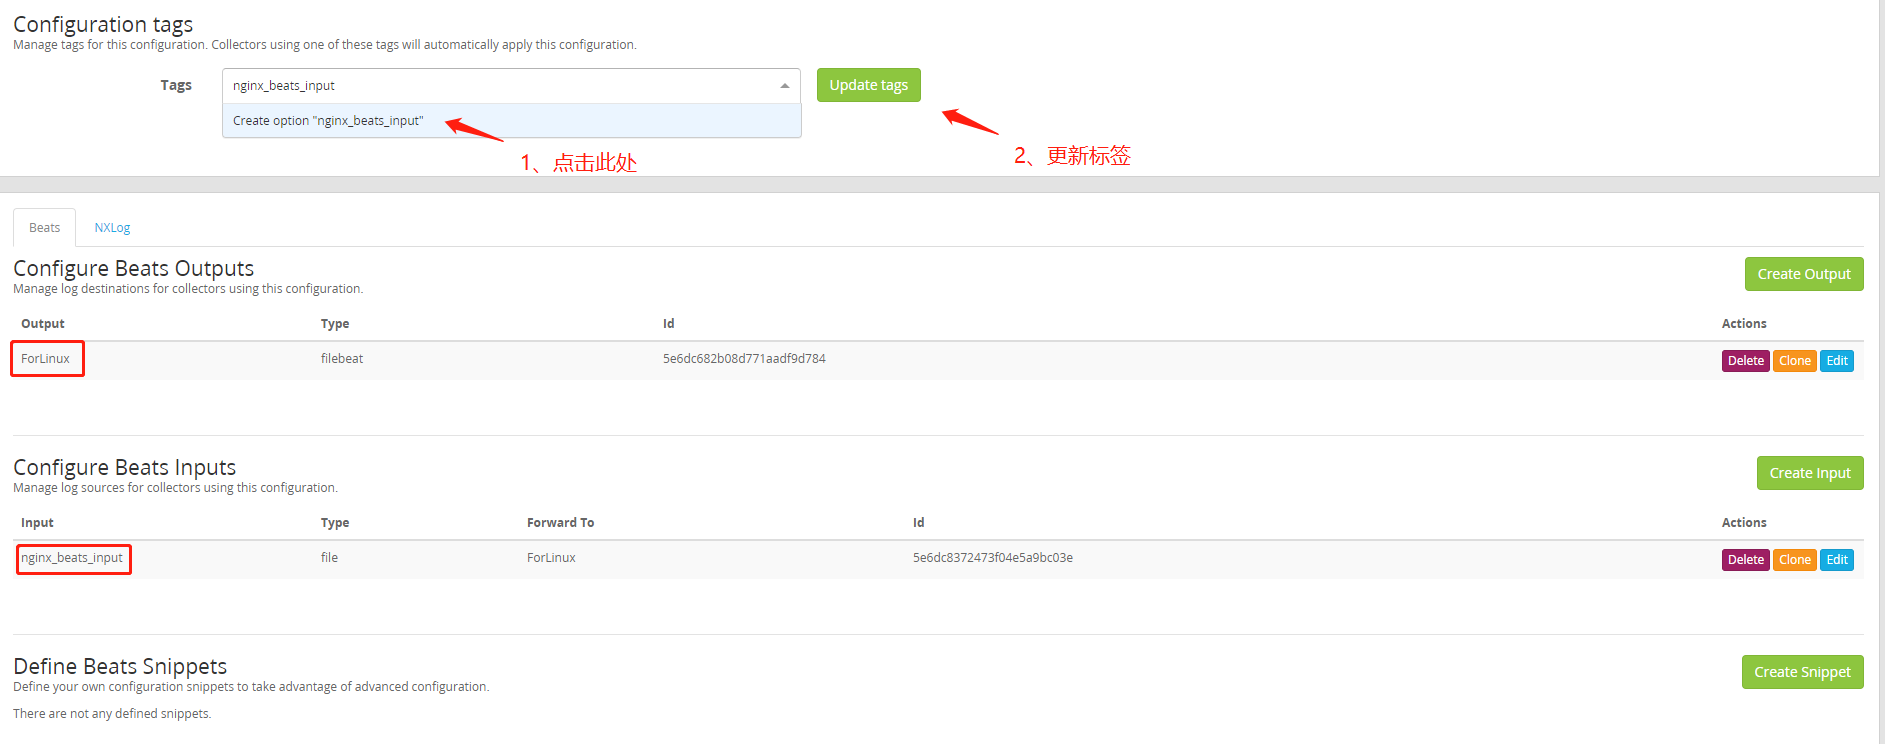
(7)保存好Beats Input之后不要忘记把创建好的tag进行Update tags,否则客户端将找不到这个tag。以上graylog服务器端的配置就都完成了。
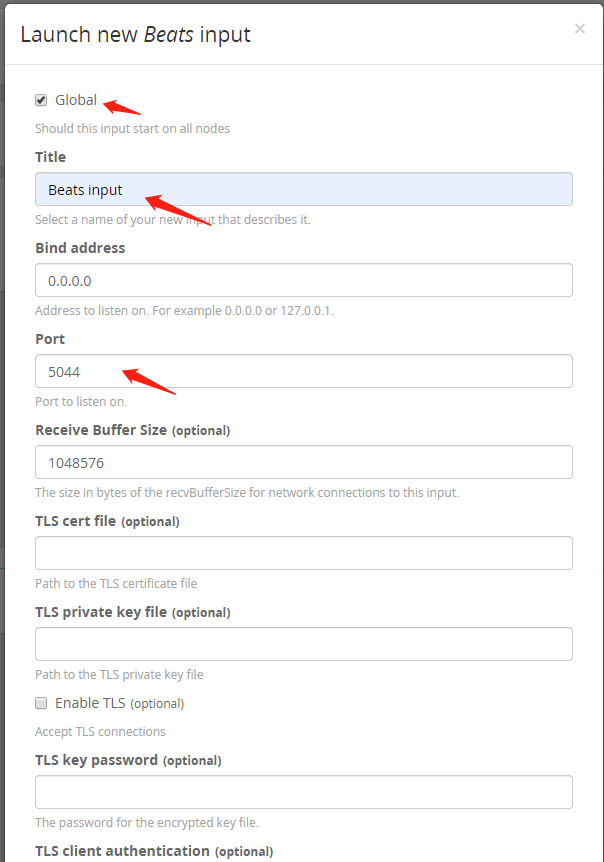
(8)graylog创建日志接收的Input 5044端口,导航栏System/Inputs -> Inputs ,在复选框里选择Beats,点击Launch new input

(9)如果你是garylog集群,选择Global,也就是在每个节点都启动5044端口,Title起个名字叫Beats input,端口保持默tcp 5044,最后点击save保存
(10)我们开始进行客户端的安装,我们以Ubuntu16.04为例,假设graylog服务器ip为192.168.252.10,nginx服务器主机名为nginx1:
1、在nginx1服务器上下载并安装collector-sidecar
wget https://github.com/Graylog2/collector-sidecar/releases/download/0.1.8/collector-sidecar_0.1.8-1_amd64.deb
sudo /usr/bin/dpkg -i collector-sidecar_0.1.8-1_amd64.deb
sudo /usr/bin/graylog-collector-sidecar -service install
sudo systemctl enable collector-sidecar.service
2、编辑collector-sidecar配置文件:
vi /etc/graylog/collector-sidecar/collector_sidecar.yml
server_url: http://192.168.252.10:9000/api/
node_id: nginx1
update_interval: 10
tls_skip_verify: false
send_status: true
list_log_files:
collector_id: file:/etc/graylog/collector-sidecar/collector-id
cache_path: /var/cache/graylog/collector-sidecar
log_path: /var/log/graylog/collector-sidecar
log_rotation_time: 86400
log_max_age: 604800
tags:
    - nginx_beats_input
backends:
    - name: nxlog
      enabled: false
      binary_path: /usr/bin/nxlog
      configuration_path: /etc/graylog/collector-sidecar/generated/nxlog.conf
    - name: filebeat
      enabled: true
      binary_path: /usr/bin/filebeat
      configuration_path: /etc/graylog/collector-sidecar/generated/filebeat.yml
service collector-sidecar restart
3、查看collector-sidecar的日志
tail -f /var/log/graylog/collector-sidecar/collector_sidecar.log

[日志分析]Graylog2采集Nginx日志 主动方式的更多相关文章
- [日志分析]Graylog2采集Nginx日志 被动方式
graylog可以通过两种方式采集nginx日志,一种是通过Graylog Collector Sidecar进行采集(主动方式),另外是通过修改nginx配置文件的方式进行收集(被动方式). 这次说 ...
- [日志分析]Graylog2采集mysql慢日志
之前聊了一下graylog如何采集nginx日志,为此我介绍了两种采集方法(主动和被动),让大家对graylog日志采集有了一个大致的了解. 从日志收集这个角度,graylog提供了多样性和灵活性,大 ...
- [日志分析]Graylog2进阶 通过正则解析Nginx日志
之前分享的 [日志分析]Graylog2采集Nginx日志 主动方式 这篇文章介绍了Graylog如何通过Graylog Collector Sidecar来采集nginx日志. 由于日志是未经处理的 ...
- elk系列3之通过json格式采集Nginx日志【转】
转自 elk系列3之通过json格式采集Nginx日志 - 温柔易淡 - 博客园http://www.cnblogs.com/liaojiafa/p/6158245.html preface 公司采用 ...
- Centos7 搭建 Flume 采集 Nginx 日志
版本信息 CentOS: Linux localhost.localdomain 3.10.0-862.el7.x86_64 #1 SMP Fri Apr 20 16:44:24 UTC 2018 x ...
- 通过filebeat、logstash、rsyslog采集nginx日志的几种方式
由于nginx功能强大,性能突出,越来越多的web应用采用nginx作为http和反向代理的web服务器.而nginx的访问日志不管是做用户行为分析还是安全分析都是非常重要的数据源之一.如何有效便捷的 ...
- [日志分析]Graylog2进阶之获取Nginx来源IP的地理位置信息
如果你们觉得graylog只是负责日志收集的一个管理工具,那就too young too naive .日志收集只是graylog的最最基础的用法,graylog有很多实用的数据清洗和处理的进阶用法. ...
- elk系列3之通过json格式采集Nginx日志
preface 公司采用的LNMP平台,跑着挺多nginx,所以可以利用elk好好分析nginx的日志.下面就聊聊它吧. 下面的所有操作都在linux-node2上操作 安装Nginx nginx是开 ...
- Flume采集Nginx日志到HDFS
下载apache-flume-1.7.0-bin.tar.gz,用 tar -zxvf 解压,在/etc/profile文件中增加设置: export FLUME_HOME=/opt/apache-f ...
随机推荐
- JarvisOJ level3_x64
这一题是和前面x86的差不多,都是利用了同一个知识点,唯一的区别就是使用的堆栈地址不同,x86是直接使用堆栈来传递参数的,而x64不同 x64的函数调用时整数和指针参数按照从左到右的顺序依次保存在寄存 ...
- python3下scrapy爬虫(第二卷:初步抓取网页内容之直接抓取网页)
上一卷中介绍了安装过程,现在我们开始使用这个神奇的框架 跟很多博主一样我也先选择一个非常好爬取的网站作为最初案例,那么我先用屌丝必备网站http://www.shaimn.com/xinggan/作为 ...
- 洛谷 P1220 关路灯 题解
Description 有 $n$ 盏路灯,每盏路灯有坐标(单位 $m$)和功率(单位 $J$).从第 $c$ 盏路灯开始,可以向左或向右关闭路灯.速度是 $1m/s$.求所有路灯的最少耗电.输入保证 ...
- PHP 全局使用 Laravel 辅助函数 dd
dump() 方法 全局 composer.json 12345 "require": { "squizlabs/php_codesniffer": " ...
- github hexo配置踩过的坑
大体步骤:配置npm,在github中增加自己的sshkey. 多sshkey的话在用户主目录的.ssh中要配置好. 删除仓库里面 source/_posts/我的文章.md 执行下面命令更新博客 h ...
- diary20180428
17:05:59 今天早晨去了图书馆.学习了一把vscode.试图在河边看电脑,总有小虫不让我专心. 23:27:34 看纯黑直播打战神,有点感触. 动漫或游戏,角色觉醒,实力大增,小时候(甚至现在) ...
- JavaScript学习总结之数组常用的方法和属性
先点赞后关注,防止会迷路寄语:没有一个冬天不会过去,没有一个春天不会到来. 前言数组常用的属性和方法常用属性返回数组的大小常用方法栈方法队列方法重排序方法操作方法转换方法迭代方法归并方法总结结尾 前言 ...
- Maven使用和配置
Maven使用和配置 一.maven安装和概念 maven安装 maven编译(compile) 执行测试用例(test) maven打包(package) maven依赖管理 1.maven安装 官 ...
- jenkins-设置定时任务
前言 跑自动化用例每次用手工点击 jenkins 出发自动化用例太麻烦了,我们希望能每天固定时间 跑,这样就不用管了,坐等收测试报告结果就行. 一.定时构建语法 * * * * * (五颗星,中间用 ...
- 基于 HTML5 Canvas 的 3D 热力云图效果
前言 数据蕴藏价值,但数据的价值需要用 IT 技术去发现.探索,可视化可以帮助人更好的去分析数据,信息的质量很大程度上依赖于其呈现方式.在数据分析上,热力图无疑是一种很好的方式.在很多行业中都有着广泛 ...