
[日志分析]Graylog2进阶 通过正则解析Nginx日志
之前分享的 [日志分析]Graylog2采集Nginx日志 主动方式 这篇文章介绍了Graylog如何通过Graylog Collector Sidecar来采集nginx日志。
由于日志是未经处理的,所以类似$remote_addr $request_time $upstream_addr $upstream_response_time的字段并没有解析出来,而是都显示在默认的message中,很不利于我们今后的分析工作。
为了解决这个问题,就引入了graylog另一个非常强大的功能 Extractors ,Extractors 翻译过来叫提取器,顾名思义,就是将原始日志的各个字段通过正则匹配的方式提取并保存到相对应的字段中。
针对这次nginx的字段提取,我着重讲一下Extractors的Grok pattern用法。这是日常生产处理原始日志 ,最常用的一种方式。
(1)先去查看nginx配置文件的log_format选项:
log_format access '$remote_addr - [$time_local] $request_time $upstream_addr $upstream_response_time "$request_method $scheme://$host$request_uri" $status $body_bytes_sent "$http_referer" "$http_user_agent" "$http_x_forwarded_for"';
(2)根据log_format的输出格式编写相应的正则表达式,简单讲解一下以^%{IP:remote_addr} 为例,^代表日志开头,大括号里面的IP代表名为IP的grok pattern,可以在System/Grok pattern中查到,冒号后边就是你要存储的字段名称为remote_addr 。
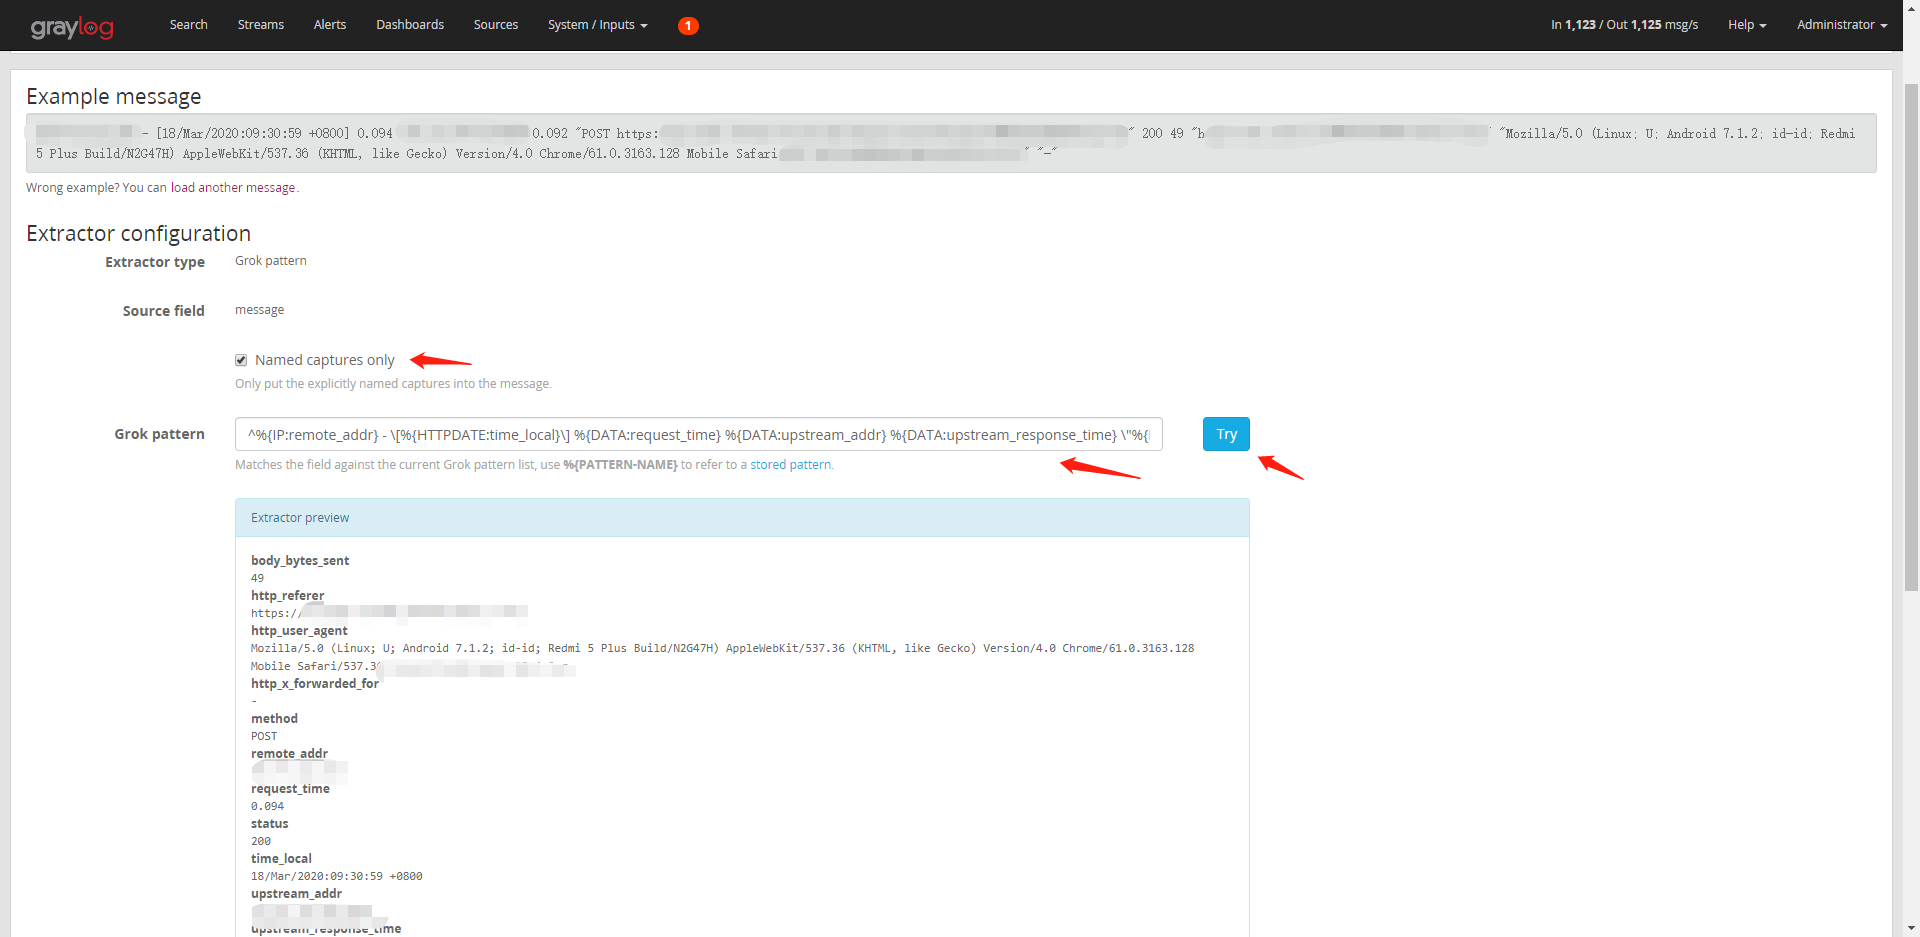
^%{IP:remote_addr} - \[%{HTTPDATE:time_local}\] %{DATA:request_time} %{DATA:upstream_addr} %{DATA:upstream_response_time} \"%{NOTSPACE:method} %{NOTSPACE:url}\" %{NOTSPACE:status} %{DATA:body_bytes_sent} %{DATA:http_referer} \"%{DATA:http_user_agent}\"\s+\"%{DATA:http_x_forwarded_for}\"
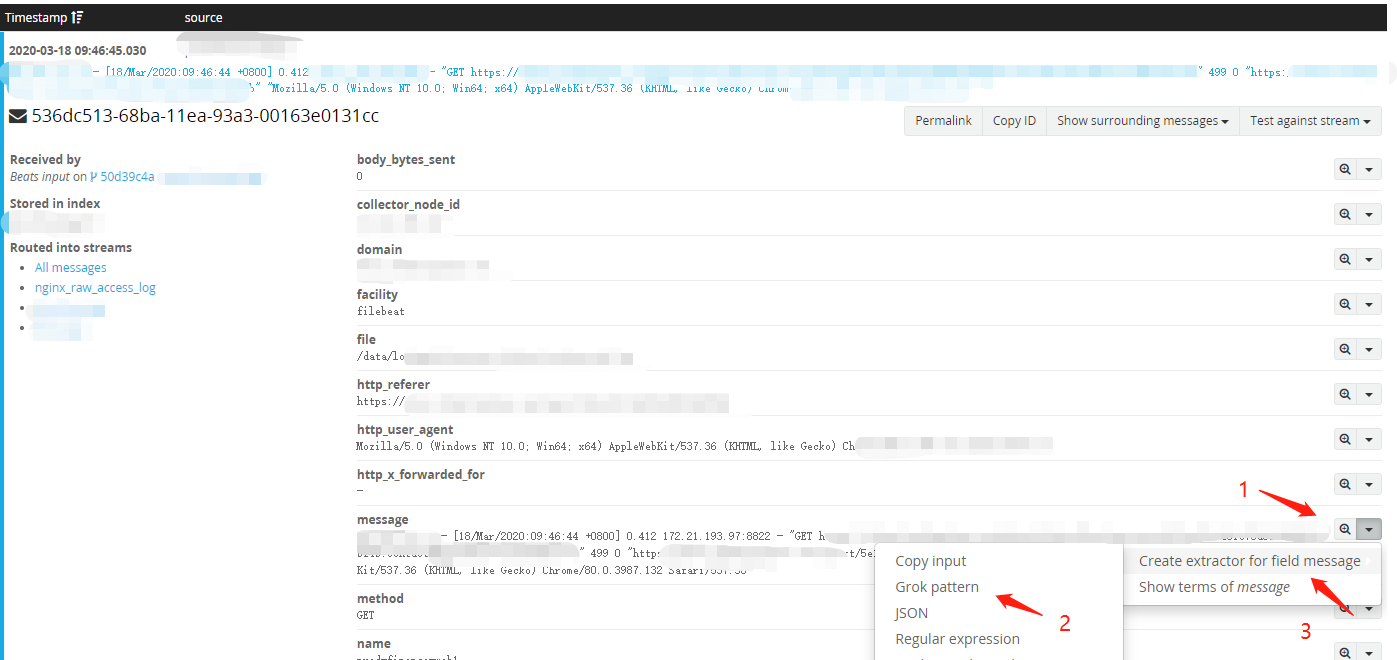
(3) 在导航栏Search 选择一条nginx日志,在message字段右边,点击小三角选择 Grok pattern -> Creat extractor for field message 到Extractors 页面。
(2)选中Named captures only复选框,Grok pattern填入正则,点击Try可以看到解析后的笑果,相应的字段已经解析出来了。
[日志分析]Graylog2进阶 通过正则解析Nginx日志的更多相关文章
- [日志分析]Graylog2进阶之获取Nginx来源IP的地理位置信息
如果你们觉得graylog只是负责日志收集的一个管理工具,那就too young too naive .日志收集只是graylog的最最基础的用法,graylog有很多实用的数据清洗和处理的进阶用法. ...
- [日志分析]Graylog2采集Nginx日志 主动方式
这次聊一下Graylog如何主动采集Nginx日志,分成两部分: 介绍一下 Graylog Collector Sidecar 是什么 如何配置 Graylog Collector Sidecar 采 ...
- [日志分析]Graylog2采集Nginx日志 被动方式
graylog可以通过两种方式采集nginx日志,一种是通过Graylog Collector Sidecar进行采集(主动方式),另外是通过修改nginx配置文件的方式进行收集(被动方式). 这次说 ...
- [日志分析]Graylog2采集mysql慢日志
之前聊了一下graylog如何采集nginx日志,为此我介绍了两种采集方法(主动和被动),让大家对graylog日志采集有了一个大致的了解. 从日志收集这个角度,graylog提供了多样性和灵活性,大 ...
- Logstash使用grok插件解析Nginx日志
grok表达式的打印复制格式的完整语法是下面这样的: %{PATTERN_NAME:capture_name:data_type}data_type 目前只支持两个值:int 和 float. 在线g ...
- ELK+Redis 解析Nginx日志
一.ELK简介 Elk是指logstash,elasticsearch,kibana三件套,我们一般使用它们做日志分析. ELK工作原理图: 简单来讲ELK具体的工作流程就是客户端的logstash ...
- Goaccess解析nginx日志备忘
参考 http://nginx.org/en/docs/http/ngx_http_log_module.html?&_ga=1.92028562.949762386.1481787781#l ...
- 我的日志分析之道:简单的Web日志分析脚本
前言 长话短说,事情的起因是这样的,由于工作原因需要分析网站日志,服务器是windows,iis日志,在网上找了找,github找了找,居然没找到,看来只有自己动手丰衣足食. 那么分析方法我大致可分为 ...
- python 解析nginx 日志 url
>>> import os>>> os.chdir('e:/')>>> log=open('access.log')//这两行是获取日志流> ...
随机推荐
- RAM子账户登录DMS对库进行管理
前言:阿里云账户是个权限很大的账户,有时候为了不让更多的人知道,但是又必须让别人管理里面某个模块的功能的时候,RAM子账户就显得很重要,所以设置子账户的权限就很有必要了,下面简单设置两种权限(dms上 ...
- 【阅读笔记】rocketmq 概念与架构 (一)
介绍 rocketmq 框架与基本概念 1. 概念 1.1 namesrv(name server) 记录了 broker 集群信息,消息队列的信息以及 key-value 配置,见 RouteInf ...
- chap1-HttpRequest测试类
# HttpRequest测试类, 封装请求方法 import requests class HttpRequest: def http_request(self, url, method, data ...
- 吴裕雄--天生自然HTML学习笔记:HTML 统一资源定位器(Uniform Resource Locators)
URL 是一个网页地址. URL可以由字母组成,如"runoob.com",或互联网协议(IP)地址: 192.68.20.50.大多数人进入网站使用网站域名来访问,因为 名字比数 ...
- 从广义线性模型(GLM)理解逻辑回归
1 问题来源 记得一开始学逻辑回归时候也不知道当时怎么想得,很自然就接受了逻辑回归的决策函数--sigmod函数: 与此同时,有些书上直接给出了该函数与将 $y$ 视为类后验概率估计 $p(y=1|x ...
- [PyTorch入门]之从示例中学习PyTorch
Learning PyTorch with examples 来自这里. 本教程通过自包含的示例来介绍PyTorch的基本概念. PyTorch的核心是两个主要功能: 可在GPU上运行的,类似于num ...
- 《Java 8实战》读书笔记系列——第三部分:高效Java 8编程(四):使用新的日期时间API
https://www.lilu.org.cn/https://www.lilu.org.cn/ 第十二章:新的日期时间API 在Java 8之前,我们常用的日期时间API是java.util.Dat ...
- python爬虫-smtplib模块发送邮件
1.代码如下: import smtplib from email.message from EmailMessage # smtplib模块负责发送邮件服务 # email.message模块负责构 ...
- ASP.NET CORE 管道模型及中间件使用解读
说到ASP.NET CORE 管道模型不得不先来看看之前的ASP.NET 的管道模型,两者差异很大,.NET CORE 3.1 后完全重新设计了框架的底层,.net core 3.1 的管道模型更加灵 ...
- 面试题57-II.和为s的连续正数序列
面试题57-II.和为s的连续正数序列 1.题目 LeetCode-面试题57-II.和为s的连续正数序列 输入一个正整数 target ,输出所有和为 target 的连续正整数序列(至少含有两个数 ...