
<强化学习>基本概念
马尔可夫决策过程MDP,是强化学习的基础。
MDP --- <S,A,P,R,γ>
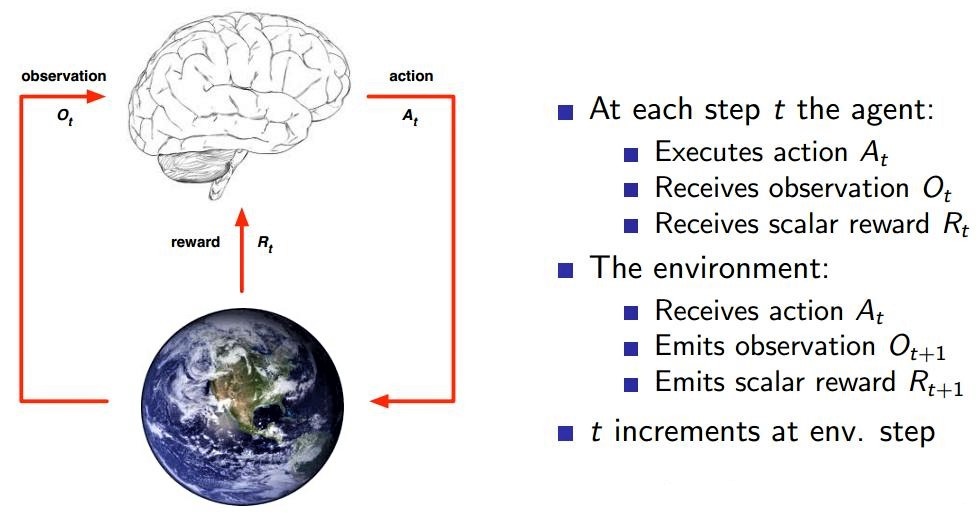
AGENT
STATE
ENV
REWARD ,由ENV给出。agent处于状态s下,采取action之后离开状态获得一个reward。即f:S x A --->R
所有强化学习问题解决的目标都可以描述成最大化累积奖励。All goals can be described by the maximisation of expected cumulative reward。即我们的目标是最大化Gt 。

ACTION ,离散分布,或者连续分布。
POLICY ,策略。 π :S x A --->[0,1]
|——Deterministic policy: a = π(s)
|——Stochastic policy: π(a|s) = P[At = a|St = s] //一个典型的随机策略 e-greedy policy derived from Q
VALUE ,a prediction of future reward; 形象地说AGENT.VALUE是agent对env的感觉,这样好,那样不好,对这个感到舒服,对那个感到upside
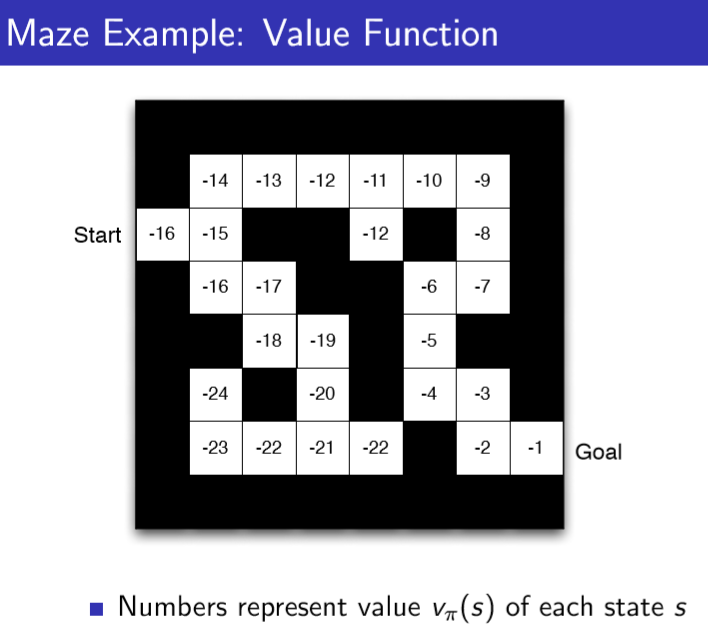
|——state value V(s),表示State好坏的量。V(s)的值代表了State s的好坏。好坏是对于未来reward累积而言的。
| 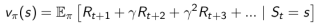
|——state-action value Q(s,a),
| 
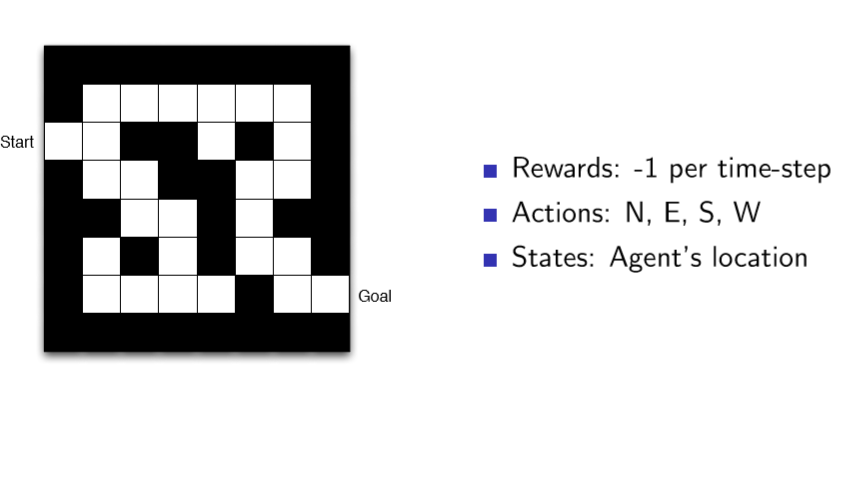
下面是一个”迷宫游戏“的例子:

以及算法中基本上用不到的概念Model,我们也给画出来:

History & Observation & State三个概念辩解:
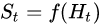
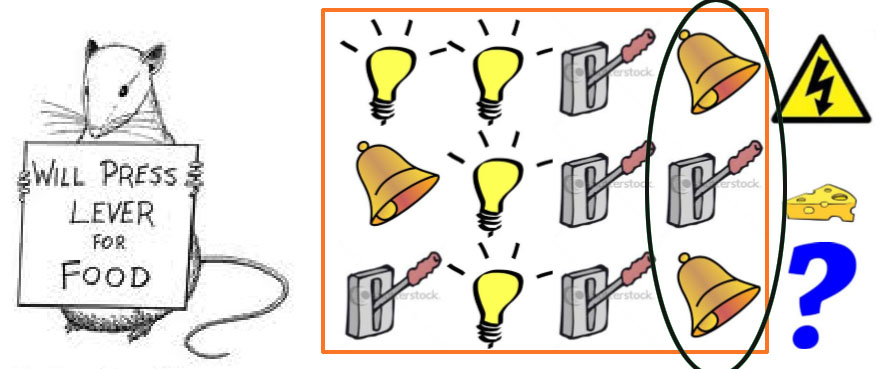
如下图中,红框为History,黑圈为Observation。
至于State,要看f()是如何定义的,St = f(Ht),f()是我们人为定义的。
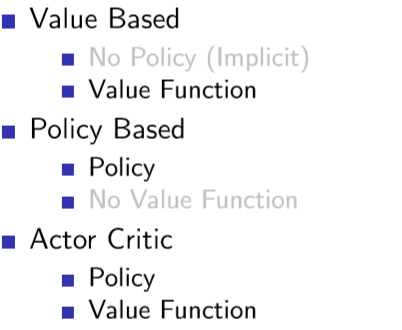
AGENT分为以下三类:
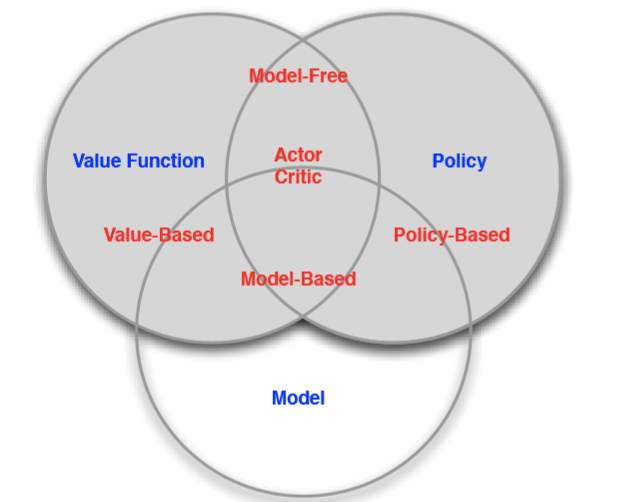
Model free和Model based辩解:
我们进一步把RL算法分为Model free和Model based两类。
Model based算法需要全知env,或者说已知Reward(s,a) for any (s,a)
Model free算法不需要全知env。
<强化学习>基本概念的更多相关文章
- 分布式强化学习基础概念(Distributional RL )
分布式强化学习基础概念(Distributional RL) from: https://mtomassoli.github.io/2017/12/08/distributional_rl/ 1. Q ...
- 深度强化学习资料(视频+PPT+PDF下载)
https://blog.csdn.net/Mbx8X9u/article/details/80780459 课程主页:http://rll.berkeley.edu/deeprlcourse/ 所有 ...
- 深度强化学习day01初探强化学习
深度强化学习 基本概念 强化学习 强化学习(Reinforcement Learning)是机器学习的一个重要的分支,主要用来解决连续决策的问题.强化学习可以在复杂的.不确定的环境中学习如何实现我们设 ...
- 深度强化学习(DQN-Deep Q Network)之应用-Flappy Bird
深度强化学习(DQN-Deep Q Network)之应用-Flappy Bird 本文系作者原创,转载请注明出处:https://www.cnblogs.com/further-further-fu ...
- Deep Learning专栏--强化学习之MDP、Bellman方程(1)
本文主要介绍强化学习的一些基本概念:包括MDP.Bellman方程等, 并且讲述了如何从 MDP 过渡到 Reinforcement Learning. 1. 强化学习基本概念 这里还是放上David ...
- 【强化学习】MOVE37-Introduction(导论)/马尔科夫链/马尔科夫决策过程
写在前面的话:从今日起,我会边跟着硅谷大牛Siraj的MOVE 37系列课程学习Reinforcement Learning(强化学习算法),边更新这个系列.课程包含视频和文字,课堂笔记会按视频为单位 ...
- 李宏毅强化学习完整笔记!开源项目《LeeDeepRL-Notes》发布
Datawhale开源 核心贡献者:王琦.杨逸远.江季 提起李宏毅老师,熟悉强化学习的读者朋友一定不会陌生.很多人选择的强化学习入门学习材料都是李宏毅老师的台大公开课视频. 现在,强化学习爱好者有更完 ...
- 【强化学习RL】必须知道的基础概念和MDP
本系列强化学习内容来源自对David Silver课程的学习 课程链接http://www0.cs.ucl.ac.uk/staff/D.Silver/web/Teaching.html 之前接触过RL ...
- 强化学习(一)—— 基本概念及马尔科夫决策过程(MDP)
1.策略与环境模型 强化学习是继监督学习和无监督学习之后的第三种机器学习方法.强化学习的整个过程如下图所示: 具体的过程可以分解为三个步骤: 1)根据当前的状态 $s_t$ 选择要执行的动作 $ a_ ...
随机推荐
- C# 篇基础知识10——多线程
1.线程的概念 单核CPU的计算机中,一个时刻只能执行一条指令,操作系统以“时间片轮转”的方式实现多个程序“同时”运行.操作系统以进程(Process)的方式运行应用程序,进程不但包括应用程序的指令流 ...
- AngularJs 禁止模板缓存
因为AngularJs的特性(or 浏览器本身的缓存?),angular默认的HTML模板加载都会被缓存起来.导致每次修改完模板之后都得经常需要清除浏览器的缓存来保证浏览器去获得最新的html模板,自 ...
- Angularjs中controller的三种写法
在Angular中,Directive.Service.Filter.Controller都是以工厂方法的方式给出,而工厂方法的参数名对应着该工厂方法依赖的Service.angularjs中cont ...
- NO32 网络层次及OSI7层模型--TCP三次握手四次断开--子网划分
网络层次: OIS网络模型概念: OSI层次--应用层: OSI层次--表示层: OSI--会话层: OSI--传输层: OSI--网络层: IP地址的概念说明: OSI数据链路层: OSI= ...
- hadoop-mapreduce的官方示例的测试执行方法
1.根据给出的精度参数计算 pi : hadoop jar /export/servers/hadoop-2.6.0-cdh5.14.0/share/hadoop/mapreduce/hadoop-m ...
- GoJS实例3
复制如下内容保存到空白的.html文件中,用浏览器打开即可查看效果 <!DOCTYPE html> <html> <head> <meta charset=& ...
- centos7 程序快捷方式
/usr/share/Applications 在此文件夹中,全是".desktop"的文件,利用终端打开一个看看就知道了!
- Java连载68-数组的拷贝、二维数组
一.数组的拷贝 函数arraycopy(),参数为:源数组.源数组的开始下标.目标数组.目标数组的开始下标.拷贝长度 package com.bjpowernode.java_learning; ...
- UVA - 712 S-Trees(S树)
题意:0往左走,1往右走,已知所有叶子的值,每个查询都是根结点到叶子结点的路径,路径的每一个点分别对应着x1,x2,x3……但是实际上的S树的路径可能并非是x1,x2,x3…… 分析:先存路径变量的顺 ...
- 51nod 1437:迈克步 单调栈基础题
1437 迈克步 题目来源: CodeForces 基准时间限制:1 秒 空间限制:131072 KB 分值: 80 难度:5级算法题 收藏 取消关注 有n只熊.他们站成一排队伍,从左到右依次1到 ...