
HiBench成长笔记——(4) HiBench测试Spark SQL
很多内容之前的博客已经提过,这里不再赘述,详细内容参照本系列前面的博客:https://www.cnblogs.com/ratels/p/10970905.html 和 https://www.cnblogs.com/ratels/p/10976060.html
执行脚本
bin/workloads/sql/scan/prepare/prepare.sh
返回信息
[root@node1 prepare]# ./prepare.sh
patching args=
Parsing conf: /home/cf/app/HiBench-master/conf/hadoop.conf
Parsing conf: /home/cf/app/HiBench-master/conf/hibench.conf
Parsing conf: /home/cf/app/HiBench-master/conf/spark.conf
Parsing conf: /home/cf/app/HiBench-master/conf/workloads/sql/scan.conf
probe -.cdh5./lib/hadoop/../../jars/hadoop-mapreduce-client-jobclient--cdh5.14.2-tests.jar
start HadoopPrepareScan bench
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -rm -r -skipTrash hdfs://node1:8020/HiBench/Scan/Input
rm: `hdfs://node1:8020/HiBench/Scan/Input': No such file or directory
Pages:, USERVISITS:
Submit MapReduce Job: /opt/cloudera/parcels/CDH--.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn jar /home/cf/app/HiBench-master/autogen/target/autogen-7.1-SNAPSHOT-jar-with-dependencies.jar HiBench.DataGen -t hive -b hdfs://node1:8020/HiBench/Scan -n Input -m 8 -r 8 -p 120 -v 1000 -o sequence
// :: INFO HiBench.HiveData: Closing hive data generator...
finish HadoopPrepareScan bench

执行脚本
bin/workloads/sql/scan/spark/run.sh
返回信息
[root@node1 spark]# ./run.sh
patching args=
Parsing conf: /home/cf/app/HiBench-master/conf/hadoop.conf
Parsing conf: /home/cf/app/HiBench-master/conf/hibench.conf
Parsing conf: /home/cf/app/HiBench-master/conf/spark.conf
Parsing conf: /home/cf/app/HiBench-master/conf/workloads/sql/scan.conf
probe -.cdh5./lib/hadoop/../../jars/hadoop-mapreduce-client-jobclient--cdh5.14.2-tests.jar
start ScalaSparkScan bench
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -rm -r -skipTrash hdfs://node1:8020/HiBench/Scan/Output
rm: `hdfs://node1:8020/HiBench/Scan/Output': No such file or directory
Export env: SPARKBENCH_PROPERTIES_FILES=/home/cf/app/HiBench-master/report/scan/spark/conf/sparkbench/sparkbench.conf
Export env: HADOOP_CONF_DIR=/etc/hadoop/conf.cloudera.yarn
Submit Spark job: /opt/cloudera/parcels/CDH--.cdh5./lib/spark/bin/spark-submit  --properties- --executor-cores  --executor-memory 4g /home/cf/app/HiBench-master/sparkbench/assembly/target/sparkbench-assembly-7.1-SNAPSHOT-dist.jar ScalaScan /home/cf/app/HiBench-master/report/scan/spark/conf/../rankings_uservisits_scan.hive
// :: INFO CuratorFrameworkSingleton: Closing ZooKeeper client.
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -du -s hdfs://node1:8020/HiBench/Scan/Output
finish ScalaSparkScan bench

查看ResourceManager Web UI
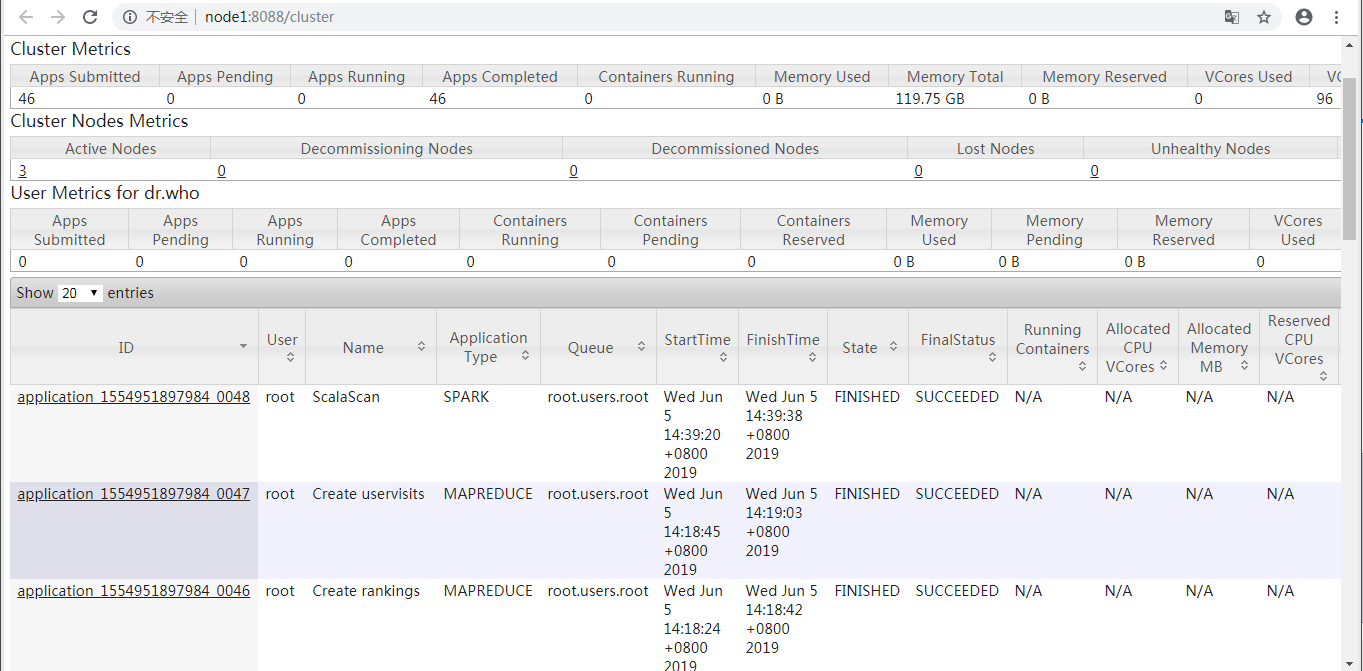
prepare.sh启动了application_1554951897984_0047和application_1554951897984_0046两个MAPREDUCE任务,run.sh启动了application_1554951897984_0048这个Spark任务。
查看(Hadoop)HistoryServer Web UI
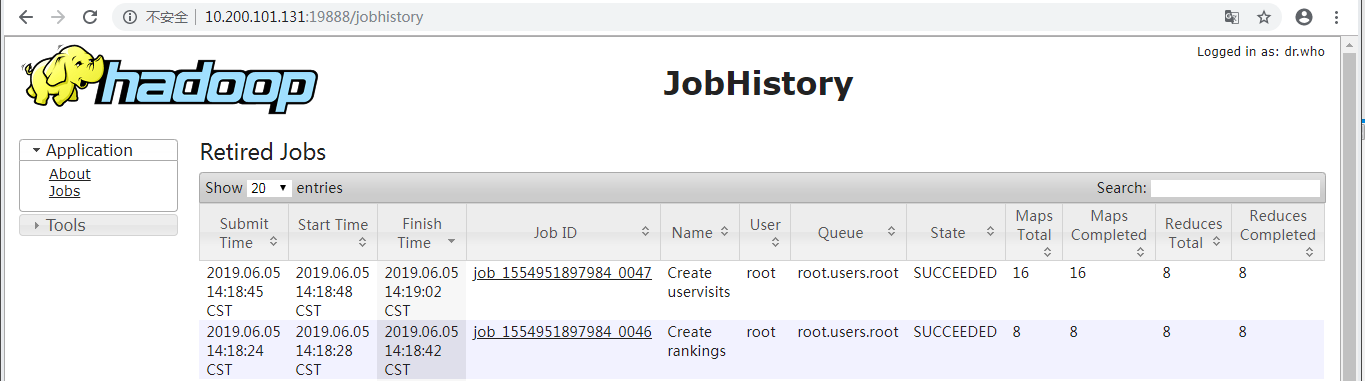
显示了prepare.sh启动的application_1554951897984_0047和application_1554951897984_0046两个MAPREDUCE任务。
查看(Spark) History Server Web UI
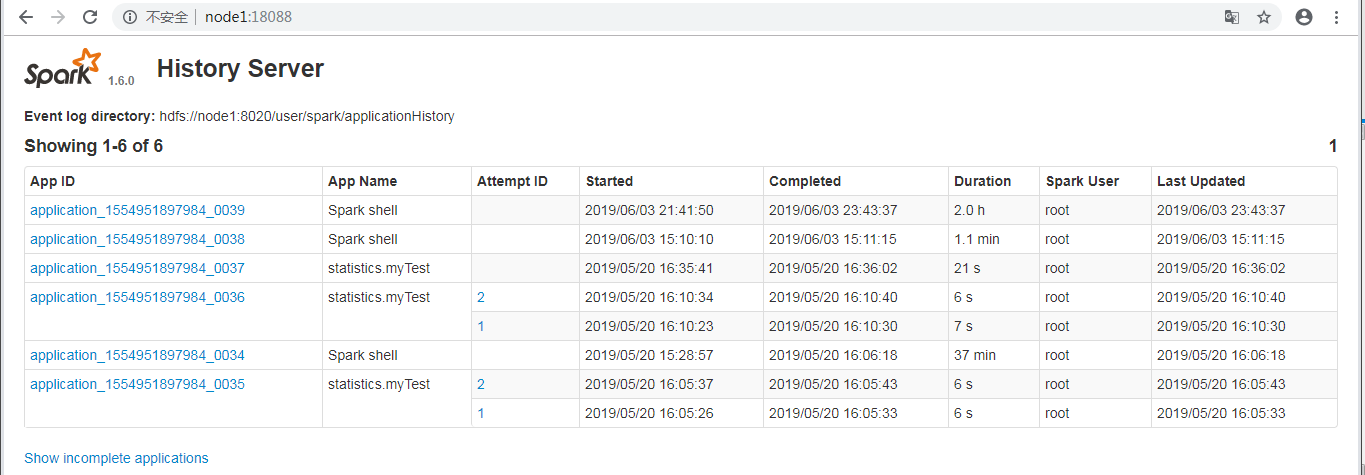
并未显示run.sh启动的application_1554951897984_0048这个Spark任务。
执行脚本
bin/workloads/sql/join/prepare/prepare.sh
返回信息
[root@node1 prepare]# ./prepare.sh
patching args=
Parsing conf: /home/cf/app/HiBench-master/conf/hadoop.conf
Parsing conf: /home/cf/app/HiBench-master/conf/hibench.conf
Parsing conf: /home/cf/app/HiBench-master/conf/spark.conf
Parsing conf: /home/cf/app/HiBench-master/conf/workloads/sql/join.conf
probe -.cdh5./lib/hadoop/../../jars/hadoop-mapreduce-client-jobclient--cdh5.14.2-tests.jar
start HadoopPrepareJoin bench
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -rm -r -skipTrash hdfs://node1:8020/HiBench/Join/Input
rm: `hdfs://node1:8020/HiBench/Join/Input': No such file or directory
Pages:, USERVISITS:
Submit MapReduce Job: /opt/cloudera/parcels/CDH--.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn jar /home/cf/app/HiBench-master/autogen/target/autogen-7.1-SNAPSHOT-jar-with-dependencies.jar HiBench.DataGen -t hive -b hdfs://node1:8020/HiBench/Join -n Input -m 8 -r 8 -p 120 -v 1000 -o sequence
// :: INFO HiBench.HiveData: Closing hive data generator...
finish HadoopPrepareJoin bench
执行脚本
bin/workloads/sql/join/spark/run.sh
返回信息
[root@node1 spark]# ./run.sh
patching args=
Parsing conf: /home/cf/app/HiBench-master/conf/hadoop.conf
Parsing conf: /home/cf/app/HiBench-master/conf/hibench.conf
Parsing conf: /home/cf/app/HiBench-master/conf/spark.conf
Parsing conf: /home/cf/app/HiBench-master/conf/workloads/sql/join.conf
probe -.cdh5./lib/hadoop/../../jars/hadoop-mapreduce-client-jobclient--cdh5.14.2-tests.jar
start ScalaSparkJoin bench
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -du -s hdfs://node1:8020/HiBench/Join/Input
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -rm -r -skipTrash hdfs://node1:8020/HiBench/Join/Output
rm: `hdfs://node1:8020/HiBench/Join/Output': No such file or directory
Export env: SPARKBENCH_PROPERTIES_FILES=/home/cf/app/HiBench-master/report/join/spark/conf/sparkbench/sparkbench.conf
Export env: HADOOP_CONF_DIR=/etc/hadoop/conf.cloudera.yarn
Submit Spark job: /opt/cloudera/parcels/CDH--.cdh5./lib/spark/bin/spark-submit  --properties- --executor-cores  --executor-memory 4g /home/cf/app/HiBench-master/sparkbench/assembly/target/sparkbench-assembly-7.1-SNAPSHOT-dist.jar ScalaJoin /home/cf/app/HiBench-master/report/join/spark/conf/../rankings_uservisits_join.hive
// :: INFO remote.RemoteActorRefProvider$RemotingTerminator: Remote daemon shut down; proceeding with flushing remote transports.
finish ScalaSparkJoin bench
执行脚本
bin/workloads/sql/aggregation/prepare/prepare.sh
返回信息
[root@node1 prepare]# ./prepare.sh
patching args=
Parsing conf: /home/cf/app/HiBench-master/conf/hadoop.conf
Parsing conf: /home/cf/app/HiBench-master/conf/hibench.conf
Parsing conf: /home/cf/app/HiBench-master/conf/spark.conf
Parsing conf: /home/cf/app/HiBench-master/conf/workloads/sql/aggregation.conf
probe -.cdh5./lib/hadoop/../../jars/hadoop-mapreduce-client-jobclient--cdh5.14.2-tests.jar
start HadoopPrepareAggregation bench
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -rm -r -skipTrash hdfs://node1:8020/HiBench/Aggregation/Input
rm: `hdfs://node1:8020/HiBench/Aggregation/Input': No such file or directory
Pages:, USERVISITS:
Submit MapReduce Job: /opt/cloudera/parcels/CDH--.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn jar /home/cf/app/HiBench-master/autogen/target/autogen-7.1-SNAPSHOT-jar-with-dependencies.jar HiBench.DataGen -t hive -b hdfs://node1:8020/HiBench/Aggregation -n Input -m 8 -r 8 -p 120 -v 1000 -o sequence
// :: INFO HiBench.HiveData: Closing hive data generator...
finish HadoopPrepareAggregation bench
执行脚本
bin/workloads/sql/aggregation/spark/run.sh
返回信息
[root@node1 spark]# ./run.sh
patching args=
Parsing conf: /home/cf/app/HiBench-master/conf/hadoop.conf
Parsing conf: /home/cf/app/HiBench-master/conf/hibench.conf
Parsing conf: /home/cf/app/HiBench-master/conf/spark.conf
Parsing conf: /home/cf/app/HiBench-master/conf/workloads/sql/aggregation.conf
probe -.cdh5./lib/hadoop/../../jars/hadoop-mapreduce-client-jobclient--cdh5.14.2-tests.jar
start ScalaSparkAggregation bench
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -rm -r -skipTrash hdfs://node1:8020/HiBench/Aggregation/Output
rm: `hdfs://node1:8020/HiBench/Aggregation/Output': No such file or directory
Export env: SPARKBENCH_PROPERTIES_FILES=/home/cf/app/HiBench-master/report/aggregation/spark/conf/sparkbench/sparkbench.conf
Export env: HADOOP_CONF_DIR=/etc/hadoop/conf.cloudera.yarn
Submit Spark job: /opt/cloudera/parcels/CDH--.cdh5./lib/spark/bin/spark-submit  --properties- --executor-cores  --executor-memory 4g /home/cf/app/HiBench-master/sparkbench/assembly/target/sparkbench-assembly-7.1-SNAPSHOT-dist.jar ScalaAggregation /home/cf/app/HiBench-master/report/aggregation/spark/conf/../uservisits_aggre.hive
// :: INFO remote.RemoteActorRefProvider$RemotingTerminator: Remote daemon shut down; proceeding with flushing remote transports.
hdfs -.cdh5./bin/hadoop --config /etc/hadoop/conf.cloudera.yarn fs -du -s hdfs://node1:8020/HiBench/Aggregation/Output
finish ScalaSparkAggregation bench
参考:https://www.cnblogs.com/barneywill/p/10436299.html
HiBench成长笔记——(4) HiBench测试Spark SQL的更多相关文章
- HiBench成长笔记——(1) HiBench概述
测试分类 HiBench共计19个测试方向,可大致分为6个测试类别:分别是micro,ml(机器学习),sql,graph,websearch和streaming. 2.1 micro Benchma ...
- HiBench成长笔记——(3) HiBench测试Spark
很多内容之前的博客已经提过,这里不再赘述,详细内容参照本系列前面的博客:https://www.cnblogs.com/ratels/p/10970905.html 创建并修改配置文件conf/spa ...
- HiBench成长笔记——(6) HiBench测试结果分析
Scan Join Aggregation Scan Join Aggregation Scan Join Aggregation Scan Join Aggregation Scan Join Ag ...
- HiBench成长笔记——(5) HiBench-Spark-SQL-Scan源码分析
run.sh #!/bin/bash # Licensed to the Apache Software Foundation (ASF) under one or more # contributo ...
- HiBench成长笔记——(2) CentOS部署安装HiBench
安装Scala 使用spark-shell命令进入shell模式,查看spark版本和Scala版本: 下载Scala2.10.5 wget https://downloads.lightbend.c ...
- HiBench成长笔记——(8) 分析源码workload_functions.sh
workload_functions.sh 是测试程序的入口,粘连了监控程序 monitor.py 和 主运行程序: #!/bin/bash # Licensed to the Apache Soft ...
- HiBench成长笔记——(7) 阅读《The HiBench Benchmark Suite: Characterization of the MapReduce-Based Data Analysis》
<The HiBench Benchmark Suite: Characterization of the MapReduce-Based Data Analysis>内容精选 We th ...
- HiBench成长笔记——(10) 分析源码execute_with_log.py
#!/usr/bin/env python2 # Licensed to the Apache Software Foundation (ASF) under one or more # contri ...
- HiBench成长笔记——(9) 分析源码monitor.py
monitor.py 是主监控程序,将监控数据写入日志,并统计监控数据生成HTML统计展示页面: #!/usr/bin/env python2 # Licensed to the Apache Sof ...
随机推荐
- 简单实用的matlab柱状图显示比例及计数
这个小代码用于matlab柱状图显示比例及数值, 函数如下: function myhist(x) % myhist Codeby SimonLiang % Email:idignew@126.com ...
- centos7搭建hadoop2.10完全分布式
本篇介绍在centos7中大家hadoop2.10完全分布式,首先准备4台机器:1台nn(namenode);3台dn(datanode) IP hostname 进程 192.168.30.141 ...
- ROS-debug1 : 运行roscore时报错:Unable to contact my own server at...
一.问题描述 在终端运行roscore时,出现错误:Unable to contact my own server at...,如下图: 二.解决方法 以上问题是由于ROS环境变量ROS_MASTER ...
- mysql之内连接,外连接(左连接,右连接),union,union all的区别
内连接,外连接,左连接,右连接,全连接 测试数据: CREATE TABLE `a_table` ( `a_id` int(11) DEFAULT NULL, `a_name` varchar(10) ...
- jdk 档案库(包含历史版本)
http://java.sun.com/products/archive/ 参考:https://blog.csdn.net/shiluyong8068/article/details/7894747 ...
- USN日志
转载:https://www.iteye.com/blog/univasity-805234 https://blog.51cto.com/velika/1440105 源码:https://f ...
- hdfs dfs ls /列出了本地根目录下文件夹和文件Warning: fs.defaultFS is not set when running "ls" command
[root@node01 customShells]# hdfs dfs -ls /Warning: fs.defaultFS is not set when running "ls&quo ...
- Linux centosVMware php-fpm的pool、php-fpm慢执行日志、open_basedir
一.php-fpm的pool vim /usr/local/php/etc/php-fpm.conf//在[global]部分增加 include = etc/php-fpm.d/*.conf mkd ...
- 1 观察者模式 observer 模拟监听器的实现
参考(http://blog.csdn.net/allwefantasy/article/details/3062277) 假设我有一台电脑.电脑里面有一个事件,当你按下电源按钮的时候,那么显示器会亮 ...
- pytorc人工神经网络Logistic regression与全连接层
//2019.10.08神经网络与全连接层1.logistics regression逻辑回归的思想是将数据利用激活函数sigmoid函数转换为0-1的概率,然后定义一定的阈值0.5,大于阈值则为一类 ...