
爬取动态网页:Selenium
参考:http://blog.csdn.net/wgyscsf/article/details/53454910
概述
- 在爬虫过程中,一般情况下都是直接解析html源码进行分析解析即可。但是,有一种情况是比较特殊的:网页的数据采用异步加载的,比如ajax加载的数据,在我们“查看网页源代码”是查看不到的。采用常规的爬虫这一块是解析不到的。
第一种解决方案是采用一些第三方的工具,模拟浏览器的行为,去加载数据。比如:
Selenium、PhantomJs。- 优点:不必考虑动态页面的各种变化多端(无论动态数据如何变化,最终呈现在页面上的效果是固定的,我们只关心最终结果。),我们只用关心最终的现实结果即可。可以统一处理。
- 缺点:性能低下,比如使用
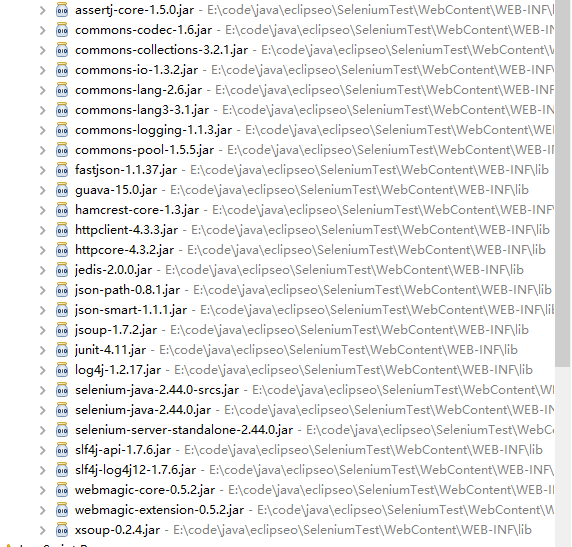
Selenium,每次我们都需要去启动一个浏览器进程;配置繁琐,不同的浏览器需要下载不同的驱动以及jar包,并且驱动和jar包之间有严格版本匹配关系,如果不匹配就不能使用(至少本人因为版本匹配的关系,花了很大的时间)。
第二种解决方案是分析页面,找到对应请求接口,直接获取数据。
- 优点:性能高,使用方便。我们直接获取原数据接口(换句话说就是直接拿取网页这一块动态数据的API接口),肯定会使用方便,并且改变的可能性也比较小。
- 缺点:缺点也是明显的,如何获取接口API?有些网站可能会考虑到数据的安全性,做各种限制、混淆等。这就需要看开发者个人的基本功了,进行各种分析了。
1、下载安装
谷歌和驱动版本匹配可以参考这篇文章:http://blog.csdn.net/huilan_same/article/details/51896672
chromedriver下载地址(不需要翻墙):http://chromedriver.storage.googleapis.com/index.html
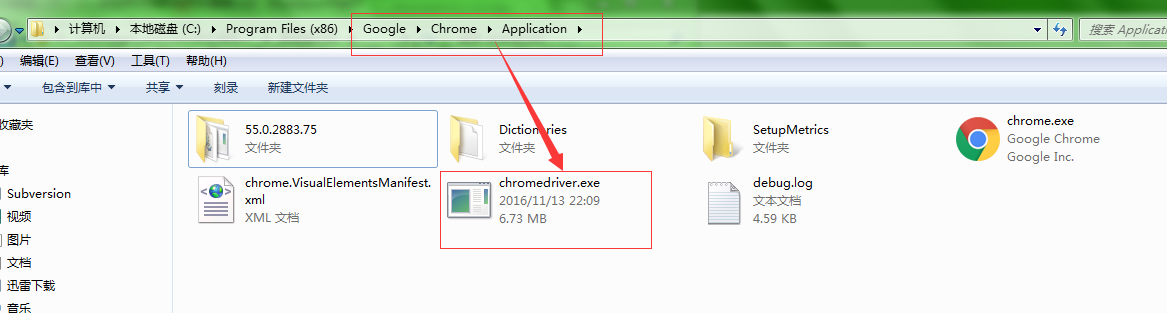
将下载的驱动放到谷歌浏览器的安装目录下,如下图
2、导包
3、编写测试代码
package Test;

import org.openqa.selenium.WebDriver;

import org.openqa.selenium.chrome.ChromeDriver;

public class SeleniumTest {

     public static void main(String[] args) {

            // 第一步: 设置chromedriver地址。一定要指定驱动的位置。

            System.setProperty("webdriver.chrome.driver",

                    "C:\\Program Files (x86)\\Google\\Chrome\\Application\\chromedriver.exe");

            // 第二步:初始化驱动

            WebDriver driver = new ChromeDriver();

            // 第三步:获取目标网页

            driver.get("http://blog.csdn.net/wgyscsf/article/details/52835845");

            // 第四步:解析。以下就可以进行解了。使用webMagic、jsoup等进行必要的解析。

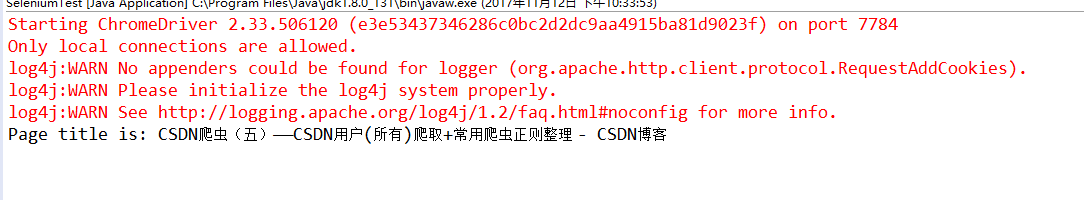
            System.out.println("Page title is: " + driver.getTitle());

            //System.out.println("Page title is: " + driver.getPageSource());

        }

}
爬取动态网页:Selenium的更多相关文章
- R语言爬取动态网页之环境准备
在R实现pm2.5地图数据展示文章中,使用rvest包实现了静态页面的数据抓取,然而rvest只能抓取静态网页,而诸如ajax异步加载的动态网页结构无能为力.在R语言中,爬取这类网页可以使用RSele ...
- 爬虫(三)通过Selenium + Headless Chrome爬取动态网页
一.Selenium Selenium是一个用于Web应用程序测试的工具,它可以在各种浏览器中运行,包括Chrome,Safari,Firefox 等主流界面式浏览器. 我们可以直接用pip inst ...
- 利用selenium并使用gevent爬取动态网页数据
首先要下载相应的库 gevent协程库:pip install gevent selenium模拟浏览器访问库:pip install selenium selenium库相应驱动配置 https: ...
- 记录几个爬取动态网页时的问题(下拉框,旧的元素无法获取,获取的源代码和f12看到的不一致,爬取延迟)
更新.....这个动态网页其实直接抓取ajax请求就可以了,很简单,我之前想复杂了,虽然也实现了,但是效率极低,不过没关系,就当作是对Selenium的一次学习吧 1.最近在爬取一个动态网页,其中为了 ...
- python爬取动态网页数据,详解
原理:动态网页,即用js代码实现动态加载数据,就是可以根据用户的行为,自动访问服务器请求数据,重点就是:请求数据,那么怎么用python获取这个数据了? 浏览器请求数据方式:浏览器向服务器的api(例 ...
- python爬取动态网页2,从JavaScript文件读取内容
import requests import json head = {"user-agent":"Mozilla/5.0 (Windows NT 6.1; WOW64) ...
- phantomjs+selenium实现爬取动态网址
之前使用 selenium + firefox驱动浏览器来实现爬取动态网址,但是firefox经常更新,更新后时常会导致webdriver启动不来,所以改用phantomjs+selenium来改善一 ...
- Python+Selenium爬取动态加载页面(2)
注: 上一篇<Python+Selenium爬取动态加载页面(1)>讲了基本地如何获取动态页面的数据,这里再讲一个稍微复杂一点的数据获取全国水雨情网.数据的获取过程跟人手动获取过程类似,所 ...
- Python+Selenium爬取动态加载页面(1)
注: 最近有一小任务,需要收集水质和水雨信息,找了两个网站:国家地表水水质自动监测实时数据发布系统和全国水雨情网.由于这两个网站的数据都是动态加载出来的,所以我用了Selenium来完成我的数据获取. ...
随机推荐
- js replace 全局替换 以表单的方式提交参数 判断是否为ie浏览器 将jquery.qqFace.js表情转换成微信的字符码 手机端省市区联动 新字体引用本地运行可以获得,放到服务器上报404 C#提取html中的汉字 MVC几种找不到资源的解决方式 使用Windows服务定时去执行一个方法的三种方式
js replace 全局替换 js 的replace 默认替换只替换第一个匹配的字符,如果字符串有超过两个以上的对应字符就无法进行替换,这时候就要进行一点操作,进行全部替换. <scrip ...
- C/C++,java开源数学计算库
有限元分析.数值计算.三维建模.信号处理.性能分析.仿真分析...这些或多或少与我们常用的软件息息相关,假如有一天你只需要这些大型软件系统的某一个很有限的功能,你是不是也要因此再用一用那动辄几个g的软 ...
- Matlab中图片保存的四种方法
matlab的绘图和可视化能力是不用多说的,可以说在业内是家喻户晓的.Matlab提供了丰富的绘图函数,比如ez**系类的简易绘图函数,surf.mesh系类的数值绘图函数等几十个.另外其他专业工具箱 ...
- 动态控制body最小高度
//动态控制body最小高度 var windowHeight = $(document).height() - 164; $(".body-content").css({ &qu ...
- Apache/Nigix + Tomcat + 负载均衡
Part I: Apache + Tomcat + 负载均衡 http://www.open-open.com/lib/view/open1350612892352.html http://micha ...
- 求两个有序数组的中位数(4. Median of Two Sorted Arrays)
先吐槽一下,我好气啊,想了很久硬是没有做出来,题目要求的时间复杂度为O(log(m+n)),我猜到了要用二分法,但是没有想到点子上去.然后上网搜了一下答案,感觉好有罪恶感. 题目原型 正确的思路是:把 ...
- 理解DOMSTRING、DOCUMENT、FORMDATA、BLOB、FILE、ARRAYBUFFER数据类型
一.XMLHttpRequest 2.0的家臣们 我大学那会儿,一个称为Ajax的东西对前端行业造成了深远影响,不仅是JS语言,而包括前端地位.职位兴起以及工作分工等.抛开IE6浏览器不谈,其他浏览器 ...
- C++基本数据类型及类型转换
http://blog.csdn.net/pipisorry/article/details/25346379 c++基本数据类型 什么样的数据算是byte类型,int类型,float类型,doubl ...
- js中变量的声明
大家都知道js中变量的声明是要提前的,下面有4个样例: 1.if(!"t" in window){ var t = 1; } alert(t);答案是undefine ...
- Chef vs Puppet vs Ansible vs Saltstack: Which Works Best For You?
Ansible vs SaltStack 谁才是自动化运维好帮手? - CSDN博客 https://blog.csdn.net/a105421548/article/details/53558598 ...