
spark入门: wordcount-java
wordcount-java:
pom.xml文件如下:
<dependencies>

    <dependency>

      <groupId>junit</groupId>

      <artifactId>junit</artifactId>

      <version>3.8.1</version>

      <scope>test</scope>

    </dependency>

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-core_2.10</artifactId>

      <version>1.3.0</version>

    </dependency>

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-sql_2.10</artifactId>

      <version>1.3.0</version>

      </dependency>

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-hive_2.10</artifactId>

      <version>1.3.0</version>

    </dependency>

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-streaming_2.10</artifactId>

      <version>1.3.0</version>

    </dependency>

    <dependency>

      <groupId>org.apache.hadoop</groupId>

      <artifactId>hadoop-client</artifactId>

      <version>2.4.1</version>

    </dependency>

    <dependency>

      <groupId>org.apache.spark</groupId>

      <artifactId>spark-streaming-kafka_2.10</artifactId>

      <version>1.3.0</version>

    </dependency>

  </dependencies>
package cn.spark.study.core;

import java.util.Arrays;

import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaPairRDD;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.FlatMapFunction;

import org.apache.spark.api.java.function.Function2;

import org.apache.spark.api.java.function.PairFunction;

import org.apache.spark.api.java.function.VoidFunction;

import scala.Tuple2;

public class WordCount3 {

	public static void main(String[] args) {

		SparkConf conf=new SparkConf().setAppName("WorldCountLocal").setMaster("local");

		JavaSparkContext sc=new JavaSparkContext(conf);

		JavaRDD<String> lines=sc.textFile("C:\\Users\\wanglonglong\\Desktop\\word.txt");

		JavaRDD<String> words=lines.flatMap(new FlatMapFunction<String, String>() {

			@Override

			public Iterable<String> call(String t) throws Exception {

				// TODO Auto-generated method stub

				return Arrays.asList(t.split(" "));

			}

		});

		JavaPairRDD<String, Integer> pairs = words.mapToPair(new PairFunction<String, String, Integer>() {

			private static final long serialVersionUID=1;

			@Override

			public Tuple2<String, Integer> call(String word) throws Exception {

				return new Tuple2<String, Integer>(word,1);

			}

		});

		JavaPairRDD<String, Integer> wordCounts = pairs.reduceByKey(

		        new Function2<Integer, Integer, Integer>() {

		            private static final long serialVersionUID = 1L;

		            public Integer call(Integer v1, Integer v2) throws Exception {

		                return v1 + v2;

		            }

		        });

		wordCounts.foreach(new VoidFunction<Tuple2<String,Integer>>() {

		       private static final long serialVersionUID = 1L;

		       public void call(Tuple2<String, Integer> wordCount) throws Exception {

		           System.out.println("("+wordCount._1 + "," + wordCount._2 + " )");

		       }

		   });

		   sc.close();

	}

}

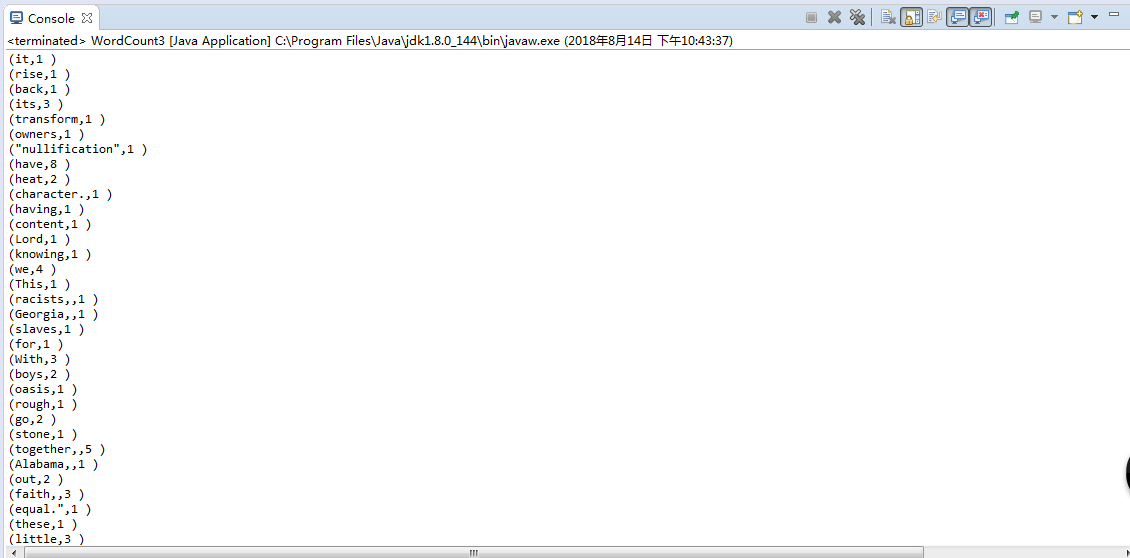
spark入门: wordcount-java的更多相关文章
- 编写Spark的WordCount程序并提交到集群运行[含scala和java两个版本]
编写Spark的WordCount程序并提交到集群运行[含scala和java两个版本] 1. 开发环境 Jdk 1.7.0_72 Maven 3.2.1 Scala 2.10.6 Spark 1.6 ...
- Spark 入门
Spark 入门 目录 一. 1. 2. 3. 二. 三. 1. 2. 3. (1) (2) (3) 4. 5. 四. 1. 2. 3. 4. 5. 五. Spark Shell使用 ...
- Spark入门实战系列--10.分布式内存文件系统Tachyon介绍及安装部署
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Tachyon介绍 1.1 Tachyon简介 随着实时计算的需求日益增多,分布式内存计算 ...
- 使用scala开发spark入门总结
使用scala开发spark入门总结 一.spark简单介绍 关于spark的介绍网上有很多,可以自行百度和google,这里只做简单介绍.推荐简单介绍连接:http://blog.jobbole.c ...
- Spark入门实战系列--1.Spark及其生态圈简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .简介 1.1 Spark简介 年6月进入Apache成为孵化项目,8个月后成为Apache ...
- Spark入门实战系列--2.Spark编译与部署(下)--Spark编译安装
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .编译Spark .时间不一样,SBT是白天编译,Maven是深夜进行的,获取依赖包速度不同 ...
- Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark Streaming简介 1.1 概述 Spark Streaming 是Spa ...
- Spark入门之idea编写Scala脚本
一.安装Scala插件 1.File->Settings 2.Plugins->Msrketplace->搜索Scala并安装 (或者自己下载合适的scala版本,教程:自己给ide ...
- Spark入门实战系列--2.Spark编译与部署(上)--基础环境搭建
[注] 1.该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取: 2.Spark编译与部署将以CentOS 64位操作系统为基础,主要是考虑到实际应用 ...
- Spark入门实战系列--2.Spark编译与部署(中)--Hadoop编译安装
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .编译Hadooop 1.1 搭建环境 1.1.1 安装并设置maven 1. 下载mave ...
随机推荐
- Unity PlayerPrefs
对于游戏存档,储存最高分,排行榜都需要用到储存,现在存储的方式有很多,可以存本地的Json,XML,Sqlite,还有一种就是unity自带的一种存储PlayerPrefs. 那么这个PlayerPr ...
- <llinux下kvm虚拟化>
原理就是本来可能要10台物理机完成的事现在只要5台,分别在每台物理机上虚拟一台,这5太虚拟机共享一个stronge,比如有一台物理机down掉后或是要做维护,我们可以把它上面的虚拟机牵走,从而减少损失 ...
- Android数据库(1)、SQLite数据库介绍
一.关系性数据库 关系型数据库主要有以下三个特征,尤为明显,如果没有这个三个特征约束,当多个客户端使用数据的时候就会出现各种各样的错误,所以关系型数据库定义这些约束,让客户端程序只要遵守这个规则便 ...
- flask之jinja2模板语言
一.jinja2简单介绍 Jinja2是Python里一个被广泛应用的模版引擎,他的设计思想来源于Django的模板引擎,并扩展了其语法和一系列强大的功能.其中最显著的一个是增加了沙箱执行功能和可选的 ...
- 使用JS实现图片轮播(前后首尾相接)
最近各种跑面试,终于还是被问到这个,一脑子浆糊,当时没想出来首尾相接怎么搞,回来之后研究了一波,终于搞出来了,不多说,直接看代码 代码参考了一位已经写好了图片轮播功能的(在此表示感谢),但是没有首尾相 ...
- js学习的一些想法(有一些来自网络)
javascript开发最佳实践学习 1.给变量和函数命名--变量名和函数名尽量简短 好的变量命名应该是简短易懂的,还有需要避免的陷阱就是在命名中将数值与功能结合. 匈牙利命名法就是一个不错的选择,也 ...
- Ubuntu 14.04 安装caffe深度学习框架
简介:如何在ubuntu 14.04 下安装caffe深度学习框架. 注:安装caffe时一定要保持网络状态好,不然会遇到很多麻烦.例如下载不了,各种报错. 一.安装依赖包 $ sudo apt-ge ...
- 利用BandwagonHost***便宜Linux VPS安装VNC(远程桌面)- 安装篇
如果我们有搭建过网站,或者用过VPS.服务器,肯定会看到最近几年主机市场竞争还是比较激烈的.尤其是VPS.服务器的价格走低,很多商家价格厮杀的厉害,甚至出现年付几美元的VPS.便宜VPS固然是好事,我 ...
- HDU 1114 Piggy-Bank 猪仔储钱罐(完全背包)
题意: 给定一个存钱罐中要存硬币,知道空罐的重量和欲装满的重量,是否能装入?若能,打印最小价值.(注:能装的硬币重量一定刚刚好,里面的总价值要达到最小) 输入: 包含了T个测试例子,在第一行给出.接下 ...
- Python核心编程——多线程threading和队列
线程与进程类似不过他们是在同一个进程下执行的,并共享相同的上下文.可以将他们认为是在一个主进程或“主线程”中运行的迷你进程. 线程包括开始.执行顺序和结束三部分.它有一个指令指针,用于记录当前运行的上 ...