
Spark Streaming连接TCP Socket
1.Spark Streaming是什么
Spark Streaming是在Spark上建立的可扩展的高吞吐量实时处理流数据的框架,数据可以是来自多种不同的源,例如kafka,Flume,Twitter,ZeroMQ或者TCP Socket等。在这个框架下,支持对流数据的各种运算,比如map,reduce,join等。处理过后的数据可以存储到文件系统或数据库。
利用Spark Streaming,你可以使用与批量加载数据相同的API来创建数据管道,并通过数据管道处理流式数据。此外,Spark Steaming的“micro-batching”方式提供相当好的弹性来应对某些原因造成的任务失败。
2. Spark Streaming的基本原理
Spark Streaming对数据的处理方式主要采用的方法是对Stream数据进行时间切片,分成小的数据片段,通过类似批处理的方式处理数据片段。
Spark Streaming把实时输入数据流以时间片Δt (如1秒)为单位切分成块。Spark Streaming会把每块数据作为一个RDD,并使用RDD操作处理每一小块数据。
Spark Streaming将流式计算分解成一系列短小的批处理作业。Spark Streaming的输入数据分成一段一段的数据(DStreaming),每一段数据都转换成Spark中的RDD,然后将Spark Streaming中对DStream的操作变为针对Spark中对RDD的操作,将RDD经过操作变成中间结果保存在内存中。
3. DStream
上面提到了DStreaming,那么DStreaming到底是什么呢:
DStreaming相当于在Streaming的框架下对RDD进行封装,表示的是我们处理的一个实时数据流。类似于RDD,DStream提供了转换操作,窗口转换操作和输出操作三种操作方法。
4.Spark Streaming的优势
Spark Streaming是一种构建在Spark上的实时计算框架,它扩展了Spark处理大规模流式数据的能力。
实时性:它能运行在100+的结点上,并达到秒级延迟。Spark Streaming将流式计算分解成多个Spark Job,对于每一段数据的处理都会经过Spark的任务集的调度过程。其最小的Batch Size的选取在0.5~2秒钟之间(Storm目前最小的延迟是100ms左右),所以Spark Streaming能够满足除对实时性要求非常高的所有流式准实时计算场景。
高效和容错的特性:对于流式计算来说,容错性至关重要。在spark中每一个RDD都是一个不可变的分布式可重算的数据集,其记录着确定性的操作,只要输入数据是可容错的,那么任意一个RDD的分区出错或不可用,都是可以利用原始输入数据通过转换操作而重新算出的。而spark Streaming使用基于内存的Spark作为执行引擎, 其容错性自然很好。
吞吐量:Spark Streaming能集成Spark的批处理和交互查询,其吞吐量比Storm至少高2~5倍。并且它为实现复杂的算法提供了和批处理类似的简单接口。
接下来用Spark Streaming连接TCP Socket来说明如何使用Spark Streaming:
1 创建StreamingContext对象
首先使用StreamingContext模块,这个模块的作用是提供所有的流数据处理的功能:
 from pyspark import SparkContext

 from pyspark.streaming import StreamingContext

 sc = SparkContext("local[2]", "streamwordcount")

 # 创建本地的SparkContext对象,包含2个执行线程

 ssc = StreamingContext(sc, 2)

 # 创建本地的StreamingContext对象,处理的时间片间隔时间,设置为2s
2 创建DStream对象
我们需要连接一个打开的 TCP 服务端口,从而获取流数据,这里使用的源是TCP Socket,所以使用socketTextStream()函数:
lines = ssc.socketTextStream("localhost", 8888)

# 创建DStream,指明数据源为socket:来自localhost本机的8888端口
3 对DStream进行操作
我们开始对lines进行处理,首先对当前2秒内获取的数据进行分割并执行标准的MapReduce流程计算。
words = lines.flatMap(lambda line: line.split(" "))

# 使用flatMap和Split对2秒内收到的字符串进行分割
得到的words是一系列的单词,再执行下面的操作:
pairs = words.map(lambda word: (word, 1))

# map操作将独立的单词映射到(word,1)元组

wordCounts = pairs.reduceByKey(lambda x, y: x + y)

# reduceByKey操作对pairs执行reduce操作获得(单词,词频)元组
5 输出数据
将处理后的数据输出到一个文件中:
outputFile = "/home/feige/streaming/ss"

# 输出文件夹的前缀,Spark Streaming会自动使用当前时间戳来生成不同的文件夹名称

wordCounts.saveAsTextFiles(outputFile)

# 将结果输出
6 启动应用
要使程序在Spark Streaming上运行起来,需要执行Spark Streaming启动的流程,调用start()函数启动,awaitTermination()函数等待处理结束的信号。
ssc.start()

# 启动Spark Streaming应用

ssc.awaitTermination()
打开终端执行:
nc -lk 8888
nc的-l参数表示创建一个监听端口,等待新的连接。-k参数表示当前连接结束后仍然保持监听,必须与-l参数同时使用。
执行完上面的命令后不关闭终端,我们将在这个终端中输入一些处理的数据:

打开一个新的终端来执行我们的Spark Streaming应用:

这里是spark streaming执行的过程
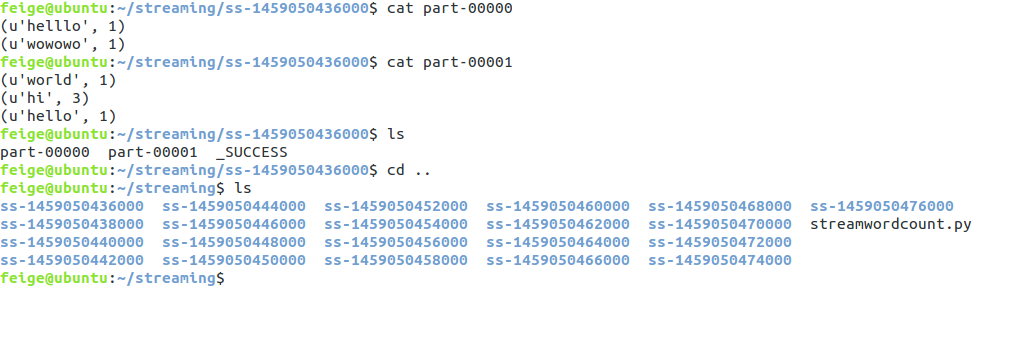
现在我们来看看程序执行的效果,程序每隔2秒扫描一次监控窗口输入的内容,我们查看一下:
结束语:
最近压力比较大,琐事诸多,相信这段时间过后一切都会好起来的,加油!!!
Spark Streaming连接TCP Socket的更多相关文章
- 2、 Spark Streaming方式从socket中获取数据进行简单单词统计
Spark 1.5.2 Spark Streaming 学习笔记和编程练习 Overview 概述 Spark Streaming is an extension of the core Spark ...
- Spark Streaming连接Kafka的两种方式 direct 跟receiver 方式接收数据的区别
Receiver是使用Kafka的高层次Consumer API来实现的. Receiver从Kafka中获取的数据都是存储在Spark Executor的内存中的,然后Spark Streaming ...
- Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark Streaming简介 1.1 概述 Spark Streaming 是Spa ...
- Spark Streaming 002 统计单词的例子
1.准备 事先在hdfs上创建两个目录: 保存上传数据的目录:hdfs://alamps:9000/library/SparkStreaming/data checkpoint的目录:hdfs://a ...
- .Spark Streaming(上)--实时流计算Spark Streaming原理介
Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍 http://www.cnblogs.com/shishanyuan/p/474 ...
- spark streaming的理解和应用
1.Spark Streaming简介 官方网站解释:http://spark.apache.org/docs/latest/streaming-programming-guide.html 该博客转 ...
- 实时流计算Spark Streaming原理介绍
1.Spark Streaming简介 1.1 概述 Spark Streaming 是Spark核心API的一个扩展,可以实现高吞吐量的.具备容错机制的实时流数据的处理.支持从多种数据源获取数据,包 ...
- Spark Streaming之一:整体介绍
提到Spark Streaming,我们不得不说一下BDAS(Berkeley Data Analytics Stack),这个伯克利大学提出的关于数据分析的软件栈.从它的视角来看,目前的大数据处理可 ...
- Update(Stage4):Spark Streaming原理_运行过程_高级特性
Spark Streaming 导读 介绍 入门 原理 操作 Table of Contents 1. Spark Streaming 介绍 2. Spark Streaming 入门 2. 原理 3 ...
随机推荐
- hdoj 5319 Painter(模拟题)
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=5319 思路分析:假设颜色R表示为1,颜色B表示为2,颜色G表示为3,因为数据量较小,采用暴力解法即可, ...
- mongoose的用法(注:连接数据库)
第一步:连接数据库: mongoose.connect('mongodb://'+user+':'+pass+'@mongo.duapp.com:'+port+'/xzWIRHYlWLAApdsfAz ...
- 超高性价比USB转CAN适配器,2500V工业级隔离,兼容ZLG软件
淘宝链接: http://item.taobao.com/item.htm?spm=a230r.1.14.16.QGsAZg&id=20134109594&initiative_new ...
- BootStrap 智能表单系列 四 表单布局介绍
表单的布局分为自动布局和自定义布局两种: 自动布局就是根据配置项中第二级配置项中数组的长度来自动使用不同的bootstrap栅格,通过设置autoLayout为true可以实现自动布局 自动以布局就是 ...
- 今天碰到的angular 中的一个小坑
最近在自个儿研究angular,在写一个demo的时候总是有问题,最后发现居然是大小写的问题,卧槽 特tm的坑爹了,代码如下: <!DOCTYPE html> <html lang= ...
- ExtJS002Window创建
Ext.onReady(function () { Ext.create('Ext.window.Window', { title: 'window', width: 400, height: 300 ...
- 关于codestyle
如果你的代码易于阅读,那么代码中bug也将会很少,因为一些bug可以很容被调试,并且,其他开发者参与你项目时的门槛也会比较低.因此,如果项目中有多人参与,采取一个有共识的编码风格约定非常有必要. 以t ...
- 8.PHP 教程_PHP字符串
字符串变量用于存储并处理文本. PHP中的字符串变量 字符串变量用于包含有字符的值. 在创建字符串之后,我们就可以对它进行操作了.您可以直接在函数中使用字符串,或者把它存储在变量中. 在下面的实例中, ...
- [LeetCode]题解(python):135-Candy
题目来源: https://leetcode.com/problems/candy/ 题意分析: 有N个孩子站成一条线.每个孩子有个排名.要求1.每个孩子至少一个糖果,2.相邻的孩子,那么较高排名的孩 ...
- BeanUtils复制属性
package xiao; public class User2 { private String name; private String password; public String getNa ...