
2、 Spark Streaming方式从socket中获取数据进行简单单词统计
Spark 1.5.2 Spark Streaming 学习笔记和编程练习
Overview 概述
Spark Streaming is an extension of the core Spark API that enables scalable, high-throughput, fault-tolerant stream processing of live data streams. Data can be ingested from many sources like Kafka, Flume, Twitter, ZeroMQ, Kinesis, or TCP sockets, and can be processed using complex algorithms expressed with high-level functions like map, reduce, join and window. Finally, processed data can be pushed out to filesystems, databases, and live dashboards. In fact, you can apply Spark’s machine learning and graph processing algorithms on data streams.
Spark Streaming 是核心Spark API的一个扩展,其处理实时流数据具有可扩展性、高吞吐量,容错性。数据可以通过多种源加载进来,如Kafka, Flume, Twitter, ZeroMQ, Kinesis, or TCP sockets;并且能够使用像map, reduce, join and window这样高级别的复杂算法处理。数据处理后可以输出到文件系统,如databases, and live dashboards。你也可以使用spark的机器学习,图处理算法在数据流上。
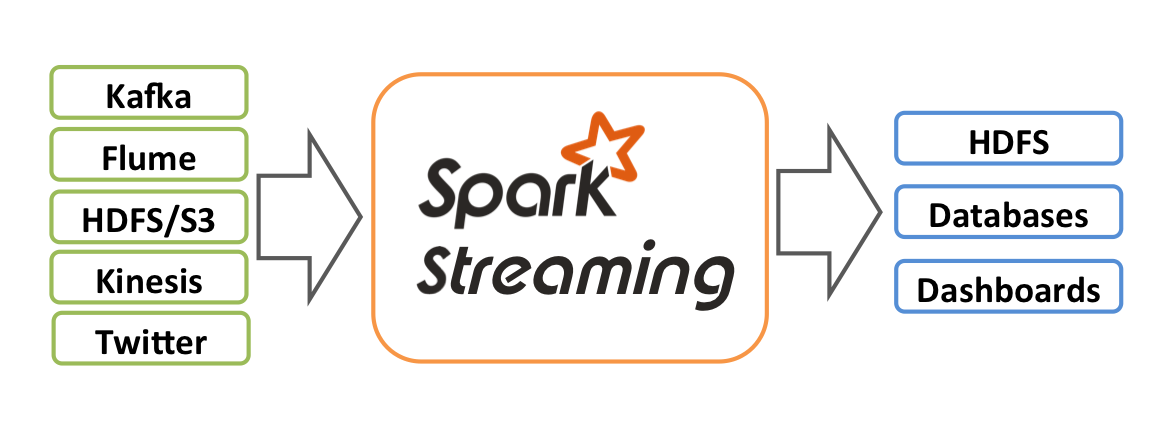
Internally, it works as follows. Spark Streaming receives live input data streams and divides the data into batches, which are then processed by the Spark engine to generate the final stream of results in batches.
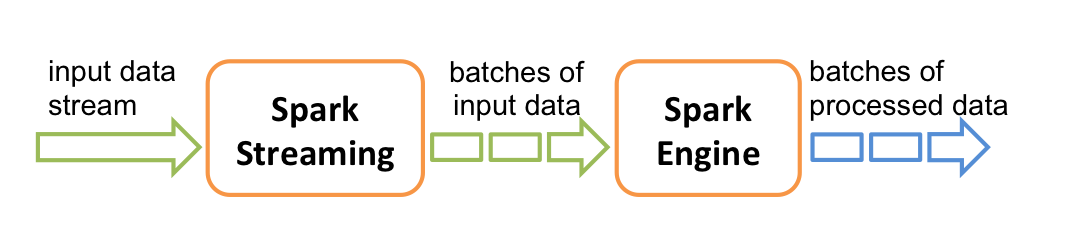
Spark Streaming provides a high-level abstraction called discretized stream or DStream, which represents a continuous stream of data. DStreams can be created either from input data streams from sources such as Kafka, Flume, and Kinesis, or by applying high-level operations on other DStreams. Internally, a DStream is represented as a sequence of RDDs.
Spark Streaming提出了一个高度抽象的概念叫做离散流或者DStream,来表达一个连续的流数据。一个Dstream可以看作一系列RDD。
Java编程练习:
一个spark streaming从socket获取数据进行单词统计的例子:(pom文件要添加spark相关依赖)
socket代码:
说明:启动一个socket服务端,等待连接,连接之后,重复输出一个字符串到连接的socket中。socket地址为本机,9999端口。
 import java.io.*;

 import java.net.ServerSocket;

 import java.net.Socket;

 import java.util.Date;

 /**

  * socket服务端简单实现,主要作用往socket客户端发送数据

  */

 public class SocketServerPut {

     public static void main(String[] args) {

         try {

             ServerSocket serverSocket = new ServerSocket(9999);

             Socket socket=null;

             while(true) {

                 socket = serverSocket.accept();

                 while(socket.isConnected()) {

                     // 向服务器端发送数据

                     OutputStream os =  socket.getOutputStream();

                     DataOutputStream bos = new DataOutputStream(os);

                     //每隔20ms发送一次数据

                     String str="Connect 123 test spark streaming abc xyz hik\n";

                     while(true){

                         bos.writeUTF(str);

                         bos.flush();

                         System.out.println(str);

                         //20ms发送一次数据

                         try {

                             Thread.sleep(500L);

                         } catch (InterruptedException e) {

                             e.printStackTrace();

                         }

                     }

                 }

                 //10ms检测一次连接

                 try {

                     Thread.sleep(10L);

                 } catch (InterruptedException e) {

                     e.printStackTrace();

                 }

             }

         } catch (IOException e) {

             e.printStackTrace();

         }

     }

 }
Spark Streaming 处理代码:
 import org.apache.spark.SparkConf;

 import org.apache.spark.api.java.function.FlatMapFunction;

 import org.apache.spark.api.java.function.Function2;

 import org.apache.spark.api.java.function.PairFunction;

 import org.apache.spark.streaming.Durations;

 import org.apache.spark.streaming.api.java.JavaDStream;

 import org.apache.spark.streaming.api.java.JavaPairDStream;

 import org.apache.spark.streaming.api.java.JavaReceiverInputDStream;

 import org.apache.spark.streaming.api.java.JavaStreamingContext;

 import scala.Tuple2;

 import java.util.Arrays;

 /**

  * streaming从socket获取数据处理

  */

 public class StreamingFromSocket {

     public static void main(String[] args) {

         //设置运行模式local 设置appname

         SparkConf conf=new SparkConf().setMaster("local[2]").setAppName("StreamingFromSocketTest");

         //初始化,设置窗口大小为2s

         JavaStreamingContext jssc=new JavaStreamingContext(conf, Durations.seconds(2L));

         //从本地Socket的9999端口读取数据

         JavaReceiverInputDStream<String> lines= jssc.socketTextStream("localhost", 9999);

         //把一行数据转化成单个单次  以空格分隔

         JavaDStream<String> words = lines.flatMap(new FlatMapFunction<String,String>(){

             @Override

             public Iterable<String> call(String x){

                 return Arrays.asList(x.split(" "));

             }

         });

         //计算每一个单次在一个batch里出现的个数

         JavaPairDStream<String, Integer> pairs= words.mapToPair(new PairFunction<String, String, Integer>() {

             @Override

             public Tuple2<String, Integer> call(String s) throws Exception {

                 return new Tuple2<String, Integer>(s,1);

             }

         });

         JavaPairDStream<String,Integer> wordCounts=pairs.reduceByKey(new Function2<Integer, Integer, Integer>() {

             @Override

             public Integer call(Integer integer, Integer integer2) throws Exception {

                 return integer+integer2;

             }

         });

         //输出统计结果

         wordCounts.print();

         jssc.start();

         //20s后结束

         jssc.awaitTerminationOrTimeout(20*1000L);

     }

 }
输出结果:
-------------------------------------------
Time: 1470385522000 ms
-------------------------------------------
(hik,4)
(123,4)
(streaming,4)
(abc,4)
(test,4)
初始化streamingContext
1、方式一:使用sparkconf初始化
import org.apache.spark.*;

import org.apache.spark.streaming.api.java.*;

SparkConf conf = new SparkConf().setAppName(appName).setMaster(master);

JavaStreamingContext ssc = new JavaStreamingContext(conf, Duration(1000));
2、由已存在的sparkcontext初始化
import org.apache.spark.streaming.api.java.*;

JavaSparkContext sc = ...   //existing JavaSparkContext

JavaStreamingContext ssc = new JavaStreamingContext(sc, Durations.seconds(1));
After a context is defined, you have to do the following.
- Define the input sources by creating input DStreams.
- Define the streaming computations by applying transformation and output operations to DStreams.
- Start receiving data and processing it using
streamingContext.start(). - Wait for the processing to be stopped (manually or due to any error) using
streamingContext.awaitTermination(). - The processing can be manually stopped using
streamingContext.stop().
Points to remember:
- Once a context has been started, no new streaming computations can be set up or added to it.
- Once a context has been stopped, it cannot be restarted.
- Only one StreamingContext can be active in a JVM at the same time.
- stop() on StreamingContext also stops the SparkContext. To stop only the StreamingContext, set the optional parameter of
stop()calledstopSparkContextto false. - A SparkContext can be re-used to create multiple StreamingContexts, as long as the previous StreamingContext is stopped (without stopping the SparkContext) before the next StreamingContext is created.
初始化Context后,需要做如下几件事情,才能完成一个job。
1)定义一个输入源,从而产生DStreams;
2)定义streaming计算通过对DStreams应用转换和输出操作;
3)使用streamingContext.start()语句开始接受数据并进行处理;
4)使用streamingContext.awaitTermination().让程序等待job完成;程序异常也可导致停止job;
5)使用streamingContext.stop()可以停止job;
注意项:
1)当context开始后,新的streaming computation不能被设置和添加进来;
2)context停止后,不能重启;
3)同一时间JVM(java虚拟机)中只允许一个StreamingContext存在;
4)停止StreamingContext后,sparkcontext也会停止;如果你只想停止StreamingContext,你可以在stop的参数中设置stopSparkContext为false;
5)一个SparkContext可以被重复使用去创建StreamingContext,但新的StreamingContext被创建前,前一个StreamingContext要停止。
未完待续
2、 Spark Streaming方式从socket中获取数据进行简单单词统计的更多相关文章
- Spark Streaming连接TCP Socket
1.Spark Streaming是什么 Spark Streaming是在Spark上建立的可扩展的高吞吐量实时处理流数据的框架,数据可以是来自多种不同的源,例如kafka,Flume,Twitte ...
- 哪种方式更适合在React中获取数据?
作者:Dmitri Pavlutin 译者:小维FE 原文:dmitripavlutin.com 国外文章,笔者采用意译的方式,以保证文章的可读性. 当执行像数据获取这样的I/O操作时,你必须发起获取 ...
- Spark Streaming源码解读之流数据不断接收和全生命周期彻底研究和思考
本节的主要内容: 一.数据接受架构和设计模式 二.接受数据的源码解读 Spark Streaming不断持续的接收数据,具有Receiver的Spark 应用程序的考虑. Receiver和Drive ...
- geotrellis使用(十六)使用缓冲区分析的方式解决投影变换中边缘数据值计算的问题
Geotrellis系列文章链接地址http://www.cnblogs.com/shoufengwei/p/5619419.html 目录 前言 问题探索 采样说明 实现方案 总结 一.前言 ...
- Thymeleaf+SpringMVC,如何从模板中获取数据
Thymeleaf+SpringMVC,如何从模板中获取数据 在一个典型的SpringMVC应用中,带@Controller注解的类负责准备数据模型Map的数据和选择一个视图进行渲染.这个模型Map对 ...
- hive从查询中获取数据插入到表或动态分区
Hive的insert语句能够从查询语句中获取数据,并同时将数据Load到目标表中.现在假定有一个已有数据的表staged_employees(雇员信息全量表),所属国家cnty和所属州st是该表的两 ...
- SpringMVC从Request域中获取数据
SpringMVC从Request域中获取数据的三种方式 SpringMVC环境自行搭建, 约定存在如下目录和文件:/WEB-INF/pages/success.jsp 方式一:传入Model对象 前 ...
- Django Form 实时从数据库中获取数据
修改 models.py 添加 class UserType(models.Model): caption = models.CharField(max_length=32) 执行命令,生成数据库 p ...
- SQL语句的使用,SELECT - 从数据库表中获取数据 UPDATE - 更新数据库表中的数据 DELETE - 从数据库表中删除数据 INSERT INTO - 向数据库表中插入数据
SQL DML 和 DDL 可以把 SQL 分为两个部分:数据操作语言 (DML) 和 数据定义语言 (DDL). SQL (结构化查询语言)是用于执行查询的语法. 但是 SQL 语言也包含用于更新. ...
随机推荐
- mysql数据库在Navicat Premium连接的时候出现1862错误
navicat连接打开时报1862的错误, 很就没有连接mysql看看了,今天连接的时候发现本机的mysql链接不上了,在cmd中执行动作的时候也会叫你去set password,做设置密码的动作时会 ...
- 会话控制session,cookie(0521)
简单介绍: 一.什么是session? 1. 定义: Session,在计算机中,尤其是在网络应用中,称为“会话”.在计算机专业术语中,Session是指一个终端用户与交互系统进行通信的时间间隔,通常 ...
- memcached学习笔记——连接模型
文章链接:http://www.hcoding.com/?p=121 个人站点:JC&hcoding.com memcached是什么呢?memcached是一个优秀的.高性能的内存缓存工具. ...
- JavaScript电话号码正则
var telNumRE = /^((\d{11})|(\d{3,4}-)*(\d{7,8})+(-\d{1,4})*|(\d{5}))$/; 可以截取以下内容: 11位手机号:18911931207 ...
- 【转】对ARM堆栈的理解
对ARM堆栈的理解 堆栈严格来说应该叫做栈,栈(Stack)是限定仅在一端进行插入或删除操作的线性表.因此,对栈来说,可以进行插入或删除操作的一端端称为栈顶(top),相应地,另一端称为栈底(bott ...
- IC卡接口芯片TDA8007的读写器设计
摘要:阐述T=0传输协议,给出IC卡读写器中使用的IC卡APDU指令流程和原理框图:重点介绍其中的IC卡接口芯片Philips的TDA8007,给出通过TDA8007对CPU IC卡上下电过程.具体程 ...
- Qt编程之qrc文件的链接
在Qt里面,.qrc文件是一种类似XML结构的文件,用结构化数据描述应用程序所需要的资源位置,例如图片,应用程序的图标文件等.它最终是与.ui文件类似都被通过Qt提供的命令行工具生成对应的qrc_XX ...
- VS2010编译Qt程序失败------error LNK1123: 转换到 COFF 期间失败:
error LNK1123: 转换到 COFF 期间失败: 文件无效或损坏使用VS2010编译VC++项目的时候可能会出这个问题. 据说升级到SP1后可能问题解决,但是下载量太大,目前没有得到证实. ...
- Struts2配置RESULT中TYPE的参数说明
chain 用来处理Action链,被跳转的action中仍能获取上个页面的值,如request信息. com.opensymphony.xwork2.Acti ...
- 关于bootstrap--列表(ol、ul)
1.list-unstyled : 在<ol>(有序列表)</ol><ul>(无序列表)</ul>中加入class="list-styled& ...