
openGemini内核源码正式对外开源
摘要:openGemini是一个开源的分布式时序数据库系统,可广泛应用于物联网、车联网、运维监控、工业互联网等业务场景,具备卓越的读写性能和高效的数据分析能力。
本文分享自华为云社区《华为云面向全球正式开放openGemini内核源码》,作者: 云数据库创新Lab。
一、背景介绍
物联网时代已经来临,物联网设备走进我们的日常生活,例如智能冰箱、电动汽车、智能手表等等。公开报告显示,预计到2025年,中国的物联网连接数会占到全球的30%。这些联网的设备每时每刻都在产生大量的数据,每天的数据增长量可以达到GB级甚至TB级,给数据库带来非常大的挑战,例如:高并发写入大量数据导致数据入库太慢,海量数据引起过高的存储成本和查询时延等等。时序场景作为物联网领域的典型场景,与传统关系型数据库场景有很大区别,时序数据库专为时序场景设计和优化,近年来开始受到越来越多的关注。
华为云整合产业和技术优势,打造了业界领先的企业级时序数据库GaussDB for Influx,并经过外部公有云业务服务化的锤炼以及内部DevOps等业务的长时间打磨,在大规模集群、高性能查询、分级压缩存储等方面都有明显优势。今年6月,华为云宣布将GaussDB for Influx内核正式对外开源,开源品牌命名为openGemini。
openGemini是一个开源的分布式时序数据库系统,可广泛应用于物联网、车联网、运维监控、工业互联网等业务场景,具备卓越的读写性能和高效的数据分析能力。
二、openGemini软件架构
2.1架构设计
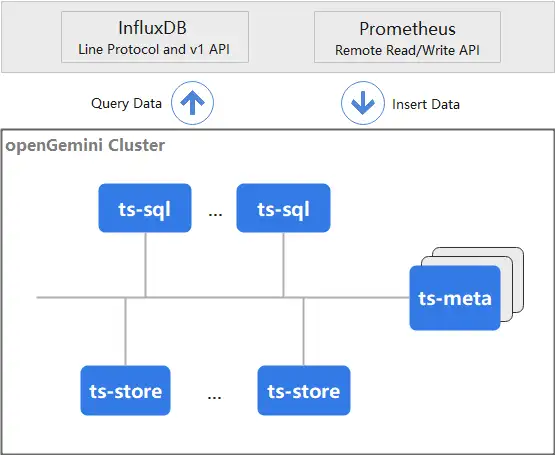
openGemini采用MPP 大规模并行处理分层架构,由ts-sql(计算引擎)、ts-store(存储引擎)、ts-meta(元数据引擎)三大部分组成。openGemini既支持集群部署,也可以单机部署。
ts-sql:统一处理客户端请求
- 提供RESTful接口
- 兼容InfluxDB Line Protocol和v1 API,同时也支持Prometheus的远程数据读写
- 查询语句执行期间,从ts-store获取数据并汇总,并返回客户端
- 支持横向扩展
ts-store:数据管理
- 将原始数据按优化设计的数据格式进行统一组织和存储
- 按时间范围和时间线ID查询数据
- 支持横向扩展
ts-meta:元数据管理
- 数据库集群元数据管理,如节点信息等
- 数据库元数据管理,如数据保留时间、数据分区信息、表信息等
2.2关键特性
高性能读写
- 每秒千万级指标数据并发写入,毫秒级查询响应支持时序数据分析
- 内置AI数据分析算法,支持实时异常检测和预测
兼容时序生态
- 完全兼容InfluxDB Line Protocol 和 InfluxQL
- 无缝集成现有InfluxDB工具链
- 支持Prometheus远程数据存储
分布式
- 提供了水平扩展能力,支持数百节点集群规模
海量时序数据高效管理
- 支持亿级时间线管理
- 内置高效数据压缩算法,存储成本只有传统关系数据库的1/20
部署灵活
- 部署只需运行编译生成的可执行文件,无需外部依赖
- 所有数据库配置参数均有合理的默认值,无需手动设置
- 支持单机和集群部署
三、openGemini有什么优势
3.1性能优势
针对物联网、运维监控等领域海量数据管理和分析的需求,openGemini对计算引擎和存储引擎做了大量的优化设计。
- 查询引擎,实现了向量化、分布式计算、算子下推、预聚合等多种查询优化和执行技术,提升了数据查询效率。在工业物联网、运维监控等场景中实现交互级的查询时延,并且在超大数据基数(万亿级)的情况下,也能够达到很低的查询时延。
- 存储引擎,设计列式数据存储格式,将多元时间序列数据按时间对齐,减少时间戳的重复存储,并开发了一套高效的存储引擎,实现了数据有序存储、数据分区分级、数据预取、稀疏索引等丰富功能。
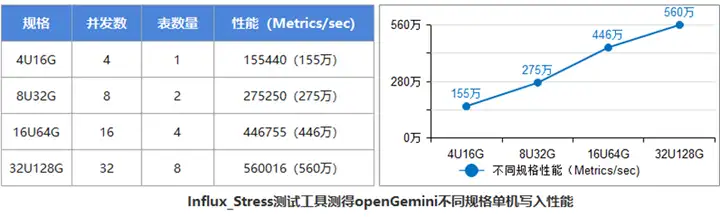
数据吞吐量和查询时延是评价一个时序数据库性能的关键指标,openGemini经过大量优化后,整体性能表现出色。下方的测试结果显示了openGemini 从4U扩展到32U的性能表现,可以看出:
- 从4U到32U,openGemini写入性能可以线性扩展(扩展比为0.8)
- 从4U的155万Metrics/s平稳增长到32U的560万Metrics/s
在业界流行的时序数据库Benchmark测试工具TSBS的15个标准测试场景中,openGemini性能表现优异,15个标准测试场景可分为简单查询、中等查询和复杂查询三大类型:
- 简单查询:少量或者没有使用函数或表达式,查询时间范围在24小时以内,查询时延数毫秒。
- 中等查询:使用多个函数或表达式,查询时间范围在几周内,并且使用了GROUP BY分组,查询时延在数十毫秒到数百毫秒。
- 复杂查询:使用了多个聚合函数或表达式,按月或者按年为时间范围查询,查询时延通常可能会达分钟级。
openGemini相比开源InfluxDB,简单查询场景提升2倍多,中等查询场景提升4倍多;复杂查询场景下,openGemini依然可以快速响应,然而InfluxDB则出现OOM无法工作。

3.2丰富的数据分析能力
时序数据采集的最终目的是让数据被理解和使用,数据分析是其中关键的一环。时序数据库具有广泛的应用场景,使得时序应用日益多样化,数据分析需求在不断变化和增加,这要求时序数据库能快速应对不同数据分析需求,不断丰富内部的分析算子。
与此同时,传统的大数据分析工具(比如Spark、Flink等)过于厚重,部署成本高;搭配时序数据库进行分析时,离数据较远,数据分析实时性无法满足要求。随着物联网、传感器技术、5G的快速发展,迫切需要一种更有效的方法来处理海量、高速的时序数据,而用户真正需要的是一个能够以最低时延和最高吞吐量处理、检测和预测信息的系统,这样的系统在业界开源的数据库中少之又少。
相对应的,openGemini具有丰富的聚合分析算子(COUNT、SUM、MAX、MIN等共计60余种)、统计分析算子(PERCENTILE分位数、HISTOGRAM直方图等)、异常检测和预测算子(内置13种异常检测器,可覆盖常见的离群点、数值变化、阈值、持续上升下降等时序异常场景)。其中基于AI的异常检测的实现过程中,充分考虑了数据分布,提供近数据计算能力,能提升端到端数据分析和计算效率。
3.3降低成本,增加效益
openGemini 源于华为云GaussDB for Influx,GaussDB for Influx已经在华为云许多内部重要业务上使用,通过技术的升级,替代了Cassandra、InfluxDB、HBase、OpenTSDB等多套系统部署,实现了降本增效。
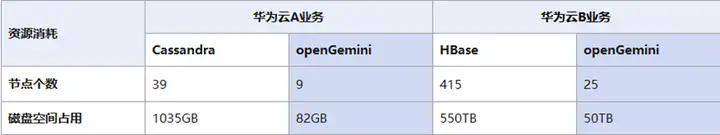
openGemini在承载相同业务场景下,较原系统端到端时延减低50%,CPU资源上可以节省68%,内存资源可以节省50%,硬盘资源可以节省90%以上。
四、为什么开源
开源是开放创新的有效手段,是数字时代的事实标准和专利。DB-Engines的统计数据表明,从 2021 年开始,开源数据库的流行指数已经超过商用数据库,开源时序数据库占比更是高达80%,openGemini时序数据库作为基础软件,也需要拥抱开源。


源于开源,回馈开源
openGemini时序数据库经历了几个发展阶段。从最初基于开源InfluxDB的架构改造,到应对内部数十亿海量时间线挑战,再到自研数据库引擎,一路打磨,经受住了华为云内、外部100余家用户的生产检验。openGemini现在以及将来取得的成绩,都离不开开源社区肥沃的土壤。openGemini的开源,希望可以倡导开源文化,以实际行动回馈开源。

开放合作,共建共享
我们深知独木难成林,百川聚江海的道理,但开源生态建设并非朝夕之功,也并非一个企业自身就能完成,而是一个聚沙成塔、集腋成裘的过程,唯有携手伙伴共建、共享,方能打造出健康繁荣的开源生态。我们希望把openGemini社区作为一个支点、一个开放创新平台,通过释放华为云内部多年积累的时序数据库技术研发和应用的实践经验,吸引更多的伙伴与开发者参与贡献,不断改善openGemini生态和竞争力,持续打造开放的技术产品和应用生态,使能物联网、工业互联网等行业数字化转型,促进产业协同,以应对生存环境愈发复杂,行业竞争愈发激烈,业务发展愈发多样的数字化时代。
版本说明
本次发布的v0.1.0是具有完整时序数据库功能的版本,详细信息请点击查看用户指南。
v0.1.0版本主要特性:
- 支持单机和分布式集群部署,高性能和可扩展
- 支持证书验证和用户鉴权
- 完全兼容InfluxDB Line Protocol v1、InfluxQL
- 支持Prometheus远程数据读写
- 支持Linux操作系统
- 丰富的内核运行指标(60余项),提供指标监测的工具ts-monitor
详细版本路标已发布,请前往社区查阅。
加入社区
为方便了解和参与社区贡献,我们为您准备了贡献指南。
其他
社区合作、寻求社区帮助、相关问题咨询渠道:
- 推荐在GitHub上给社区提交Issue和Discussion
- 发送邮件到openGemini社区邮箱(community.ts@opengemini.org),1-2个工作日内给与回复
- 加入openGemini社区微信交流群(微信添加 xiangyu5632,备注openGemini)
- 加入Slack。
openGemini官网主页: http://www.openGemini.org/
openGemini开源地址: https://github.com/openGemini
openGemini内核源码正式对外开源的更多相关文章
- 鸿蒙内核源码分析(源码注释篇) | 鸿蒙必定成功,也必然成功 | 百篇博客分析OpenHarmony源码 | v13.02
百篇博客系列篇.本篇为: v13.xx 鸿蒙内核源码分析(源码注释篇) | 鸿蒙必定成功,也必然成功 | 51.c.h .o 几点说明 kernel_liteos_a_note | 中文注解鸿蒙内核 ...
- git获取内核源码的方法
[转]http://www.360doc.com/content/17/0410/16/23107068_644444795.shtml 1. 前言 本文主要讲述ubuntu下通过git下载linux ...
- LiteOS内核源码分析:任务LOS_Schedule
摘要:调度,Schedule也称为Dispatch,是操作系统的一个重要模块,它负责选择系统要处理的下一个任务.调度模块需要协调处于就绪状态的任务对资源的竞争,按优先级策略从就绪队列中获取高优先级的任 ...
- 鸿蒙内核源码分析(GN应用篇) | GN语法及在鸿蒙的使用 | 百篇博客分析OpenHarmony源码 | v60.01
百篇博客系列篇.本篇为: v60.xx 鸿蒙内核源码分析(gn应用篇) | gn语法及在鸿蒙的使用 | 51.c.h.o 编译构建相关篇为: v50.xx 鸿蒙内核源码分析(编译环境篇) | 编译鸿蒙 ...
- v78.01 鸿蒙内核源码分析(消息映射篇) | 剖析LiteIpc(下)进程通讯机制 | 百篇博客分析OpenHarmony源码
百篇博客分析|本篇为:(消息映射篇) | 剖析LiteIpc(下)进程通讯机制 进程通讯相关篇为: v26.08 鸿蒙内核源码分析(自旋锁) | 当立贞节牌坊的好同志 v27.05 鸿蒙内核源码分析( ...
- Linux内核源码分析方法
一.内核源码之我见 Linux内核代码的庞大令不少人“望而生畏”,也正因为如此,使得人们对Linux的了解仅处于泛泛的层次.如果想透析Linux,深入操作系统的本质,阅读内核源码是最有效的途径.我们都 ...
- Linux基础系列—Linux内核源码目录结构
/** ****************************************************************************** * @author 暴走的小 ...
- Linux内核源码分析--内核启动之(3)Image内核启动(C语言部分)(Linux-3.0 ARMv7)
http://blog.chinaunix.net/uid-20543672-id-3157283.html Linux内核源码分析--内核启动之(3)Image内核启动(C语言部分)(Linux-3 ...
- Linux内核源码分析 day01——内存寻址
前言 Linux内核源码分析 Antz系统编写已经开始了内核部分了,在编写时同时也参考学习一点Linux内核知识. 自制Antz操作系统 一个自制的操作系统,Antz .半图形化半命令式系统,同时嵌入 ...
- 【转】Linux内核源码分析方法
一.内核源码之我见 Linux内核代码的庞大令不少人“望而生畏”,也正因为如此,使得人们对Linux的了解仅处于泛泛的层次.如果想透析Linux,深入操作系统的本质,阅读内核源码是最有效的途径.我们都 ...
随机推荐
- js性能优化解决办法
1. 减少http请求次数:CSS Sprites, JS.CSS 源码压缩.图片大小控制合适:网页 Gzip,CDN 托管,data 缓存 ,图片服务器 2. 前端模板 JS + 数据,减少由于HT ...
- 配置虚拟主机-部署nginx代理并验证缓存生效
1.虚拟主机的配置: 虚拟主机的作用: 虚拟主机提供了同一台服务器上运行多个网站的功能. 虚拟主机的三种模式: 1)基于域名配置虚拟主机是最常见的一种虚拟主机配置. 只需配置你的DNS服务器,将每 ...
- 游戏客户端开发中对MVC模式的思考
话说在前头,我分析MVC模式是为了确定自己要做的独立游戏的结构出来,并不适用于大型商业游戏的开发. MVC模式的概述 关于MVC模式,Model用于存储数据,View层用于显示数据,Controlle ...
- 【scipy 基础】--聚类
物以类聚,聚类算法使用最优化的算法来计算数据点之间的距离,并将它们分组到最近的簇中. Scipy的聚类模块中,进一步分为两个聚类子模块: vq(vector quantization):提供了一种基于 ...
- vscode编写keil工程项目
vscode 前言 1 安装vscode 2 安装插件 2.1 设置中文 2.2 安装Keil Assistant 2.3 常用安装 3 快捷键 前言 我使用vscode只是用来为了弥补keil编写的 ...
- L2-034 口罩发放
重点在阅读理解能力 身份证号必须是18位数字,话说平时咱们身份证也可以带个X啥的啊. 合法状态就是只要身份证合格就行,一开始我还想是它犯病,然后申请了口罩才算一个合法记录. 后边输出状态为1的人,一定 ...
- Vue06-Pinia
Pinia Pinia是西班牙语piña(西班牙语中的"菠萝")单词的形似. 它是一个状态管理的库,用于跨组件.页面进行状态共享(这点和Vuex.Redux一样),同时兼容Vue2 ...
- JAVA学习week3
本周由于c++小学期作业.未能按时学习JAVA 主要复习了基本语法 hello word 输出语法 输出格式的选择,进制的转换,注释的选择 还预习了变量相关的知识点
- 大数据开发要学什么java还是python?
在大数据开发领域,Java和Python都是备受青睐的编程语言.它们分别具有各自独特的特点和优势,在大数据处理方面也有不同的应用场景. 以下是对Java和Python在大数据开发中的应用.优势以及学习 ...
- 吉特日化MES配料工艺参数标准版-第二版
作者:情缘 出处:http://www.cnblogs.com/qingyuan/ 关于作者:从事仓库,生产软件方面的开发,在项目管理以及企业经营方面寻求发展之路 版权声明:本文版权归作者和博客园共有 ...