
lec-4-Introduction to Reinforcement Learning
模仿学习imitation learning与RL的不同
- 模仿学习中需要有专家指导的信息
- RL不需要访问专家信息
RL Definitions
- 奖励函数
- 马尔科夫决策链
- 只与上一个状态有关
- 目的
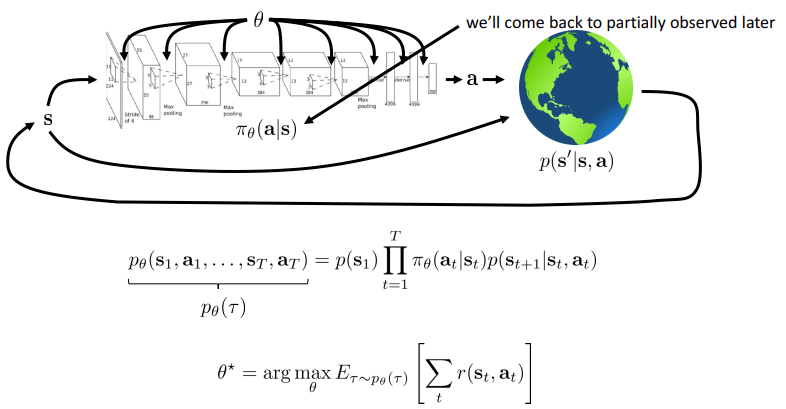
- 空间
- 有限
- 可找到最优参数
- 无限
- 证明p的概率分布是个平稳分布stationary distribution
- 有限
- 期望
- 由于奖励函数是不平滑的
- 转换: 但是可以优化 看似不平滑甚至稀疏的奖励功能(不平滑or不可微的期望) 在可微且平稳的概率下的函数
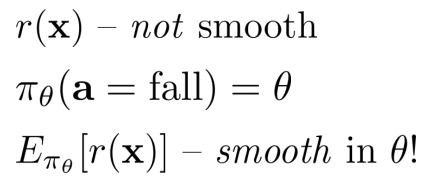
- 转换: 但是可以优化 看似不平滑甚至稀疏的奖励功能(不平滑or不可微的期望) 在可微且平稳的概率下的函数
- 由于奖励函数是不平滑的
算法
基本过程:
- 生成样本→调整模型/估计回报(评估policy)→提升策略policy→生成样本
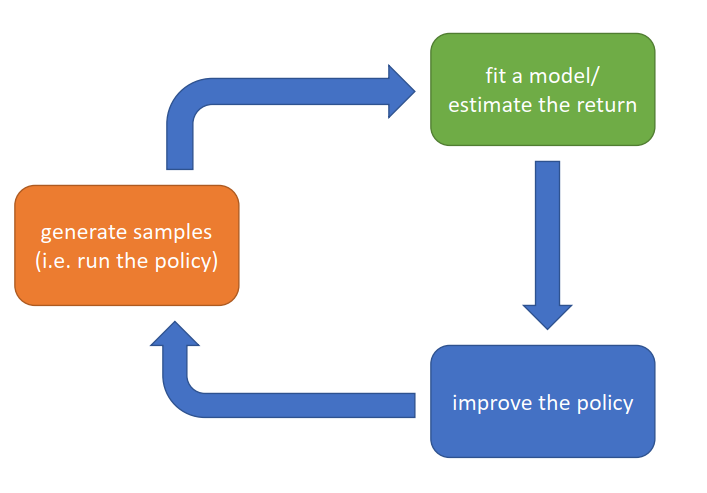
- 各部分代价
- 生成样本
Expensive:真实环境进行一次,也许代价会很高,机器人、车、电网等
cheap:模拟环境 - 评估policy
expensive:学习神经网络大量参数
cheap:MC等求均值等 - 提升policy
expensive:反向传播大量参数求导
cheap:回报均值梯度求导更新
- 生成样本
- 生成样本→调整模型/估计回报(评估policy)→提升策略policy→生成样本
Value Functions(基于值的)
- 核心:第二步(评估policy)使用Q-function or value function
- 定义
- 期望:
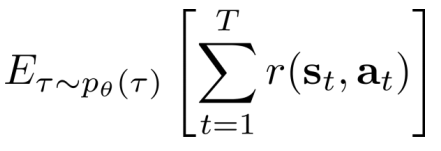
- Q-function:
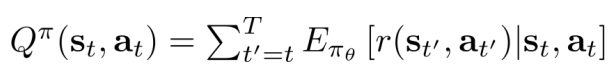
- Value function:
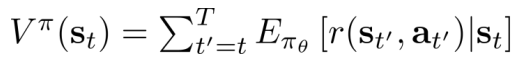
- 关系:
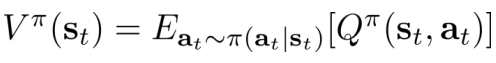
- Idea:
Policy iteration:Policy+Q-function → improve policy
比较QandV,if Q>V, 计算梯度增加动作概率
- 期望:
算法类型
- Policy gradients
- Value-based:拟合/评估Q、V
- Actor-critic
- Model-based RL:重点在提升policy上
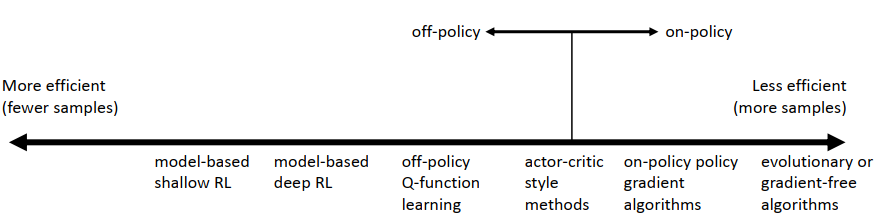
算法的tradeoffs(权衡)→以至于出现如此多算法
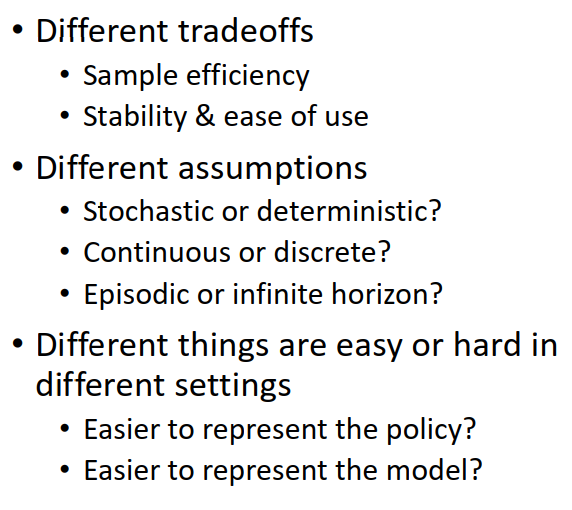
Sample efficiency
Stability and ease of use
- 值函数拟合:定点迭代
- 深度网络不能保证收敛性
- 基于模型的
- 收敛but不能保证model=better policy
- 策略梯度
- 只有一个在真正的目标上执行梯度下降(上升)的
- 值函数拟合:定点迭代
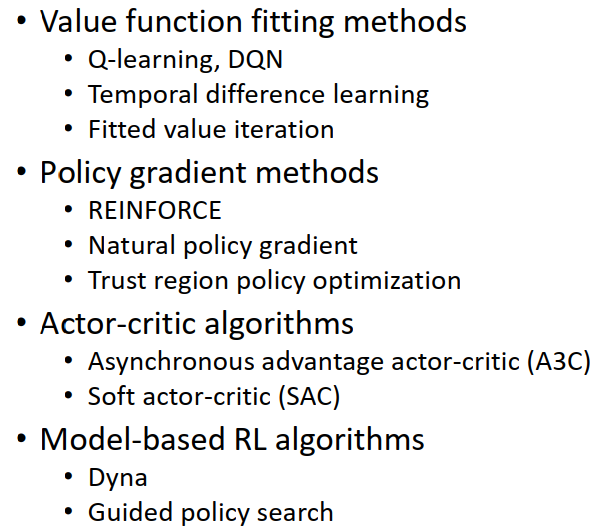
各类算法
Resource:CS285官网资料
版权归原作者 Lee_ing 所有
未经原作者允许不得转载本文内容,否则将视为侵权:转载或者引用本文内容请注明来源及原作者
lec-4-Introduction to Reinforcement Learning的更多相关文章
- Ⅰ Introduction to Reinforcement Learning
Dictum: To spark, often burst in hard stone. -- William Liebknecht 强化学习(Reinforcement Learning)是模仿人 ...
- 强化学习一:Introduction Of Reinforcement Learning
引言: 最近和实验室的老师做项目要用到强化学习的有关内容,就开始学习强化学习的相关内容了.也不想让自己学习的内容荒废掉,所以想在博客里面记载下来,方便后面复习,也方便和大家交流. 一.强化学习是什么? ...
- [转]Introduction to Learning to Trade with Reinforcement Learning
Introduction to Learning to Trade with Reinforcement Learning http://www.wildml.com/2018/02/introduc ...
- Introduction to Learning to Trade with Reinforcement Learning
http://www.wildml.com/2015/12/implementing-a-cnn-for-text-classification-in-tensorflow/ The academic ...
- (转) Deep Learning Research Review Week 2: Reinforcement Learning
Deep Learning Research Review Week 2: Reinforcement Learning 转载自: https://adeshpande3.github.io/ad ...
- (转)Applications of Reinforcement Learning in Real World
Applications of Reinforcement Learning in Real World 2018-08-05 18:58:04 This blog is copied from: h ...
- Training spiking neural networks for reinforcement learning
郑重声明:原文参见标题,如有侵权,请联系作者,将会撤销发布! 原文链接:https://arxiv.org/pdf/2005.05941.pdf Contents: Abstract Introduc ...
- 强化学习 reinforcement learning: An Introduction 第一章, tic-and-toc 代码示例 (结构重建版,注释版)
强化学习入门最经典的数据估计就是那个大名鼎鼎的 reinforcement learning: An Introduction 了, 最近在看这本书,第一章中给出了一个例子用来说明什么是强化学习, ...
- 深度强化学习(Deep Reinforcement Learning)入门:RL base & DQN-DDPG-A3C introduction
转自https://zhuanlan.zhihu.com/p/25239682 过去的一段时间在深度强化学习领域投入了不少精力,工作中也在应用DRL解决业务问题.子曰:温故而知新,在进一步深入研究和应 ...
- Reinforcement Learning: An Introduction读书笔记(3)--finite MDPs
> 目 录 < Agent–Environment Interface Goals and Rewards Returns and Episodes Policies and Val ...
随机推荐
- Activiti7开发(一)
0.前言 开发背景 项目开发设计审批工作流,企业微信的审批不错,但是下拉列表不支持后期添加,所以只能自己实现,通过gitee查找相关工作流的开源项目,参考有 闲鹿(RuoYi+Activiti6) h ...
- 红黑树(map与unorder_map)B B+树
红黑树(map) 这个里面有插入的几种方式:红黑树性质的理解 先说性质,1 每个节点要么红要么黑,2 一个节点为红色,左右两个孩子都是黑, 3 根节点是黑, 4 每个叶子(nil)节点都是黑色, 5 ...
- KMP 自动机,孤独的自动机(同时也是CF1721E的题解)
给定字符串 \(s\),以及 \(q\) 个串 \(t_i\),求将 \(s\) 分别与每个 \(t_i\) 拼接起来后,最靠右的 \(|t_i|\) 个前缀的 border 长度.询问间相互独立. ...
- 一个bug重温对JRE和JDK的关系思考
前几天做一个springboot项目时,导入的JAVA版本是17,然后后面想更贴近下企业中使用的JDK版本就改成了JDK 1,8,然后就编译错误,bug如下 java: java.lang.Unsup ...
- 记录hive一次数据倾斜问题的解决以及思考总结
解决数据倾斜是大数据开发中比较重要的能力,这个现象指的是分布式集群中,由于数据分发的不当,导致某个节点要处理的错误过多,导致整个计算机任务迟迟结束不了,甚至可能节点出现OOM使得任务失败 处理数据倾斜 ...
- 实现一个CRDT工具库——LWWReg
LWWReg LWW Register是一种数据结构,用于存储一个值和一个时间戳,支持读取和写入操作.在写入时,如果新的时间戳比原来的时间戳更大,那么就更新值和时间戳:在读取时,直接返回当前的值.这个 ...
- ACM-NEFUOJ-汉诺塔问题
P200汉诺塔 #include<bits/stdc++.h> using namespace std; int main() { int n,i; long long s[40]; s[ ...
- 商品获价API调用说明:获取商品历史价格信息 代码分享
接口名称:item_history_price 公共参数 名称 类型 必须 描述 key String 是 调用key(必须以GET方式拼接在URL中)(获取测试key和secret接入) secre ...
- C语言结构体大小分析
title: C语言结构体大小分析 author: saopigqwq233 date: 2022-04-05 C语言结构体大小分析 一,基本类型 C语言自带的数据类型大小如下 数据类型 大小(字节) ...
- [Nginx/Linux]Nginx从1.15.12平滑升级到1.17.5
1 问题背景 nginx 安全漏洞(CVE-2019-9511) nginx 安全漏洞(CVE-2019-9513) nginx 安全漏洞(CVE-2019-9516) http://www.cnnv ...