
elasticsearch如何设计集群
本文为博客园作者所写: 一寸HUI,个人博客地址:https://www.cnblogs.com/zsql/
在写本文时就在想,如果让你负责一个elasticsearch集群,从零开始,你会从哪些方面考虑?我们也知道es基本都是开箱即用,而且也很好用,配置参数也用默认的就好,只是这么简单的用不难,但是要想更好的用好es集群,那要怎么去做设计呢?我们知道想要用es集群,首先要安装es集群,当然es安装需要硬件,也就是服务器的支撑,如果安装好了es集群,也不能空跑吧,所以要有数据,所以要写入数据,当然写入数据是为了后期有所用,比如查询数据,做分析等。用是可以了,如果数据量增大,业务更加复杂,还要考虑如何更好的用,怎么用可以提高效率?一个集群也不可能只有一个人用呀,如果很多人用,就会存在不安全,需要考虑权限吧,想想也算健全了,但是万一哪天机器出问题了,数据丢失了怎么办?是不是需要做可靠的备份呢?如果整个集群完完了,又怎么办呢?当然这样的情况基本不可见,但是是不是要考虑进来呢?就算从安全和容错,以及性能方面都考虑清除了,集群正常运行了,很多时候都难免天有不测风云,是不是要经常关注整个集群或者索引的一些状态信息呢?不能时时刻刻盯着集群的健康状态吧,所以这里需要监控一下集群吧,当然到这里位置整个集群算是很好的运行起来了,但是后期随着数据量的增加,业务的增长,运维难度就会越来越大,所以前期的设计很重要,规范化管理很重要。大概就想了这么多,本文的内容也是围绕着这些问题进行展开的。有兴趣的请继续往下读。声明:本文是elasticsearch的版本为7.8.1
一、如何对机器进行选择
1、内存
如果有一种资源是最先被耗尽的,它可能是内存。排序和聚合都很耗内存,所以有足够的堆空间来应付它们是很重要的。即使堆空间是比较小的时候, 也能为操作系统文件缓存提供额外的内存。因为 Lucene 使用的许多数据结构是基于磁盘的格式,Elasticsearch 利用操作系统缓存能产生很大效果。
64 GB 内存的机器是非常理想的, 但是32 GB 和16 GB 机器也是很常见的。
2、磁盘
硬盘对所有的集群都很重要,对大量写入的集群更是加倍重要(例如那些存储日志数据的)。硬盘是服务器上最慢的子系统,这意味着那些写入量很大的集群很容易让硬盘饱和,使得它成为集群的瓶颈。
如果你负担得起 SSD,它将远远超出任何旋转介质(注:机械硬盘,磁带等)。 基于 SSD 的节点,查询和索引性能都有提升。如果你负担得起,SSD 是一个好的选择,如果使用了机械磁盘,使用 RAID 0 是提高硬盘速度的有效途径,对机械硬盘和 SSD 来说都是如此。没有必要使用镜像或其它 RAID 变体,因为高可用已经通过 replicas 内建于 Elasticsearch 之中,再不济,一台机器也多弄几个磁盘,这样在配置的可以指定多几个目录,这样能降低一个磁盘的io压力。
3、cpu
大多数 Elasticsearch 部署往往对 CPU 要求不高。因此,相对其它资源,具体配置多少个(CPU)不是那么关键。但是还是建议16核以上作为生产环境,因为elasticsearch的thread pool和这个配置直接相关。如果你要在更快的 CPUs 和更多的核心之间选择,选择更多的核心更好。多个内核提供的额外并发远胜过稍微快一点点的时钟频率。
4、网络
快速可靠的网络显然对分布式系统的性能是很重要的。 低延时能帮助确保节点间能容易的通讯,大带宽能帮助分片移动和恢复。现代数据中心网络(1 GbE, 10 GbE)对绝大多数集群都是足够的。Elasticsearch 假定所有节点都是平等的—并不会因为有一半的节点在150ms 外的另一数据中心而有所不同。更大的延时会加重分布式系统中的问题而且使得调试和排错更困难。
参考《ES权威指南》:https://www.elastic.co/guide/cn/elasticsearch/guide/current/hardware.html
二、集群安装要怎么配置和设计
2.1、系统设置
官网:https://www.elastic.co/guide/en/elasticsearch/reference/7.8/system-config.html
1、设置系统配置

ulimit #暂时修改,切换到该用户es,ulimit -n 65535

/etc/security/limits.conf #永久修改 es -  nofile  65535

ulimit -a #查看当前用户的资源限制

2、禁用sawpping

方式一:

swapoff -a #临时禁用所有的swap文件

vim /etc/fstab #注释掉所有的swap相关的行,永久禁用

方式二:

cat /proc/sys/vm/swappiness #查看该值

sysctl vm.swappiness=1 #临时修改该值为1

vim /etc/sysctl.conf #修改文件 永久生效

vm.swappiness = 1 #如果有该值,则修改该值,若没有,则追加该选项,sysctl -p生效命令

方式三:

配置elasticsearch.yml文件,添加如下配置:

bootstrap.memory_lock: true

GET _nodes?filter_path=**.mlockall  #检查如上配置是否成功

注意:如果试图分配比可用内存更多的内存,mlockall可能会导致JVM或shell会话退出!

3、配置文件描述符

ulimit -n 65535  #临时修改

vim /etc/security/limits.conf #永久修改

es         soft    nproc     65535

es         hard    nproc     65535

4、配置虚拟内存

sysctl -w vm.max_map_count=262144 #临时修改该值

vim /etc/sysctl.conf #永久修改

vm.max_map_count=262144

5、配置线程数

ulimit -u 4096 #临时修改

vim /etc/security/limits.conf #永久修改
2.2、基本安装配置
节点设计:
默认情况下,所有的节点都是master节点,data节点,ingest节点,ml节点(如果为true),数据节点也是transform节点
节点的类型:
- Master-eligible node 候选主节点node.master: true,主节点负责创建或删除索引,跟踪哪些节点是集群的一部分,以及决定将哪些碎片分配给哪些节点。所有的候选主节点在没有配置node.voting_only: true的情况下,都可以通过选举称为主节点。主节点必须能够访问data数据目录,也可以设置专用的主节点,一般至少选用3台,把其他的角色设置为false即可。
- Data node 用于数据的存储,CRUD,搜索,聚合等,node.data: true,数据节点保存包含已建立索引的文档的分片。数据节点处理与数据相关的操作,如CRUD、搜索和聚合。这些操作是I/O密集型、内存密集型和cpu密集型,也可以设置专用的数据节点
- Ingest node 用于数据前期的预处理,类似logstash,node node.ingest: true
- Machine learning node 用于运行作业和处理机器学习API请求
- Transform node 用于数据转换node.transform: true,如果是数据节点,则默认为true,否则false
- Coordinating node 协调节点,每个节点都是协调节点,不可关闭,协调节点将请求转发给持有数据的数据节点。每个数据节点在本地执行请求,并将其结果返回给协调节点。在收集阶段,协调节点将每个数据节点的结果减少为单个全局结果集
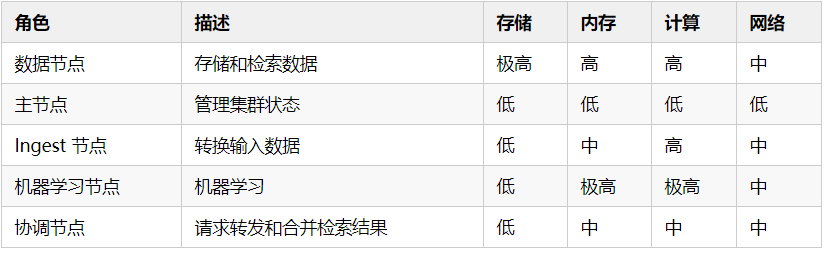
如果集群很小,机器不够用的情况下,可以把数据节点和主节点公用,如果想要主节点高可用的话,就要至少在3台机器上配置node.master:true,当然还可以更多,奇数就好了,如果机器很多,可以把主节点和数据节点分离,这样配置更加单一原则,主节点更加稳定,所以集群也会更加稳定。具体怎么配置见官网:https://www.elastic.co/guide/en/elasticsearch/reference/7.8/modules-node.html
再看看elasticsearch几个重要的配置:https://www.elastic.co/guide/en/elasticsearch/reference/7.8/important-settings.html
1、数据目录配置

path:

  data:

    - /mnt/elasticsearch_1

    - /mnt/elasticsearch_2

    - /mnt/elasticsearch_3

或者path.data: /data/es/es_cluster

2、log日志目录配置

path.logs: /data/es/es_cluster/elasticsearch-7.8.1/logs

3、集群名配置

cluster.name: es1304、节点名配置

node.name: prod-data-2

5、network.host配置

network.host: 192.168.88.130 #默认为回环地址127.0.0.1,生产环境需要修改

6、集群节点发现配置

discovery.seed_hosts: ["192.168.88.130","192.168.88.131","192.18.88.132] #例如集群三个节点

cluster.initial_master_nodes: ["es130","es131","es132"] #配置集群初始化首次启动符合主节点的列表
2.3、jdk相关配置
推荐使用elasticsearch自带的jdk,elasticsearch7.8.1默认的是openjdk 14,所以配置好jdk相关的JAVA_HOME就好
export JAVA_HOME=/data/es/elasticsearch-7.8.1/jdk

export PATH=$JAVA_HOME/bin:$PATH
还有一个重点配置就是java堆大小的配置,这个参数影响到太多的性能,如果内存允许的话,直接配上20-30G就好了,这里要注意堆的最大值和最小值要一样,不然启动的时候会检查这两个不一样就会报错。
参考官网:https://www.elastic.co/guide/en/elasticsearch/reference/7.8/heap-size.html
配置jvm.options 文件或者配置ES_JAVA_OPTS变量
配置文件config/jvm.options
自定义的jvm选项可以配置在config/jvm.options.d/文件夹下,必须以.options结尾的文件,这里只例举了一小部分配置,具体还有垃圾回收等相关配置
-Xms2g

-Xmx2g

8 :-Xmx2g #java8

8 -:- Xmx2g #大于java8

8 - 9 : - Xmx2g #java8到java9
export ES_JAVA_OPTS="$ES_JAVA_OPTS -Djava.io.tmpdir=/path/to/temp/dir"
设置Xmx和Xms你的物理内存不超过50%。Elasticsearch出于JVM堆以外的目的需要内存,因此为此留出空间很重要。
设置Xmx并且Xms不超过JVM用于压缩对象指针(JVM compressed oops)的阈值;确切的阈值有所不同,但接近32 GB(4-32G则启用UseCompressedOop;)
3.4、相关插件配置
1、ik分词插件配置
下载地址:https://github.com/medcl/elasticsearch-analysis-ik/releases
需要下载对应的版本,然后解压在plugins目录下,然后重启集群即可
2、head插件安装
header插件上手
https://github.com/mobz/elasticsearch-head
https://nodejs.org/zh-cn/download/
第一种:使用谷歌浏览器head插件
第二种:使用head服务
|
#Running with built in server git clone git://github.com/mobz/elasticsearch-head.git cd elasticsearch-head npm install npm run start open http://localhost:9100/ |
3、hdfs插件(用于备份还原)
下载:https://artifacts.elastic.co/downloads/elasticsearch-plugins/repository-hdfs/repository-hdfs-7.8.1.zip
安装文档:https://www.elastic.co/guide/en/elasticsearch/plugins/7.9/plugin-management-custom-url.html #7.9的文档不影响哈
具体执行:./bin/elasticsearch-plugin install file:///data/hd07/car/repository-hdfs-7.8.1.zip #这里不要忘记加file:///
然后需要重启ES的集群
三、索引要怎么设计
首先索引创建后,索引的分片只能通过_split和_shrink接口对其进行成倍的增加和缩减,主要是因为es的数据是通过_routing分配到各个分片上面的,所以本质上是不推荐去改变索引的分片数量的,因为这样都会对数据进行重新的移动。还有就是索引只能新增字段,不能对字段进行修改和删除,缺乏灵活性,所以每次都只能通过_reindex重建索引了。还有就是一个分片的大小以及所以分片数量的多少严重影响到了索引的查询和写入性能。所以可想而知,设计一个好的索引能够减少后期的运维管理和提高不少性能。所以前期对索引的设计是相当的重要的。
- 好的索引设计在整个集群规划中占据举足轻重的作用,索引的设计直接影响集群设计的好坏和复杂度。
- 好的索引设计应该是充分结合业务场景的时间维度和空间维度,结合业务场景充分考量增、删、改、查等全维度设计的。
- 好的索引设计是完全基于“设计先行,编码在后”的原则,前期会花很长时间,为的是后期工作更加顺畅,避免不必要的返工
索引的设计详情见我的另外一篇文章:elasticsearch如何设计索引
四、读写性能要怎么提升
读写就是插入和查询嘛,写的话可能有并发写,还有就是是否写完要立马可见,查的话还是和需求有关系,还有就是对查询一个语法的使用,还有就是查询数据会不会在内存中命中,这样的就减少去访问磁盘了,这里不说查询的一些语法和怎么查询更优,因为个人觉得这是属于应用级别的,和集群相关性不强,这里大概例举几个配置。
首先这里说一句,当并发写入的时候,必定涉及到thread pool的配置,这些配置不建议修改,但是实在不行,也可以提高到cpu核数的两倍,所以涉及到并发的,和计算的,当然cpu越好性能就会也好。
写和查询的时候会涉及到一些参数,可以根据实际情况调整提升性能:(下面的都不是默认值了,可以在官网去查询)
#可以配置在elasticsearch.yml文件中
indices.memory.index_buffer_size: 20%

indices.memory.min_index_buffer_size: 96mb

indices.queries.cache.size: 20%

indices.requests.cache.size: 2%


#这里是索引级别的配置,需要配置在索引里面

index.merge.scheduler.max_thread_count: 1 #这个如果是ssd,使用默认的配置就好,这里配置为机械磁盘

index.refresh_interval: 60s

index.store.type: hybridfs

index.translog.sync_interval: 10s

index.translog.flush_threshold_size: 1024mb
当然还有很多的配置,比如有配置translog的类型,可以提升性能,但是可能会牺牲数据的一致性。优化这种事情还是根据实际情况进行针对性的优化和取舍比较好。
五、权限要怎么控制
权限这个东西真的很重要,毕竟不是所有人操作起来都很小心,也不是所有人的技术都很牛逼,也不是所有人都不会偷偷的搞事情,所以这么重要的数据当然需要管控起来撒。
直接参考我的另外一篇博客吧,更加详细:elasticsearch7.8权限控制和规划
六、要怎么备份和还原
现在很多集群都是有多个副本,当然也是把容错机制看的很重要,在这种分布式的系统里面,数据的容错是非常重要的,比如elasticsearch,kafka,hdfs等,elasticsearch作为一个高速度的查询分布式集群,通过副本来进行容错,但是一般推荐副本为1,虽然大部分情况下是不会丢数据,但是难免会存在特殊情况。副本设置太多会影响性能,设置为1比较合适,但是如果一个分片的主分片和副分片所在的磁盘同时出问题呢,或者两台机器同时出问题呢,或者这几天操作异常,导致数据不正确,想恢复到几天前的索引呢,所以备份就显得尤为的重要了。
具体的备份还原详细文档请参考我的另一篇文章:elasticsearch备份和还原(基于hdfs)
七、怎么监控集群
集群正常运行了,我们需要经常关注集群的一些状态,或者节点级别,索引级别的一些状态,这些都是根据需求进行选择,比如对于我来说,关心集群的粒度既可以了。
这里监控可以选很多种,比如elk,zabbix,prometheus等,当然看自己熟悉什么了,就可以选用什么组件,不过elasticsearch这么特别的集群可以使用elk,毕竟ES也是elk中的一员。
看看elk监控的官方架构:(还需要一个es集群,不过节约点也可以一个集群,但是这样不稳妥)
官网:https://www.elastic.co/guide/en/elasticsearch/reference/7.8/monitoring-overview.html
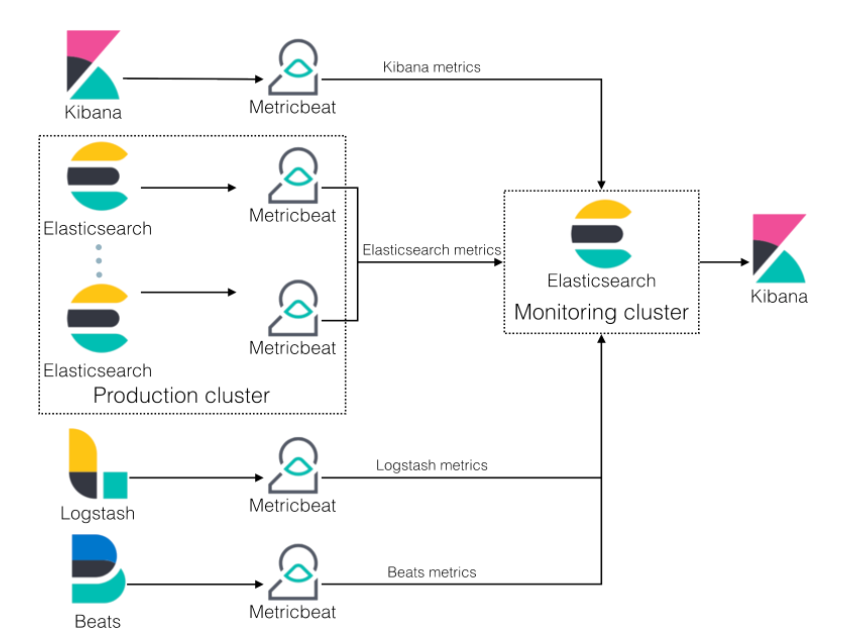
当然我是没有使用elk这样的监控,因为对zabbix比较数据,需求也不高,通过zabbix的web监控就搞定了,复杂点的可以使用elasticsearch的_cat API获取集群的相关状态信息,结合zabbix监控也很简单。
本文纯属个人的思考和想法,没有具体去实践(查询理论。。。),当然理论是可靠的。当然目前的思考可能也不会很全面,也不知道给博友有没有更好的建议呢?
参考:https://mp.weixin.qq.com/s?__biz=MzI2NDY1MTA3OQ%3D%3D&chksm=eaa82cfcdddfa5eacfcddb0cf54edcecb3ad86ca2cafd6f4f2d90cf8a4033d83eb16cb2a56f0&idx=1&mid=2247484628&scene=21&sn=666e416ae28b93e42c26f26b208dea84#wechat_redirect
elasticsearch如何设计集群的更多相关文章
- 全文搜索引擎 Elasticsearch 入门:集群搭建
本文主要介绍什么是 ElasticSearch 以及为什么需要它,如何在本机安装部署 ElasticSearch 实例,同时会演示安装 ElasticSearch 插件,以及如何在本地部署多实例集群, ...
- 原创 | 手摸手带您学会 Elasticsearch 单机、集群、插件安装(图文教程)
欢迎关注笔者的公众号: 小哈学Java, 每日推送 Java 领域干货文章,关注即免费无套路附送 100G 海量学习.面试资源哟!! 个人网站: https://www.exception.site/ ...
- 使用Spring Data ElasticSearch+Jsoup操作集群数据存储
使用Spring Data ElasticSearch+Jsoup操作集群数据存储 1.使用Jsoup爬取京东商城的商品数据 1)获取商品名称.价格以及商品地址,并封装为一个Product对象,代码截 ...
- Elasticsearch高级之-集群搭建,数据分片
目录 Elasticsearch高级之-集群搭建,数据分片 一 广播方式 二 单播方式 三 选取主节点 四 什么是脑裂 五 错误识别 Elasticsearch高级之-集群搭建,数据分片 es使用两种 ...
- 1.ElasticSearch系列之集群部署
第一步:安装JDK JDK要求jdk1.8+,不安装也可以,ES自带JDK 第二步:系统配置 2.1 禁用交换区 sudo swapoff -a 2.2 开最大文件数的限制 编辑文件 /etc/sec ...
- Elasticsearch分布式搜索集群配置
配置文件位于%ES_HOME%/config/elasticsearch.yml文件中,用Editplus打开它,你便可以进行配置. 所有的配置都可以使用环境变量,例如:node.rack: ${ ...
- Elasticsearch系列---生产集群的索引管理
概要 索引是我们使用Elasticsearch里最频繁的部分日常的操作都与索引有关,本篇从运维人员的视角,来玩一玩Elasticsearch的索引操作. 基本操作 在运维童鞋的视角里,索引的日常操作除 ...
- Elasticsearch 教程--分布式集群
集群 补充章节 正如前文提到的,这就是第个补充的章节,这里会介绍 Elasticsearch 如何在分布式环境中运行. 本章解释了常用术语,比如 集群 (cluster), 节点 (node) 以及 ...
- ElasticSearch之二——集群
ElasticSearch 集群 首先看下ElasticSearch(ES)的架构: 术语解释: cluster:代表一个集群,集群中有多个节点,其中有一个master节点,master通过选举自动产 ...
随机推荐
- 【Java】构造方法
成员变量声明时初始化和构造方法中初始化的区别 声明时为成员变量赋值,那每次创建这个类的对象都是同一个值. 构造方法初始化,每次创建对象时可以为每一个对象赋不同的值(此时要通过有参构造). 无返回值类型 ...
- Eclipse配置MySQL连接工具
1.项目名称右键新建文件夹lib 2.用鼠标将mysql-connector-java-5.1.15-bin.jar移动到lib文件夹中 3.选择Copy files点击OK 4.右键移动过来的mys ...
- Luogu P2408 不同子串个数【SAM】
P2408 不同子串个数 计算一个字符串的不同子串个数 两种方法,一种是\(dp\)出来\(SAM\)从起点开始的路径数量 另一种方法就是计算每个点的\(len[i]-len[link[i]]\)这个 ...
- zjnu1725 COCI (类似二维树状数组模拟)
Description The 3rd round of COCI is already here! In order to bet on predict the scores, we have as ...
- SPOJ 227 Ordering the Soldiers
As you are probably well aware, in Byteland it is always the military officer's main worry to order ...
- poj2362 Square
Description Given a set of sticks of various lengths, is it possible to join them end-to-end to form ...
- ASP.NET 部署IIS后如何访问共享目录文件
1.我的电脑-->管理-->系统工具-->本地用户和组-->用户-->右键新建用户-->创建一个与远程文件夹相同的账号密码! 如下图: 以上为部署接口服务器中的用户 ...
- 操作系统 part2
一.程序的内存结构 references: newcoder 运行时,程序分为:text段.data段.BSS段(2个合称数据段).堆.栈. text段:代码段,静态分配内存,只读. data段:初始 ...
- Git使用疑问
1.git操作是出现Username for 'https://github.com':的验证问题 Username for 'https://github.com': 输入的是github上的邮箱账 ...
- HTML <keygen> 标签(👎 已废弃)
HTML 标签( 已废弃) 该标签在新的 Web 标准中已废弃. <!DOCTYPE html> <html> <head> <meta charset=& ...