
MapReduce工作原理详解
MapReduce简介
MapReduce有哪些角色?各自的作用是什么?
MapReduce程序执行流程
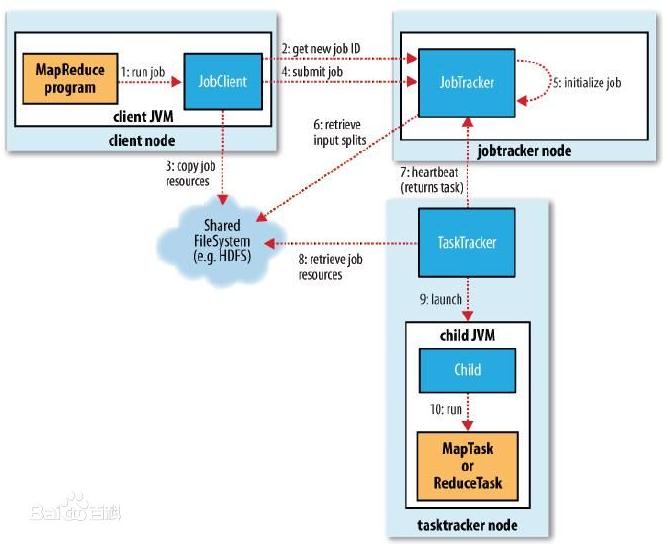
MapReduce工作原理
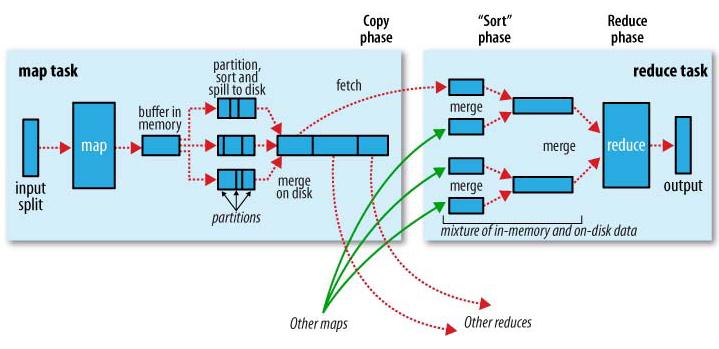
reduce task
MapReduce中Shuffle过程


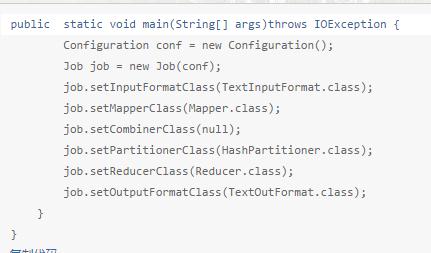
MapReduce编程主要组件
针对MapReduce的缺点,YARN解决了什么?
MapReduce工作原理详解的更多相关文章
- 块级格式化上下文(block formatting context)、浮动和绝对定位的工作原理详解
CSS的可视化格式模型中具有一个非常重要地位的概念——定位方案.定位方案用以控制元素的布局,在CSS2.1中,有三种定位方案——普通流.浮动和绝对定位: 普通流:元素按照先后位置自上而下布局,inli ...
- log4j-over-slf4j工作原理详解
log4j-over-slf4j工作原理详解 摘自:https://blog.csdn.net/john1337/article/details/76152906 置顶 2017年07月26日 17: ...
- Hadoop MapReduce八大步骤以及Yarn工作原理详解
Hadoop是市面上使用最多的大数据分布式文件存储系统和分布式处理系统, 其中分为两大块分别是hdfs和MapReduce, hdfs是分布式文件存储系统, 借鉴了Google的GFS论文. MapR ...
- ASP.NET页面与IIS底层交互和工作原理详解
转载自:http://www.cnblogs.com/lidabo/archive/2012/03/13/2393200.html 第一回: 引言 我查阅过不少Asp.Net的书籍,发现大多数作者都是 ...
- ASP.NET页面与IIS底层交互和工作原理详解(第一回)
引言 我查阅过不少Asp.Net的书籍,发现大多数作者都是站在一个比较高的层次上讲解Asp.Net.他们耐心.细致地告诉你如何一步步拖放控件.设置控件属性.编写CodeBehind代码,以实现某个特定 ...
- 交换机工作原理、MAC地址表、路由器工作原理详解
一:MAC地址表详解 说到MAC地址表,就不得不说一下交换机的工作原理了,因为交换机是根据MAC地址表转发数据帧的.在交换机中有一张记录着局域网主机MAC地址与交换机接口的对应关系的表,交换机就是根据 ...
- HTTP响应报文与工作原理详解
超文本传输协议(Hypertext Transfer Protocol,简称HTTP)是应用层协议.HTTP 是一种请求/响应式的协议,即一个客户端与服务器建立连接后,向服务器发送一个请求;服务器接到 ...
- 【转】HTTP响应报文与工作原理详解
超文本传输协议(Hypertext Transfer Protocol,简称HTTP)是应用层协议.HTTP 是一种请求/响应式的协议,即一个客户端与服务器建立连接后,向服务器发送一个请求;服务器接到 ...
- HTTP响应报文与工作原理详解(转)
超文本传输协议(Hypertext Transfer Protocol,简称HTTP)是应用层协议.HTTP 是一种请求/响应式的协议,即一个客户端与服务器建立连接后,向服务器发送一个请求;服务器接到 ...
随机推荐
- 《Java并发编程的艺术》笔记
第1章 并发编程的挑战 1.1 上下文切换 CPU通过时间片分配算法来循环执行任务,任务从保存到再加载的过程就是一次上下文切换. 减少上下文切换的方法有4种:无锁并发编程.CAS算法.使用最少线程.使 ...
- 解决flutter 运行时:Waiting for another flutter command to release the startup lock...
执行 Flutter 包管理相关命令时有可能遇到 Waiting for another flutter command to release the startup lock... 这样的错误,可尝 ...
- Bottleneck靶机渗透
Bottleneck 端口扫描,主机发现. 敏感目录为:http://192.168.114.165/image_gallery.php 在该目录下发现:http://192.168.114.165/ ...
- pwnable.kr-lotto-witeup
执行分析题目代码,发现是输入值和十进制是1到45的ASCII码系统生成对应字母做比较:而比较方法是遍历输入值的所有位和系统生成字符串的每个位作比较,相同计数为6则爆出flag.漏洞啊,只要押中有一字母 ...
- python类中的__init__和__new__方法
Python中类: Python中在创建类的过程中最先调用的不是__init__方法而是__new__方法,__new__方法是一个静态方法,在创建一个类对象时其实是通过__new__方法首先创建出一 ...
- @RequestParam,@RequestBody,@ResponseBody,@PathVariable注解的一点小总结
一.前提知识: http协议规定一次请求对应一次响应,根据不同的请求方式,请求的内容会有所不同: 发送GET请求是没有请求体的,参数会直接拼接保留到url后一并发送: 而POST请求是带有请求体的,带 ...
- Logback自定义日志颜色
片段 1 片段 2 LogbackColorful.java package cn.mrxionge.netdemo; import ch.qos.logback.classic.Level; imp ...
- Python练习题 035:Project Euler 007:第10001个素数
本题来自 Project Euler 第7题:https://projecteuler.net/problem=7 # Project Euler: Problem 7: 10001st prime ...
- Python练习题 023:比后面的人大2岁
[Python练习题 023] 有5个人坐在一起,问第五个人多少岁?他说比第4个人大2岁.问第4个人岁数,他说比第3个人大2岁.问第三个人,又说比第2人大两岁.问第2个人,说比第一个人大两岁.最后 问 ...
- Python练习题 016:猴子吃桃
[Python练习题 016] 猴子吃桃问题:猴子第一天摘下若干个桃子,当即吃了一半,还不瘾,又多吃了一个.第二天早上又将剩下的桃子吃掉一半,又多吃了一个.以后每天早上都吃了前一天剩下的一半零一个.到 ...