
Lucene学习笔记:基础
Lucence是Apache的一个全文检索引擎工具包。可以将采集的数据存储到索引库中,然后在根据查询条件从索引库中取出结果。索引库可以存在内存中或者存在硬盘上。
本文主要是参考了这篇博客进行学习的,原博客地址https://blog.csdn.net/bskfnvjtlyzmv867/article/details/80914156
主要开发流程是:采集数据,将数据转化成索引文档,然后存储在索引库中,索引库可以保存在内存中,或者保存在硬盘上。在查询的时候通过索引库查询结果,返回数据。
下面的例子主要是将Product表中的数据存储到索引库中,并通过索引库进行查询。项目依赖的jar包可以参考原博客,我用的Lucence版本是4.7。
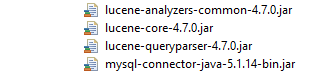
新建实体类Product,其代码如下:
public class Product {

    private Long id;

    private String title;

    private String sellPoint;

}
将Product实体转化成索引库中Document,并存到索引库中。Product数据可以从数据库中查询,然后通过此方法转化成索引库中的Document,此处省略从数据库查询Product的逻辑。
import java.io.IOException;

import java.nio.file.Path;

import java.nio.file.Paths;

import org.apache.lucene.analysis.Analyzer;

import org.apache.lucene.analysis.standard.StandardAnalyzer;

import org.apache.lucene.document.Document;

import org.apache.lucene.document.Field;

import org.apache.lucene.document.StringField;

import org.apache.lucene.document.TextField;

import org.apache.lucene.index.IndexWriter;

import org.apache.lucene.index.IndexWriterConfig;

import org.apache.lucene.store.Directory;

import org.apache.lucene.store.FSDirectory;

import org.apache.lucene.util.Version;

import entity.Product;

public class ProductRepository {

    public void createIndex(Product product) {

        Field id = new StringField("id", product.getId().toString(), Field.Store.YES);

        Field title = new TextField("title", product.getTitle().toString(), Field.Store.YES);

        Field sellPoint = new TextField("sellPoint", product.getSellPoint().toString(), Field.Store.YES);

        Document document = new Document();

        document.add(id);

        document.add(title);

        document.add(sellPoint);

        Analyzer analyzer = new StandardAnalyzer(Version.LUCENE_47);

        IndexWriterConfig config = new IndexWriterConfig(Version.LUCENE_47, analyzer);


        Path path = Paths.get("D:/develop/workspace/slem_compass/data");

        try {

            Directory directory = FSDirectory.open(path.toFile());

            IndexWriter indexWriter = new IndexWriter(directory, config);

            indexWriter.addDocument(document);

            indexWriter.close();

        } catch (IOException e) {

            e.printStackTrace();

        }

    }

}
其中上面的代码中Path是索引库在硬盘上的位置,我这里是放在D盘上的某个文件夹内。
下面如何从索引库中查询数据呢?我写了一个Servlet,用户提交查询关键字,request获取到后,根据关键字从索引库中查询数据。当然也可以用Main方法或者test测试类。
import java.io.IOException;

import java.nio.file.Path;

import java.nio.file.Paths;

import javax.servlet.ServletException;

import javax.servlet.annotation.WebServlet;

import javax.servlet.http.HttpServlet;

import javax.servlet.http.HttpServletRequest;

import javax.servlet.http.HttpServletResponse;

import org.apache.lucene.analysis.Analyzer;

import org.apache.lucene.analysis.standard.StandardAnalyzer;

import org.apache.lucene.document.Document;

import org.apache.lucene.index.DirectoryReader;

import org.apache.lucene.index.IndexReader;

import org.apache.lucene.queryparser.classic.QueryParser;

import org.apache.lucene.search.IndexSearcher;

import org.apache.lucene.search.Query;

import org.apache.lucene.search.ScoreDoc;

import org.apache.lucene.search.TopDocs;

import org.apache.lucene.store.Directory;

import org.apache.lucene.store.FSDirectory;

import org.apache.lucene.util.Version;

@WebServlet("/search")

public class SearchServlet extends HttpServlet {

    private static final long serialVersionUID = 1L;

    public SearchServlet() {

        super();

    }

    protected void doGet(HttpServletRequest request, HttpServletResponse response)

            throws ServletException, IOException {

        request.setCharacterEncoding("utf-8");

        Analyzer analyzer = new StandardAnalyzer(Version.LUCENE_47);

        QueryParser parser = new QueryParser(Version.LUCENE_47, "title", analyzer);

        String title = request.getParameter("title");

        System.out.println("");

        System.out.println("title: " + title);

        try {

            Query query = parser.parse(title);

            Path path = Paths.get("D:/develop/workspace/slem_compass/data");

            Directory directory = FSDirectory.open(path.toFile());

            IndexReader reader = DirectoryReader.open(directory);

            IndexSearcher indexSearcher = new IndexSearcher(reader);

            TopDocs topDocs = indexSearcher.search(query, 10);

            ScoreDoc[] scoreDocs = topDocs.scoreDocs;

            for (ScoreDoc scoreDoc : scoreDocs) {

                int docID = scoreDoc.doc;

                Document doc = indexSearcher.doc(docID);

                System.out.println(doc.get("id") + " " + doc.get("title") + " " + doc.get("sellPoint"));

            }

            System.out.println("");

            reader.close();

        } catch (Exception e) {

            e.printStackTrace();

        }

        response.setContentType("text/html;charset=utf-8");

        response.getWriter().append("Served at: ").append(request.getContextPath());

    }

    protected void doPost(HttpServletRequest request, HttpServletResponse response)

            throws ServletException, IOException {

        doGet(request, response);

    }

}
查询的时候也是从D盘上的索引库中读取相应的信息,然后根据关键字进行查询。
这样就完成了索引库的存储和查询。索引的查询很复杂,上面的demo只是一个比较简单的例子,说明大致的原理,后面继续补充索引的查询。
Lucene学习笔记:基础的更多相关文章
- jQuery学习笔记 - 基础知识扫盲入门篇
jQuery学习笔记 - 基础知识扫盲入门篇 2013-06-16 18:42 by 全新时代, 11 阅读, 0 评论, 收藏, 编辑 1.为什么要使用jQuery? 提供了强大的功能函数解决浏览器 ...
- Lucene学习笔记(更新)
1.Lucene学习笔记 http://www.cnblogs.com/hanganglin/articles/3453415.html
- Python学习笔记基础篇——总览
Python初识与简介[开篇] Python学习笔记——基础篇[第一周]——变量与赋值.用户交互.条件判断.循环控制.数据类型.文本操作 Python学习笔记——基础篇[第二周]——解释器.字符串.列 ...
- 数论算法 剩余系相关 学习笔记 (基础回顾,(ex)CRT,(ex)lucas,(ex)BSGS,原根与指标入门,高次剩余,Miller_Rabin+Pollard_Rho)
注:转载本文须标明出处. 原文链接https://www.cnblogs.com/zhouzhendong/p/Number-theory.html 数论算法 剩余系相关 学习笔记 (基础回顾,(ex ...
- 《python基础教程(第二版)》学习笔记 基础部分(第1章)
<python基础教程(第二版)>学习笔记 基础部分(第1章)python常用的IDE:Windows: IDLE(gui), Eclipse+PyDev; Python(command ...
- Java学习笔记——基础篇
Tips1:eclipse中会经常用到System.out.println方法,可以先输入syso,然后eclipse就会自动联想出这个语句了!! 学习笔记: *包.权限控制 1.包(package) ...
- Apache Lucene学习笔记
Hadoop概述 Apache lucene: 全球第一个开源的全文检索引擎工具包 完整的查询引擎和搜索引擎 部分文本分析引擎 开发人员在此基础建立完整的全文检索引擎 以下为转载:http://www ...
- iOS学习笔记——基础控件(上)
本篇简单罗列一下一些常用的UI控件以及它们特有的属性,事件等等.由于是笔记,相比起来不会太详细 UIView 所有UI控件都继承于这个UIView,它所拥有的属性必是所有控件都拥有,这些属性都是控件最 ...
- Lucene学习笔记
师兄推荐我学习Lucene这门技术,用了两天时间,大概整理了一下相关知识点. 一.什么是Lucene Lucene即全文检索.全文检索是计算机程序通过扫描文章中的每一个词,对每一个词建立一个索引,指明 ...
随机推荐
- 201772020113 李清华《面向对象程序设计(java)》第18周学习总结
1.实验目的与要求 (1) 综合掌握java基本程序结构: (2) 综合掌握java面向对象程序设计特点: (3) 综合掌握java GUI 程序设计结构: (4) 综合掌握java多线程编程模型: ...
- 浅谈 MongoDB
MongoDB 是一个基于分布式文件存储的数据库.由 C++ 语言编写.旨在为 WEB 应用提供可扩展的高性能数据存储解决方案.他支持的数据结构非常松散,是类似json的bson格式,因此可以存储比较 ...
- 秋日上新!H5活动之家营销平台升级大盘点!
H5活动之家活动营销平台,免费定制使用抽奖.投票.砍价.红包.互动.游戏等不同类型的微信营销活动. 近期多个活动进行了升级改造,更有集福卡持续热度,微助力火热上线等亮点:同时平台也进行了提高访问速度. ...
- 用java输入分数,得出分数等级
import java.util.Scanner;public class F { public static void main(String[] args) { // TODO 自动生成的方法 ...
- LR常用函数
web_set_max_html_param_len()--常用函数 设置可检索并保存为参数的任何HTML字符串的最大长度. intweb_set_max_html_param_len(const c ...
- linux上部署jenkins步骤小记
一.部署jdk环境 1.下载jdk包,解压,放在选定的位置,我本次jdk包放置在“/usr/local/java/jdk” 目录下 2.配置环境变量 1)打开/etc/profile文件,在命令框中输 ...
- 实现CNN卷积神经网络
以上是模型,下面是代码: import tensorflow as tf import numpy as np import time from tensorflow.examples.tutoria ...
- Jenkins Maven Selenium TestNG踩坑记
1)Maven TestNG什么的都配置好了,在本地用eclipse->Run AS->MAVEN INSTALL运行正常 2) Jenkins安装了插件,也建立了MAVEN项目.MAVE ...
- Java框架spring 学习笔记(二):Bean的作用域
Spring 框架Bean支持以下五个作用域: 下面介绍两种作用域,singleton和protoype singleton作用域 singleton作用域为默认作用域,在同一个ioc容器内getBe ...
- String主要方法
No 方法名称 类型 描述 1 (字符数组)public String(char[] value) 构造 将字符数组变为字符串(Sring类对象) 2 public String(char[] val ...