
python爬虫——《瓜子网》的广州二手车市场信息
由于多线程爬取数据比单线程的效率要高,尤其对于爬取数据量大的情况,效果更好,所以这次采用多线程进行爬取。具体代码和流程如下:
import math

import re

from concurrent.futures import ThreadPoolExecutor

import requests

import lxml

import lxml.etree

# 获取网页源代码

def getHtml(url, header):

    try:

        response = requests.get(url, headers=header)

        response.raise_for_status()

        return response.content.decode('utf-8')

    except:

        return ''

# 获取翻页url

def getPageUrl(url, response):

    mytree = lxml.etree.HTML(response)

    # 页码

    carNum = mytree.xpath('//*[@id="post"]/p[3]/text()')[0]

    carNum = math.ceil(int(re.findall('(\d+)', carNum)[0]) / 40)

    urlList = url.rsplit('/', maxsplit=1)

    pageUrlList = []

    if carNum != 0:

        for i in range(1, carNum + 1):

            pageUrl = urlList[0] + "/o" + str(i) + "/" + urlList[1]

            pageUrlList.append(pageUrl)

    return pageUrlList

# 获取汽车品牌

def getCarBrand(response):

    mytree = lxml.etree.HTML(response)

    # 汽车品牌url

    carBrandUrl = mytree.xpath('//div[@class="dd-all clearfix js-brand js-option-hid-info"]/ul/li/p/a/@href')

    # 汽车品牌名

    carBrandName = mytree.xpath('//div[@class="dd-all clearfix js-brand js-option-hid-info"]/ul/li/p/a/text()')

    carBrandDict = {}

    for i in range(len(carBrandName)):

        carBrandDict[carBrandName[i]] = "https://www.guazi.com" + carBrandUrl[i]

    return carBrandDict

# 获取汽车信息

def getCarInfo(pageUrl, carBrandName):

    response = getHtml(pageUrl, header)

    mytree = lxml.etree.HTML(response)

    for i in range(40):

        # 汽车名称

        carName = mytree.xpath('//ul[@class="carlist clearfix js-top"]/li/a/h2/text()')[i]

        # 汽车图片

        carPic = mytree.xpath('//ul[@class="carlist clearfix js-top"]/li/a/img/@src')[i]

        carPic = carPic.rsplit("jpg", maxsplit=1)[0] + 'jpg'

        # 汽车出产年份、里程数

        carInfo = mytree.xpath('//ul[@class="carlist clearfix js-top"]/li/a/div[1]/text()')[i]

        # 现价

        carCurrentPrice = mytree.xpath('//ul[@class="carlist clearfix js-top"]/li/a/div[2]/p/text()')[i] + "万"

        # 原价

        carOriginPrice = mytree.xpath('//ul[@class="carlist clearfix js-top"]/li/a/div[2]/em/text()')[i]

        print(carName, carPic, carInfo, carCurrentPrice, carOriginPrice)

        # 写入文件

        path = carBrandName + '.txt'

        with open(path, 'a+') as f:

            f.write(str((carName, carPic, carInfo, carCurrentPrice, carOriginPrice)) + '\n')

if __name__ == '__main__':

    url = 'https://www.guazi.com/gz/buy/'

    header = {

        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_5) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.85 Safari/537.36",

    }

    # 获得初始页源代码

    html = getHtml(url, header)

    # 获取汽车品牌信息字典

    carBrandDict = getCarBrand(html)

    # 多线程(10条的线程池)

    with ThreadPoolExecutor(10) as exT:

        # 程序执行流程

        # 根据汽车品牌进行爬取

        for carBrandName, carBrandUrl in carBrandDict.items():

            # 获取不同品牌页面源代码

            html = getHtml(carBrandUrl, header)

            # 获取当前品牌页面的页码url

            pageUrlList = getPageUrl(carBrandUrl, html)

            # 翻页

            for pageUrl in pageUrlList:

                # 获取汽车信息并写入文件

                exT.submit(getCarInfo, pageUrl, carBrandName)
结果如下:
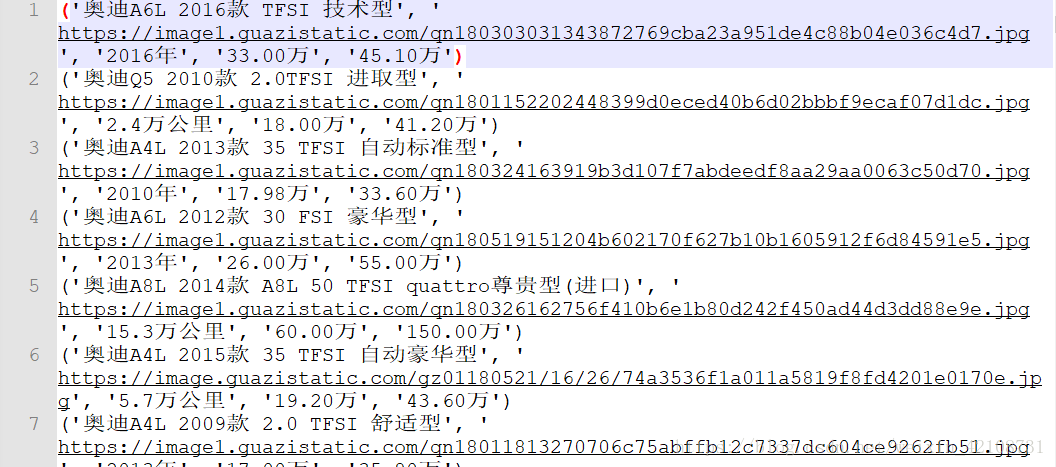
由于《瓜子网》更新过域名,所以之前有评论说网页打不开,现已做了处理,程序能正常爬取数据啦!
以上就是我的分享,如果有什么不足之处请指出,多交流,谢谢!
如果喜欢,请关注我的博客:https://www.cnblogs.com/qiuwuzhidi/
想获取更多数据或定制爬虫的请点击python爬虫专业定制
python爬虫——《瓜子网》的广州二手车市场信息的更多相关文章
- python爬虫实例--网易云音乐排行榜爬虫
网易云音乐,以前是有个api 链接的json下载的,现在没了, 只有音乐id,title , 只能看播放请求了, 但是播放请求都是加密的值,好坑... 进过各种努力, 终于找到了个大神写的博客,3.6 ...
- Python 爬虫 当当网图书 scrapy
目标站点需求分析 获取当当网每个图书名字和评论数 涉及的库 scrapy,mysql 获取解析单页源码 保存到数据库中 结果
- python爬虫 赶集网
#coding=utf-8import requestsfrom lxml import etreefrom sqlalchemy import create_enginefrom sqlalchem ...
- Python爬虫之爬取慕课网课程评分
BS是什么? BeautifulSoup是一个基于标签的文本解析工具.可以根据标签提取想要的内容,很适合处理html和xml这类语言文本.如果你希望了解更多关于BS的介绍和用法,请看Beautiful ...
- Python爬虫开源项目代码,爬取微信、淘宝、豆瓣、知乎、新浪微博、QQ、去哪网等 代码整理
作者:SFLYQ 今天为大家整理了32个Python爬虫项目.整理的原因是,爬虫入门简单快速,也非常适合新入门的小伙伴培养信心.所有链接指向GitHub,祝大家玩的愉快 1.WechatSogou [ ...
- python链家网高并发异步爬虫asyncio+aiohttp+aiomysql异步存入数据
python链家网二手房异步IO爬虫,使用asyncio.aiohttp和aiomysql 很多小伙伴初学python时都会学习到爬虫,刚入门时会使用requests.urllib这些同步的库进行单线 ...
- python爬虫:爬取慕课网视频
前段时间安装了一个慕课网app,发现不用注册就可以在线看其中的视频,就有了想爬取其中的视频,用来在电脑上学习.决定花两天时间用学了一段时间的python做一做.(我的新书<Python爬虫开发与 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- Python爬虫教程-15-读取cookie(人人网)和SSL(12306官网)
Python爬虫教程-15-爬虫读取cookie(人人网)和SSL(12306官网) 上一篇写道关于存储cookie文件,本篇介绍怎样读取cookie文件 cookie的读取 案例v16ssl文件:h ...
随机推荐
- 解析分布式应用框架Ray架构源码
摘要:Ray的定位是分布式应用框架,主要目标是使能分布式应用的开发和运行. Ray是UC Berkeley大学 RISE lab(前AMP lab) 2017年12月 开源的新一代分布式应用框架(刚发 ...
- Html5分页显示Table
Html: <!DOCTYPE html> <html> <head> <meta charset="utf-8"> <met ...
- Stone Game, Why are you always there? HDU - 2999
题目链接:https://vjudge.net/problem/HDU-2999 题意:有N堆石头,两个人交替取,每次只能取连续的k个石子,最后没有石子取得人输. 思路:如果我们每次取靠边的k个,那么 ...
- Caused by: java.lang.RuntimeException: JxBrowser license check failed: No valid license found
使用jxbrower报错,原因时证书检验失败, 解决方案: 1.首先创建证书,下面是我在IDEA maven项目中创建的位置,Java项目中在src/目录下创建, META-INF/teamdev.l ...
- (原创)在Linux上安装运行Python3(CentOS7为例)
在win10上开发好的python项目要部署在Linux上要面对的问题:怎么在Linux上跑py文件呢? 以Lunix CentOS7.x平台为例,CentOS系统上自带的已有python2.x 的版 ...
- java例题_35 找到最大值和最小值并交换位置
1 /*35 [程序 35 最大最小交换] 2 题目:输入数组,最大的与第一个元素交换,最小的与最后一个元素交换,输出数组. 3 */ 4 5 /*分析 6 * 1.先初始化一个数组,然后从键盘获得值 ...
- servlet学习(一)
Tomcat 注:以下资料摘自孙鑫的<sevlet/JSP深入详解>,仅用于个人学习使用. 一.web技术的发展 早期web是静态页面的浏览,使用HTML编写,放入服务器. 1.1浏览器请 ...
- [贪心]P1049 装箱问题
装箱问题 题目描述 有一个箱子容量为V(正整数,0≤V≤20000),同时有n个物品(0<n≤30),每个物品有一个体积(正整数). 要求n个物品中,任取若干个装入箱内,使箱子的剩余空间为最小. ...
- 201871030116-李小龙 实验三 结对项目—《D{0-1}KP 实例数据集算法实验平台》项目报告
项目 内容 课程班级博客链接 https://edu.cnblogs.com/campus/xbsf/2018CST 这个作业要求链接 https://www.cnblogs.com/nwnu-dai ...
- Dynamics CRM的Associate功能
Dynamics CRM有一种特殊的关联关系叫Associate,一般常见于为用户分配角色.给团队添加用户.团队添加角色.队列添加用户等等.在一些特定场景下我们不可能把所有的操作都通过手动来完成尤其是 ...