
Python爬虫教程-15-读取cookie(人人网)和SSL(12306官网)
Python爬虫教程-15-爬虫读取cookie(人人网)和SSL(12306官网)
上一篇写道关于存储cookie文件,本篇介绍怎样读取cookie文件
cookie的读取
# 读取cookie文件

from urllib import request,parse

from http import cookiejar

# 创建cookiejar的实例

cookie = cookiejar.MozillaCookieJar()

cookie.load('py15renrenCookie.txt', ignore_discard=True, ignore_expires=True)

# 常见cookie的管理器

cookie_handler = request.HTTPCookieProcessor(cookie)

# 创建http请求的管理器

http_handler = request.HTTPHandler()

# 生成https管理器

https_handler = request.HTTPSHandler()

# 创建请求管理器

opener = request.build_opener(http_handler,https_handler,cookie_handler)

def getHomePage():

    # 地址是用在浏览器登录后的个人信息页地址

    url = "http://www.renren.com/967487029/profile"

    # 如果已经执行login函数,则opener自动已经包含cookie

    rsp = opener.open(url)

    html = rsp.read().decode()

    with open("py13rsp.html", "w", encoding="utf-8")as f:

        # 将爬取的页面

        print(html)

        f.write(html)

if __name__ == '__main__':

    getHomePage()
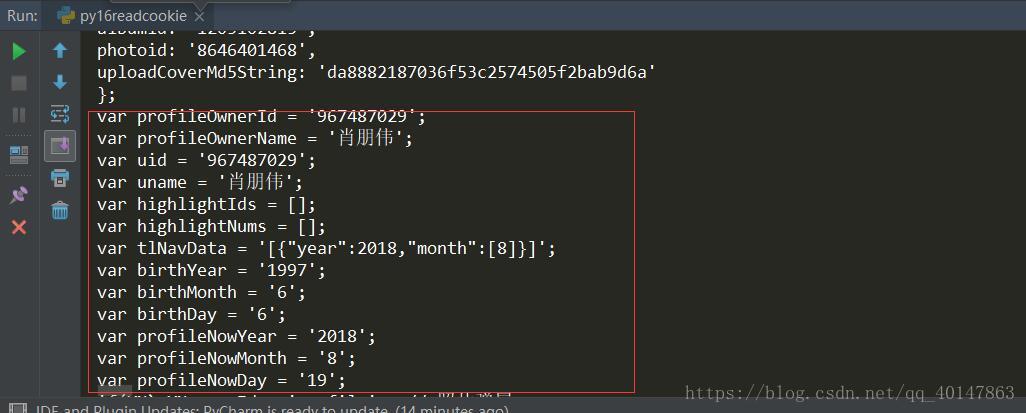
运行结果
同样是当返回页面有个人信息,才算成功!
SSL
- ssl证书就是指遵守ssl安全套阶层协议的服务器数字证书(SercureSocketLayer)
- 美国网景公司开发
- 使用ssl,加密信息
- 俗称https协议
- CA(CertificateAuthority)是数字证书任重中心,是发放,管理,废除数字证书的收信人的第三方机构
- 遇到不信任的SSL证书,需要单独处理
- 案例v17ssl文件:
'''

使用ssl

1.直接访问https://www.12306.cn/mormhweb/会无法访问,报错如下

 ----------------------------------

 您的连接不是私密连接

 攻击者可能会试图从 www.12306.cn 窃取您的信息

 (例如:密码、通讯内容或信用卡信息)

 -----------------------------------

2.不使用https使用http解可以访问

3.因为12306的证书是自己做的,而不是第三方机构

4.所以说http不安全会泄露个人信息

'''

from urllib import request

import ssl

# 利用非认证上下文环境替换认证的上下文环境

ssl._create_default_https_context = ssl._create_unverified_context

url = "https://www.12306.cn/mormhweb/"

rsp = request.urlopen(url)

html = rsp.read().decode()

print(html)
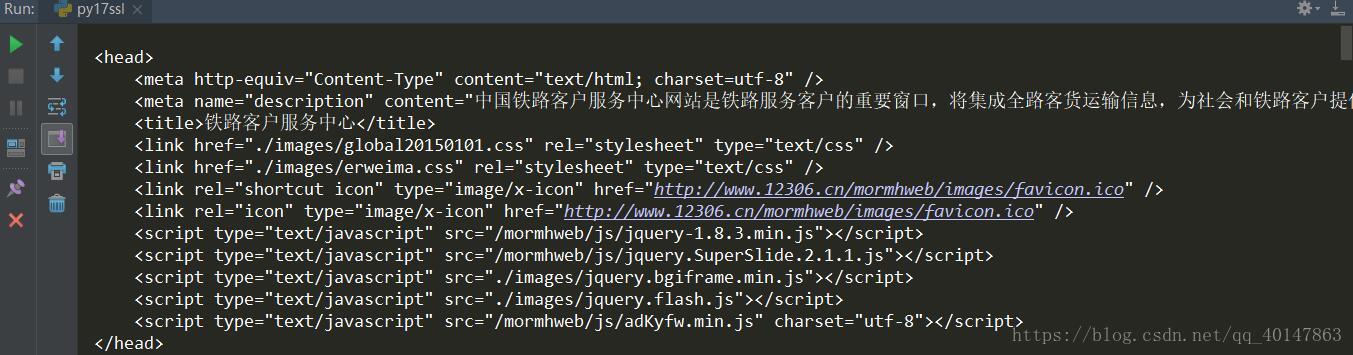
运行结果
不是报错页面,表示使用成功
更多文章链接:Python 爬虫随笔
- 本笔记不允许任何个人和组织转载
Python爬虫教程-15-读取cookie(人人网)和SSL(12306官网)的更多相关文章
- Python爬虫教程-01-爬虫介绍
Spider-01-爬虫介绍 Python 爬虫的知识量不是特别大,但是需要不停和网页打交道,每个网页情况都有所差异,所以对应变能力有些要求 爬虫准备工作 参考资料 精通Python爬虫框架Scrap ...
- Python爬虫教程-00-写在前面
鉴于好多人想学Python爬虫,缺没有简单易学的教程,我将在CSDN和大家分享Python爬虫的学习笔记,不定期更新 基础要求 Python 基础知识 Python 的基础知识,大家可以去菜鸟教程进行 ...
- Python爬虫教程-14-爬虫使用filecookiejar保存cookie文件(人人网)
Python爬虫教程-14-爬虫使用filecookiejar保存cookie文件(人人网) 上一篇介绍了利用CookieJar访问人人网,本篇将使用filecookiejar将cookie以文件形式 ...
- Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(人人网)(下)
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(下) 自动使用cookie的方法,告别手动拷贝cookie http模块包含一些关于cookie的模块,通过他们我们可以自动的使用co ...
- Python爬虫教程-12-爬虫使用cookie爬取登录后的页面(人人网)(上)
Python爬虫教程-12-爬虫使用cookie(上) 爬虫关于cookie和session,由于http协议无记忆性,比如说登录淘宝网站的浏览记录,下次打开是不能直接记忆下来的,后来就有了cooki ...
- Python爬虫入门六之Cookie的使用
大家好哈,上一节我们研究了一下爬虫的异常处理问题,那么接下来我们一起来看一下Cookie的使用. 为什么要使用Cookie呢? Cookie,指某些网站为了辨别用户身份.进行session跟踪而储存在 ...
- python爬虫 - Urllib库及cookie的使用
http://blog.csdn.net/pipisorry/article/details/47905781 lz提示一点,python3中urllib包括了py2中的urllib+urllib2. ...
- Python爬虫教程-31-创建 Scrapy 爬虫框架项目
本篇是介绍在 Anaconda 环境下,创建 Scrapy 爬虫框架项目的步骤,且介绍比较详细 Python爬虫教程-31-创建 Scrapy 爬虫框架项目 首先说一下,本篇是在 Anaconda 环 ...
- Python爬虫教程-30-Scrapy 爬虫框架介绍
从本篇开始学习 Scrapy 爬虫框架 Python爬虫教程-30-Scrapy 爬虫框架介绍 框架:框架就是对于相同的相似的部分,代码做到不出错,而我们就可以将注意力放到我们自己的部分了 常见爬虫框 ...
随机推荐
- C# 进程通信SendMessage和有关消息参数
SendMessage是啥? 函数原型: LRESULT SendMessage(HWND hWnd,UINT Msg,WPARAM wParam,LPARAM IParam)SendMessage( ...
- Java 的 List 与 Scala 的 Seq 相互转换
1. List 转 Seq: List<String> tmpList = new ArrayList<>(); tmpList.add("abc"); S ...
- [转] shell逻辑运算总结, 包括[[]]与[]的区别,&&与-a的区别,||与-o的区别
[From] https://www.cnblogs.com/tony1314/p/8315666.html 1. 关于文件和目录 -f 判断某普通文件是否存在 -d 判断某目录是否存在 -b ...
- Locust 类的使用
HttpLocust类 可定义多个HttpLocust类,即多个用户可执行不同的任务或者相同的任务,但是执行频率不一样,用weight进行约定. # coding:utf-8 from locust ...
- ubuntu 18 常用软件安装
主要内容 1.安装 Ubuntu 18.04 LTS 2.安装 Google Chrome 3.安装 OpenVPN Client 4.安装 Docker CE 5.安装 MySQL Server 转 ...
- 使用AChartEngine画动态曲线图
AChartEngine是一个开源的Android图表库,可以用来画折线图.平滑折线图.饼图.直方图等等.使用简单,功能强大. AChartEngine官网:http://www.achartengi ...
- Robot Framework(用户关键字)
在 Robot Framework 中关键字的创建分两种:系统关键字和用户关键字.系统关键字需要通过脚本开发相应的类和方法,这个我们将在后面的章节介绍.用户关键字的创建就要简单得多,它主要利用现有的系 ...
- React 同构开发(二)
React 同构 所谓同构,简单的说就是客户端的代码可以在服务端运行,好处就是能极大的提升首屏时间,避免白屏,另外同构也给SEO提供了很多便利. React 同构得益于 React 的虚拟 DOM.虚 ...
- nginx文件访问403问题
配置测试环境nginx时,增加了一个新的用户用来上传资源,所以想着就直接把静态资源放在新用户的home目录.为此,还特地设置了相应目录的所有用户都可以读取. chmod 755 /home/tom/s ...
- 关于React Hooks,你不得不知的事
React Hooks是React 16.8发布以来最吸引人的特性之一.在开始介绍React Hooks之前,让咱们先来理解一下什么是hooks.wikipedia是这样给hook下定义的: In c ...