
python 编码问题随笔
借用原作者的一句话“据说,每个做 Python 开发的都被字符编码的问题搞晕过,最常见的错误就是 UnicodeEncodeError、UnicodeDecodeError,你好像知道怎么解决,遗憾的是,错误又出现在其它地方,问题总是重蹈覆辙”(这里用“”还是‘’我居然停顿了一下。。。)抛玉引砖下面说说我自己的理解。先说python3中的文字编码问题,毕竟现在python3已经成为我自己的主流使用版本了。
编码和解码再认知
上来就先纠正自己的一个认知错误,之前认为编码是将二进制流字符化给人看的,毕竟从字面上理解是这样的,同理解码就是讲人可以看的字符二级制化给计算机存储传输,BUT我的理解刚好错了180度。编码是将字符编程二进制流的过程,不过具体二进制流是什么样的还和编码格式有关,同理解码就是讲二进制流变成可以看的字符的过程,对应的python中编码就是encode(),解码就是decode();不知道是我英文理解还是中文理解的有问题,感觉比较别扭,不过有一个关键词说服了我自己---“解码芯片”,所唯解码芯片就是将二进制的数据具体化的方法,如音频解码芯片,视频解码芯片,等等的。所以现在我就可以记住解码(decode())就是二进制输入其他输出,编码就是其他输入二进制输出。一下是在python3上进行的试验过程。

在python2中str和unicode还不是一样的,str就是二进制流组成了,而unicode是字符型的借用原文的一段代码
>>> s = '禅'

>>> s

'\xec\xf8'

>>> type(s)

<type 'str'>
unicode
>>> u = u"禅"

>>> u

u'\u7985'

>>> type(u)

<type 'unicode'>
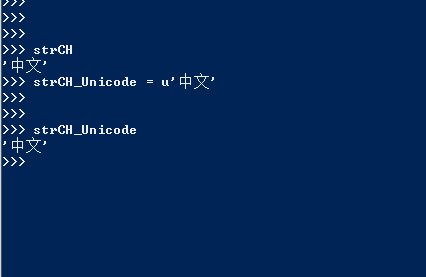
这是python2的特性,在python3中是这样的,所以说明在python3中str也是unicode字符,strCH_Unicode.encode之后的结果就是py2中的str了。
常见编解码错误
UnicodeEncodeError
UnicodeEncodeError 发生在 unicode 字符串转换成 str 字节序列的时候,来看一个python2中的例子,把一串 unicode 字符串保存到文件。
# -*- coding:utf-8 -*-

def main():

    name = u'Python之禅'

    f = open("output.txt", "w")

    f.write(name)
错误日志
UnicodeEncodeError: 'ascii' codec can't encode characters in position 6-7: ordinal not in range(128)
为什么会出现 UnicodeEncodeError?因为调用 write 方法时,Python 会先判断字符串是什么类型,如果是 str,就直接写入文件,不需要编码,因为 str 类型的字符串本身就是一串二进制的字节序列了。如果字符串是 unicode 类型,那么它会先调用 encode 方法把 unicode 字符串转换成二进制形式的 str 类型,才保存到文件,而 encode 方法会使用 python 默认的 ascii 码来编码
UnicodeDecodeError
UnicodeDecodeError 发生在 str 类型的字节序列解码成 unicode 类型的字符串时,这个问题在python的任何一个版本上都是可以试验验证出来的。一下为我在python3中的环境下验证出来的结果。

希望以后这种错误能少点出现,不过庆幸的是我用python2.7的时间不长。哈哈下班
python 编码问题随笔的更多相关文章
- 关于Python编码问题小记
Python编码问题小记: 引子: 最近在复习redis,当我在获取redis的key的时候,redis 存储英文和汉字下面这个样子的,我知道汉字是用16进制的UTF-8编码了,然后突然很想搞清楚字符 ...
- (转载) 浅谈python编码处理
最近业务中需要用 Python 写一些脚本.尽管脚本的交互只是命令行 + 日志输出,但是为了让界面友好些,我还是决定用中文输出日志信息. 很快,我就遇到了异常: UnicodeEncodeError: ...
- Python 编码简单说
先说说什么是编码. 编码(encoding)就是把一个字符映射到计算机底层使用的二进制码.编码方案(encoding scheme)规定了字符串是如何编码的. python编码,其实就是对python ...
- Python之路3【知识点】白话Python编码和文件操作
Python文件头部模板 先说个小知识点:如何在创建文件的时候自动添加文件的头部信息! 通过:file--settings 每次都通过file--setings打开设置页面太麻烦了!可以通过:View ...
- python编码规范
python编码规范 文件及目录规范 文件保存为 utf-8 格式. 程序首行必须为编码声明:# -*- coding:utf-8 -*- 文件名全部小写. 代码风格 空格 设置用空格符替换TAB符. ...
- 【转】python编码的问题
摘要: 为了在源代码中支持非ASCII字符,必须在源文件的第一行或者第二行显示地指定编码格式: # coding=utf-8 或者是: #!/usr/bin/python # -*- coding: ...
- 【转】python编码规范
http://blog.csdn.net/willhuo/article/details/49300441 决定开始Python之路了,利用业余时间,争取更深入学习Python.编程语言不是艺术,而是 ...
- python 编码 UnicodeDecodeError
将一个py脚本从Centos转到win运行,出错如下: UnicodeDecodeError: 'gbk' codec can't decode byte 0xff in position 0: il ...
- Python编码/文件读取/多线程
Python编码/文件读取/多线程 个人笔记~~记录才有成长 编码/文件读取/多线程 编码 常用的一般是gbk.utf-8,而在python中字符串一般是用Unicode来操作,这样才能按照单个字 ...
随机推荐
- 虚拟化kvm的搭建
虚拟化, 是指通过虚拟化技术将一台计算机虚拟为多台逻辑计算机 ,在一台计算机上同时运行多个逻辑计算机,每台逻辑计算机可运行不同的操作系统,并且应用程序都可以在相互独立的空间内运行而互不 ...
- vue.esm.js?efeb:628 [Vue warn]: Invalid prop: type check failed for prop "defaultActive". Expected String with value "0", got Number with value 0.
vue.esm.js?efeb:628 [Vue warn]: Invalid prop: type check failed for prop "defaultActive". ...
- 找不到:DarchetypeCatalog=local
设置IDEA Maven->Runner 界面的VM Options参数值为-DarchetypeCatalog=local 刷新项目Maven配置,在项目右边界面,重新引入Maven
- python基础(int,str,bool,list)
1数字int. 数字主要是用于计算用的,使用方法并不是很多,就记住一种就可以: bit_length() #bit_length() 当十进制用二进制表示时,最少使用的位数 v = 11 1 ...
- 详述C++casting操作
Casting----类型转换,也就是将数据从一种类型转换到另一种类型的操作.本文首先给出两种类型转换的方式:隐式转换和显式转换,然后简单介绍一下C语言常用的类型转换方式,最后详细叙述C++中常用的三 ...
- Spark动态加载外部资源文件
Spark动态加载外部资源文件 1.spark-submit --files 动态加载外部资源文件 之前做一个关于Spark的项目时,因项目中需要读取某个静态资源文件,然后在本地IDEA测试一切皆正常 ...
- 关于项目中Spring版本与jdk1.8兼容问题解决
问题描述: 在用公司的工具搭建项目时,由于使用Spring框架,同时要求jdk版本为1.8:当部署完成以后,项目总是无法运行,会报错: Context namespace element 'annot ...
- spark SQL (二) 聚合
聚合内置功能DataFrames提供共同聚合,例如count(),countDistinct(),avg(),max(),min(),等.虽然这些功能是专为DataFrames,spark SQL还拥 ...
- centos安装Qt
转:http://blog.csdn.net/wavelee/article/details/7855727 在编译Qt4.8.6版本的库时,在配置时 ./configure 出现了如下的错误: Ba ...
- java压缩图片设置宽高
package html2pdf_2; import java.awt.Image; import java.awt.image.BufferedImage; import java.io.File; ...