
Python简单网络爬虫实战—下载论文名称,作者信息(下)
在Python简单网络爬虫实战—下载论文名称,作者信息(上)中,学会了get到网页内容以及在谷歌浏览器找到了需要提取的内容的数据结构,接下来记录我是如何找到所有author和title的
1.从soup中get到data类
soup中提供了select方法来筛选所需的类。该方法使用方法如下:
articlename = soup.select('title')
该语句即将soup中所有的title元素放到articlename中。select也有其他用法
articlename = soup.select('.data') #类前面要加"."

articlename = soup.select('#username')#ID这种唯一的元素,前加"#"

articlename = soup.select('.publ-list .entry.editor .data')#可以组合查找,publ-list类下面的entry.editor类下面的data类,按次序用空格隔开

articlename = soup.select('.publ-list .entry.editor .data .title')[0].contents[0]#title类中第一个元素的第一个文本内容
我们用如下语句get到该网页中所有的data类,这样就包含了所有的author和title,去除了网页中其他无关的元素,离目标更近了一步
soup.select('.publ-list .entry.inproceedings .data')
2.data类中筛选所有author与title
这是一个data类的所有内容。

其中author元素还有更下一级的结构
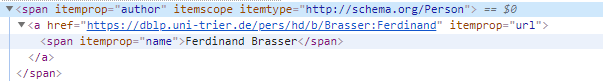
可以看到,一个data类中author和title元素并不是紧密连接的,在每个authro行之间,有“,”和“:”行隔开,在title行下方,还有dataPublished、genre等元素,但下方的元素都是固定的,行数也固定。因此我把一个.data描述为如下的多维数组:
[

[author1,url,name       ]

[","                    ]

[author2,url,name       ]

[":"                    ]

[<br>                   ]

[title,name             ]

["datePublished",content]

[</article>             ]

]
由于作者数量不固定,因此还要计算作者数量。因为每个author元素后面都会跟一个标点符号,因此似乎只要计算data类的长度减去4,再除以2就可以得到作者数量,然而在实际操作中发现,应该减去5。直到现在我也没有明白原因,可能这里需要补充HTML网站相关的知识。
authornum = int((len(articles)-5)/2)
得到了作者数量,就很容易定位到作者所在的行(下标)和title所在的行(下标)
观察元素内容可以看到,authorname和titlename都是唯一的文本,用以下命令获取即可
for i in range(0,authornum):

    authorlist.append(str(articles.contents[i*2].get_text()))

articlename = str(articles.contents[(authornum+1)*2].get_text())
至此,该脚本的所有难点都搞定啦,接下来就水到渠成,理一下逻辑就ok啦
Python简单网络爬虫实战—下载论文名称,作者信息(下)的更多相关文章
- Python开发网络爬虫抓取某同城房价信息
前言: 苦逼的我从某某城市换到另一个稍微大点的某某城市,面临的第一个问题就是买房,奋斗10多年,又回到起点,废话就不多说了,看看如何设计程序把某同城上的房价数据抓取过来. 方案:方案思路很简单,先把网 ...
- python网络爬虫实战PDF高清完整版免费下载|百度云盘|Python基础教程免费电子书
点击获取提取码:vg1y python网络爬虫实战帮助读者学习Python并开发出符合自己要求的网络爬虫.网络爬虫,又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动地抓取互联网信息的程序或者脚 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- Python 利用Python编写简单网络爬虫实例3
利用Python编写简单网络爬虫实例3 by:授客 QQ:1033553122 实验环境 python版本:3.3.5(2.7下报错 实验目的 获取目标网站“http://bbs.51testing. ...
- Python 利用Python编写简单网络爬虫实例2
利用Python编写简单网络爬虫实例2 by:授客 QQ:1033553122 实验环境 python版本:3.3.5(2.7下报错 实验目的 获取目标网站“http://www.51testing. ...
- Python 3网络爬虫开发实战》中文PDF+源代码+书籍软件包
Python 3网络爬虫开发实战>中文PDF+源代码+书籍软件包 下载:正在上传请稍后... 本书书籍软件包为本人原创,在这个时间就是金钱的时代,有些软件下起来是很麻烦的,真的可以为你们节省很多 ...
- Python 3网络爬虫开发实战中文 书籍软件包(原创)
Python 3网络爬虫开发实战中文 书籍软件包(原创) 本书书籍软件包为本人原创,想学爬虫的朋友你们的福利来了.软件包包含了该书籍所需的所有软件. 因为软件导致这个文件比较大,所以百度网盘没有加速的 ...
- Python 3网络爬虫开发实战中文PDF+源代码+书籍软件包(免费赠送)+崔庆才
Python 3网络爬虫开发实战中文PDF+源代码+书籍软件包+崔庆才 下载: 链接:https://pan.baidu.com/s/1H-VrvrT7wE9-CW2Dy2p0qA 提取码:35go ...
- 《Python 3网络爬虫开发实战中文》超清PDF+源代码+书籍软件包
<Python 3网络爬虫开发实战中文>PDF+源代码+书籍软件包 下载: 链接:https://pan.baidu.com/s/18yqCr7i9x_vTazuMPzL23Q 提取码:i ...
随机推荐
- VMware 虚拟机下载与安装
虚拟机下载 VMware官网地址:https://www.vmware.com/ 进行官网后,点击左边的下载图标,然后 根据操作系统选择合适的产品,在这里以Windows系统为例,点击转至下载,如下图 ...
- axios时遇到的Request Method: OPTIONS
前言 在请求axios 请求数据的时候,会出现options的,是因为请求是分为简单请求和复杂请求. 简单请求 满足下面两个条件的请求是简单请求: 请求方式是以下三种之一: HEAD GET POST ...
- hadoop fs –stat 命令
当向HDFS上写文件时,可以通过设置dfs.blocksize配置项来设置文件的block size,这导致HDFS上不同文件的block size是不同的.有时候我们需要知道HDFS上某个文件的bl ...
- 【jqGrid】翻页获取选中的值
1.实现效果: 点击确定所选按钮之后,获取翻页选中的题库表号 2.关键代码 onSelectAll: function (aRowids, status) { }, onSelectRow: func ...
- JavaScript一元运算符
㈠一元运算符 一元运算符,只需要一个操作数 ⑴+ 正号 正号不会对数值产生影响 示例: ⑵- 负号 负号可以对数字进行负号的取反 示例: ⑶对于非Number类型的值,它会将其先转换 ...
- RestFul是啥
1. 什么是REST REST全称是Representational State Transfer,中文意思是表述(编者注:通常译为表征)性状态转移. 它首次出现在2000年Roy Fielding的 ...
- Web上传超大文件解决方案
文件上传下载,与传统的方式不同,这里能够上传和下载10G以上的文件.而且支持断点续传. 通常情况下,我们在网站上面下载的时候都是单个文件下载,但是在实际的业务场景中,我们经常会遇到客户需要批量下载的场 ...
- Git 如何针对项目修改本地提交提交人的信息
Git 如果不进行修改的话,在默认情况下将会使用全局的用户名称和电子邮件. 但是在 GitHub 中是通过用户邮件来进行提交人匹配的. 如何针对项目来修改提交的用户信息? 针对 TortoiseGit ...
- thinkphp is NULL表达式写法
thinkphp 中如果这样写 $where['status']=array('EQ','NULL'),打印出来sql是WHERE ( `status` = 'NULL' ):而我想要的是 `sta ...
- Vue使用Axios实现http请求以及解决跨域问题
Axios 是一个基于 promise 的 HTTP 库,可以用在浏览器和 node.js 中.Axios的中文文档以及github地址如下: 中文:https://www.kancloud.cn/y ...