
【Explain】mysql之explain详解(分析索引的最佳使用)
在日常工作中,我们会有时会开慢查询去记录一些执行时间比较久的SQL语句,找出这些SQL语句并不意味着完事了,些时我们常常用到explain 这个命令来查看一个这些SQL语句的执行计划,查看该SQL语句有没有使用上了索引,有没有做全表扫描,这都可以通过explain命令来查看。所以我们 深入了解MySQL的基于开销的优化器,还可以获得很多可能被优化器考虑到的访问策略的细节,以及当运行SQL语句时哪种策略预计会被优化器采用。 (QEP:sql生成一个执行计划query Execution plan)

mysql> explain select * from servers;

+----+-------------+---------+------+---------------+------+---------+------+------+-------+

| id | select_type | table   | type | possible_keys | key  | key_len | ref  | rows | Extra |

+----+-------------+---------+------+---------------+------+---------+------+------+-------+

|  1 | SIMPLE      | servers | ALL  | NULL          | NULL | NULL    | NULL |    1 | NULL  |

+----+-------------+---------+------+---------------+------+---------+------+------+-------+

1 row in set (0.03 sec)
expain出来的信息有10列,分别是id、select_type、table、type、possible_keys、key、key_len、ref、rows、Extra,下面对这些字段出现的可能进行解释:
一、 id
我的理解是SQL执行的顺序的标识,SQL从大到小的执行
1. id相同时,执行顺序由上至下
2. 如果是子查询,id的序号会递增,id值越大优先级越高,越先被执行
3.id如果相同,可以认为是一组,从上往下顺序执行;在所有组中,id值越大,优先级越高,越先执行
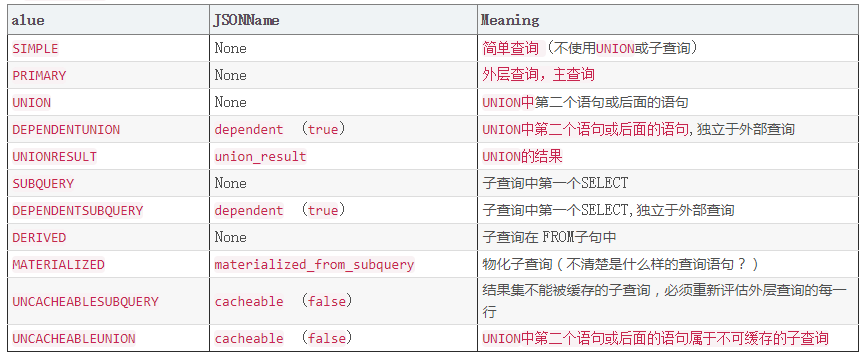
二、select_type
示查询中每个select子句的类型
(1) SIMPLE(简单SELECT,不使用UNION或子查询等)
(2) PRIMARY(查询中若包含任何复杂的子部分,最外层的select被标记为PRIMARY)
(3) UNION(UNION中的第二个或后面的SELECT语句)
(4) DEPENDENT UNION(UNION中的第二个或后面的SELECT语句,取决于外面的查询)
(5) UNION RESULT(UNION的结果)
(6) SUBQUERY(子查询中的第一个SELECT)
(7) DEPENDENT SUBQUERY(子查询中的第一个SELECT,取决于外面的查询)
(8) DERIVED(派生表的SELECT, FROM子句的子查询)
(9) UNCACHEABLE SUBQUERY(一个子查询的结果不能被缓存,必须重新评估外链接的第一行)
如下:
三、table
有可能是
实际的表名 如select * from t1;
表的别名 如 select * from t2 as tmp;
derived 如from型子查询时(来自于子查询的派生表)
null 直接计算得结果,不用走表,例如select 1+2
显示这一行的数据是关于哪张表的,有时不是真实的表名字,看到的是derivedx(x是个数字,我的理解是第几步执行的结果)
mysql> explain select * from (select * from ( select * from t1 where id=2602) a) b;

+----+-------------+------------+--------+-------------------+---------+---------+------+------+-------+

| id | select_type | table      | type   | possible_keys     | key     | key_len | ref  | rows | Extra |

+----+-------------+------------+--------+-------------------+---------+---------+------+------+-------+

|  1 | PRIMARY     | <derived2> | system | NULL              | NULL    | NULL    | NULL |    1 |       |

|  2 | DERIVED     | <derived3> | system | NULL              | NULL    | NULL    | NULL |    1 |       |

|  3 | DERIVED     | t1         | const  | PRIMARY,idx_t1_id | PRIMARY | 4       |      |    1 |       |

+----+-------------+------------+--------+-------------------+---------+---------+------+------+-------+
四、type(重要)
表示MySQL在表中找到所需行的方式,又称“访问类型”。是分析”查数据过程”的重要依据
常用的类型有: ALL, index, range, ref, eq_ref, const, system, NULL(从左到右,性能从差到好)
ALL:Full Table Scan, MySQL将遍历全表以找到匹配的行 ,逐行做全表扫描.,运气不好扫描到最后一行. (说明语句写的很失败)
index: Full Index Scan,index与ALL区别为index类型只遍历索引树,相当于data_all index 扫描所有的索引节点,相当于index_all
range:只检索给定范围的行,使用一个索引来选择行,能根据索引做范围的扫描
ref: 表示上述表的连接匹配条件,即哪些列或常量被用于查找索引列上的值,通过索引列,可以直接引用到某些数据行
eq_ref: 类似ref,区别就在使用的索引是唯一索引,对于每个索引键值,表中只有一条记录匹配,简单来说,就是多表连接中使用primary key或者 unique key作为关联条件
const、system: 当MySQL对查询某部分进行优化,并转换为一个常量时,使用这些类型访问。如将主键置于where列表中,MySQL就能将该查询转换为一个常量,system是const类型的特例,当查询的表只有一行的情况下,使用system
NULL: MySQL在优化过程中分解语句,执行时甚至不用访问表或索引,例如从一个索引列里选取最小值可以通过单独索引查找完成。
const、system、NULL指查询优化到常量级别, 甚至不需要查找时间.
五、possible_keys
注意: 系统估计可能用的几个索引,但最终,只能用1个.
指出MySQL能使用哪个索引在表中找到记录,查询涉及到的字段上若存在索引,则该索引将被列出,但不一定被查询使用
该列完全独立于EXPLAIN输出所示的表的次序。这意味着在possible_keys中的某些键实际上不能按生成的表次序使用。
如果该列是NULL,则没有相关的索引。在这种情况下,可以通过检查WHERE子句看是否它引用某些列或适合索引的列来提高你的查询性能。如果是这样,创造一个适当的索引并且再次用EXPLAIN检查查询
六、Key
key列显示MySQL实际决定使用的键(索引)
如果没有选择索引,键是NULL。要想强制MySQL使用或忽视possible_keys列中的索引,在查询中使用FORCE INDEX、USE INDEX或者IGNORE INDEX。
七、key_len
表示索引中使用的字节数,可通过该列计算查询中使用的索引的长度(key_len显示的值为索引字段的最大可能长度,并非实际使用长度,即key_len是根据表定义计算而得,不是通过表内检索出的)
不损失精确性的情况下,长度越短越好
八、ref
表示上述表的连接匹配条件,即哪些列或常量被用于查找索引列上的值
九、rows
表示MySQL根据表统计信息及索引选用情况,估算的找到所需的记录所需要读取的行数
有时候结果集中多一列filtered

为什么Mysql explain extended中的filtered列值总是100%

执行Mysql的explain extended的输出会比单纯的explain多一列filtered(MySQL .7缺省就会输出filtered),它指返回结果的行占需要读到的行(rows列的值)的百分比。按说filtered是个非常有用的值,因为对于join操作,前一个表的结果集大小直接影响了循环的次数。但是我的环境下测试的结果却是,filtered的值一直是100%,也就是说失去了意义。

参考下面mysql .6的代码,filtered值只对index和all的扫描有效(这可以理解,其它场合,通常rows值就等于估算的结果集大小。)。
十、Extra
性能从好到坏:useing index>usinh where > using temporary | using filesort
该列包含MySQL解决查询的详细信息,有以下几种情况:
Using temporary:表示MySQL需要使用临时表来存储结果集,常见于排序和分组查询
Using filesort:MySQL中无法利用索引完成的排序操作称为“文件排序”
Using where:列数据是从仅仅使用了索引中的信息而没有读取实际的行动的表返回的,这发生在对表的全部的请求列都是同一个索引的部分的时候,表示mysql服务器将在存储引擎检索行后再进行过滤
Using join buffer:改值强调了在获取连接条件时没有使用索引,并且需要连接缓冲区来存储中间结果。如果出现了这个值,那应该注意,根据查询的具体情况可能需要添加索引来改进能。
Impossible where:这个值强调了where语句会导致没有符合条件的行。
Select tables optimized away:这个值意味着仅通过使用索引,优化器可能仅从聚合函数结果中返回一行
useing index代表索引覆盖,就是查询的列正好在索引中,不用回物理行查询数据。参考http://www.cnblogs.com/qlqwjy/p/8593076.html
执行Mysql的explain extended的输出会比单纯的explain多一列filtered(MySQL .7缺省就会输出filtered),它指返回结果的行占需要读到的行(rows列的值)的百分比。按说filtered是个非常有用的值,因为对于join操作,前一个表的结果集大小直接影响了循环的次数。但是我的环境下测试的结果却是,filtered的值一直是100%,也就是说失去了意义。

filtered值只对index和all的扫描有效(这可以理解,其它场合,通常rows值就等于估算的结果集大小。)
总结:
• EXPLAIN不会告诉你关于触发器、存储过程的信息或用户自定义函数对查询的影响情况
• EXPLAIN不考虑各种Cache
• EXPLAIN不能显示MySQL在执行查询时所作的优化工作
• 部分统计信息是估算的,并非精确值
• EXPALIN只能解释SELECT操作,其他操作要重写为SELECT后查看执行计划。
【Explain】mysql之explain详解(分析索引的最佳使用)的更多相关文章
- 【详细解析】MySQL索引详解( 索引概念、6大索引类型、key 和 index 的区别、其他索引方式)
[详细解析]MySQL索引详解( 索引概念.6大索引类型.key 和 index 的区别.其他索引方式) MySQL索引的概念: 索引是一种特殊的文件(InnoDB数据表上的索引是表空间的一个组成部分 ...
- Mysql加锁过程详解(8)-理解innodb的锁(record,gap,Next-Key lock)
Mysql加锁过程详解(1)-基本知识 Mysql加锁过程详解(2)-关于mysql 幻读理解 Mysql加锁过程详解(3)-关于mysql 幻读理解 Mysql加锁过程详解(4)-select fo ...
- MySQL数据库优化详解(收藏)
MySQL数据库优化详解 mysql表复制 复制表结构+复制表数据mysql> create table t3 like t1;mysql> insert into t3 select * ...
- MySQL 执行计划详解
我们经常使用 MySQL 的执行计划来查看 SQL 语句的执行效率,接下来分析执行计划的各个显示内容. EXPLAIN SELECT * FROM users WHERE id IN (SELECT ...
- Mysql加锁过程详解(5)-innodb 多版本并发控制原理详解
Mysql加锁过程详解(1)-基本知识 Mysql加锁过程详解(2)-关于mysql 幻读理解 Mysql加锁过程详解(3)-关于mysql 幻读理解 Mysql加锁过程详解(4)-select fo ...
- Mysql加锁过程详解(1)-基本知识
Mysql加锁过程详解(1)-基本知识 Mysql加锁过程详解(2)-关于mysql 幻读理解 Mysql加锁过程详解(3)-关于mysql 幻读理解 Mysql加锁过程详解(4)-select fo ...
- Mysql 三大特性详解
Mysql 三大特性详解 Mysql Innodb后台线程 工作方式 首先Mysql进程模型是单进程多线程的.所以我们通过ps查找mysqld进程是只有一个. 体系架构 InnoDB存储引擎的架构如下 ...
- MySQL关闭过程详解和安全关闭MySQL的方法
MySQL关闭过程详解和安全关闭MySQL的方法 www.hongkevip.com 时间: -- : 阅读: 整理: 红客VIP 分享到: 红客VIP(http://www.hongkevip.co ...
- HttpRuntime详解分析
HttpRuntime详解分析(上) 文章内容 从上章文章都知道,asp.net是运行在HttpRuntime里的,但是从CLR如何进入HttpRuntime的,可能大家都不太清晰.本章节就是通过深入 ...
- Mysql加锁过程详解(9)-innodb下的记录锁,间隙锁,next-key锁
Mysql加锁过程详解(1)-基本知识 Mysql加锁过程详解(2)-关于mysql 幻读理解 Mysql加锁过程详解(3)-关于mysql 幻读理解 Mysql加锁过程详解(4)-select fo ...
随机推荐
- 利用css3的text-shadow属性实现文字阴影乳白效果
现在CSS3+html5的网页应用的越来越广泛了.很多网页中的字体同样可以用CSS3来实现炫酷的效果. 下面就介绍一下利用css3的text-shadow属性实现文字阴影乳白效果.这是在设计达人上面看 ...
- 【bzoj4695】最假女选手 线段树区间最值操作
题目描述 给定一个长度为 N 序列,编号从 1 到 N .要求支持下面几种操作:1.给一个区间[L,R] 加上一个数x 2.把一个区间[L,R] 里小于x 的数变成x 3.把一个区间[L,R] 里大于 ...
- 【BZOJ1391】Order(网络流,最小割)
[BZOJ1391]Order(网络流,最小割) 题面 BZOJ权限题... 良心洛谷 题目描述 有N个工作,M种机器,每种机器你可以租或者买过来. 每个工作包括若干道工序,每道工序需要某种机器来完成 ...
- spark(一)
一.spark 学习 1. spark学习的三种地方: (1)Spark.apache.org 官方文档 (2)spark的源代码的官方网站 https://github.com/apache/ ...
- Codeforces Round #412 (rated, Div. 2, base on VK Cup 2017 Round 3) A B C D 水 模拟 二分 贪心
A. Is it rated? time limit per test 2 seconds memory limit per test 256 megabytes input standard inp ...
- Codeforces 17.E Palisection
E. Palisection time limit per test 2 seconds memory limit per test 128 megabytes input standard inpu ...
- 对于redis框架的理解(三)
上一篇讲完了initServer的大体流程,其中aeCreateEventLoop(),这个函数 没有详细说明,我们在这一篇里讲述Ae.h和Ae.c, 这里面的api阐述了如何创建 eventLoop ...
- packet32 -- 打印packet32捕获的包
void PrintPackets(LPPACKET lpPacket) { ULONG i, j, ulLines, ulen, ulBytesReceived; char *pChar, *pLi ...
- [机器学习]-PCA数据降维:从代码到原理的深入解析
&*&:2017/6/16update,最近几天发现阅读这篇文章的朋友比较多,自己阅读发现,部分内容出现了问题,进行了更新. 一.什么是PCA:摘用一下百度百科的解释 PCA(Prin ...
- nodejs使用场景
NodeJS的工作原理其实就是事件循环.可以说每一条NodeJS的逻辑都是写在回调函数里面的,而回调函数都是有返回之后才异步执行的! 既然NodeJS处理并发的能力强,但处理计算和逻辑的能力反而很弱, ...