
教你用Python 编写 Hadoop MapReduce 程序
摘要:Hadoop Streaming 使用 MapReduce 框架,该框架可用于编写应用程序来处理海量数据。
本文分享自华为云社区《Hadoop Streaming:用 Python 编写 Hadoop MapReduce 程序》,作者:Donglian Lin。
随着数字媒体、物联网等发展的出现,每天产生的数字数据量呈指数级增长。这种情况给创建下一代工具和技术来存储和操作这些数据带来了挑战。这就是 Hadoop Streaming 的用武之地!下面给出的图表描绘了从2013年起全球每年产生的数据增长情况。IDC估计,到 2025年,每年产生的数据量将达到180 Zettabytes!
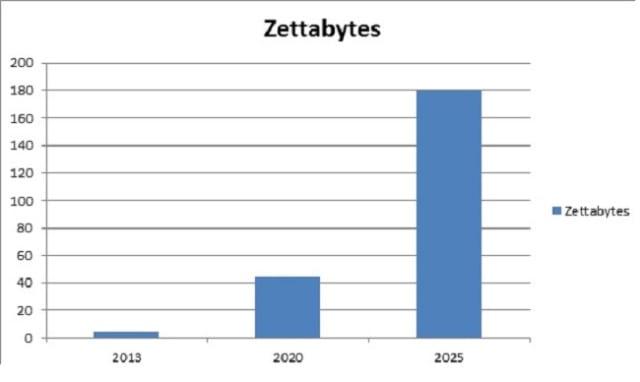
IBM 表示,每天有近 2.5 千万字节的数据被创建,其中 90% 的世界数据是在过去两年中创建的!存储如此庞大的数据量是一项具有挑战性的任务。Hadoop 可以比传统的企业数据仓库更有效地处理大量结构化和非结构化数据。它跨分布式计算机集群存储这些庞大的数据集。Hadoop Streaming 使用 MapReduce 框架,该框架可用于编写应用程序来处理海量数据。
由于 MapReduce 框架基于 Java,您可能想知道如果开发人员没有 Java 经验,他/她如何工作。好吧,开发人员可以使用他们喜欢的语言编写 mapper/Reducer 应用程序,而无需掌握太多 Java 知识,使用Hadoop Streaming而不是切换到 Pig 和 Hive 等新工具或技术。
什么是 Hadoop 流?
Hadoop Streaming 是 Hadoop 发行版附带的实用程序。它可用于执行大数据分析程序。Hadoop 流可以使用 Python、Java、PHP、Scala、Perl、UNIX 等语言执行。该实用程序允许我们使用任何可执行文件或脚本作为映射器和/或化简器来创建和运行 Map/Reduce 作业。例如:
$HADOOP_HOME/bin/hadoop jar $HADOOP_HOME/hadoop-streaming.jar

-input myInputDirs

-输出我的输出目录

-文件夹/垃圾箱/猫

-减速器/bin/wc
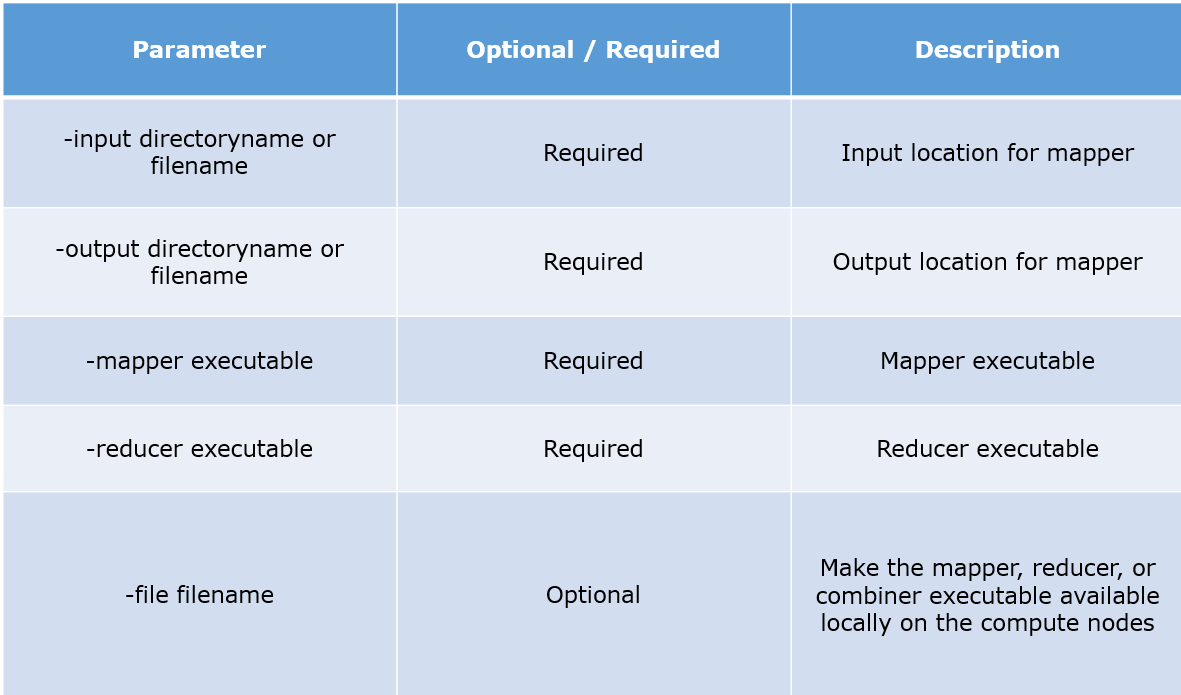
参数说明:
Python MapReduce 代码:
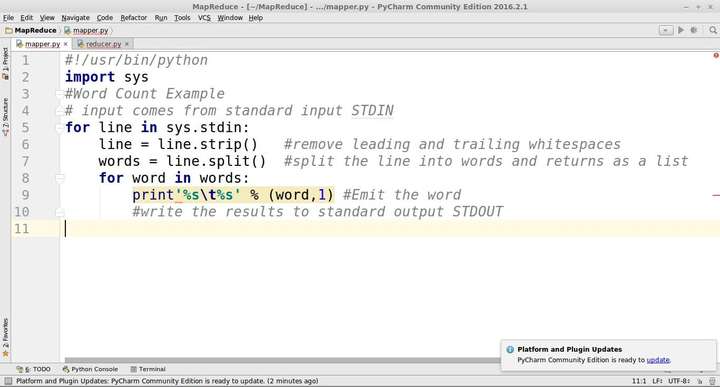
mapper.py

#!/usr/bin/python

import sys

#Word Count Example

# input comes from standard input STDIN

for line in sys.stdin:

line = line.strip() #remove leading and trailing whitespaces

words = line.split() #split the line into words and returns as a list

for word in words:

#write the results to standard output STDOUT

print'%s    %s' % (word,1) #Emit the word
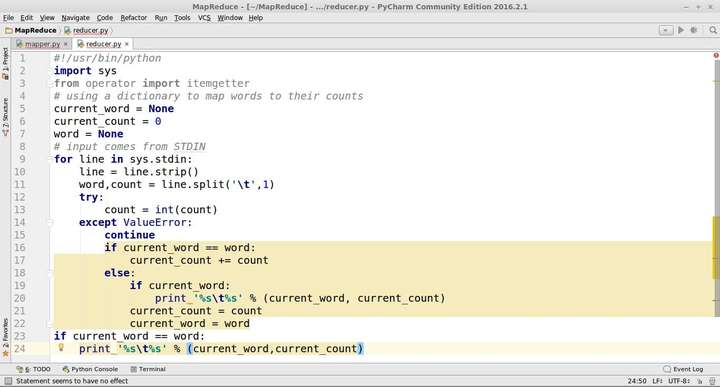
reducer.py
#!/usr/bin/python

import sys

from operator import itemgetter

# using a dictionary to map words to their counts

current_word = None

current_count = 0

word = None

# input comes from STDIN

for line in sys.stdin:

line = line.strip()

word,count = line.split('   ',1)

try:

count = int(count)

except ValueError:

continue

if current_word == word:

current_count += count

else:

if current_word:

print '%s   %s' % (current_word, current_count)

current_count = count

current_word = word

if current_word == word:

print '%s   %s' % (current_word,current_count)
跑:
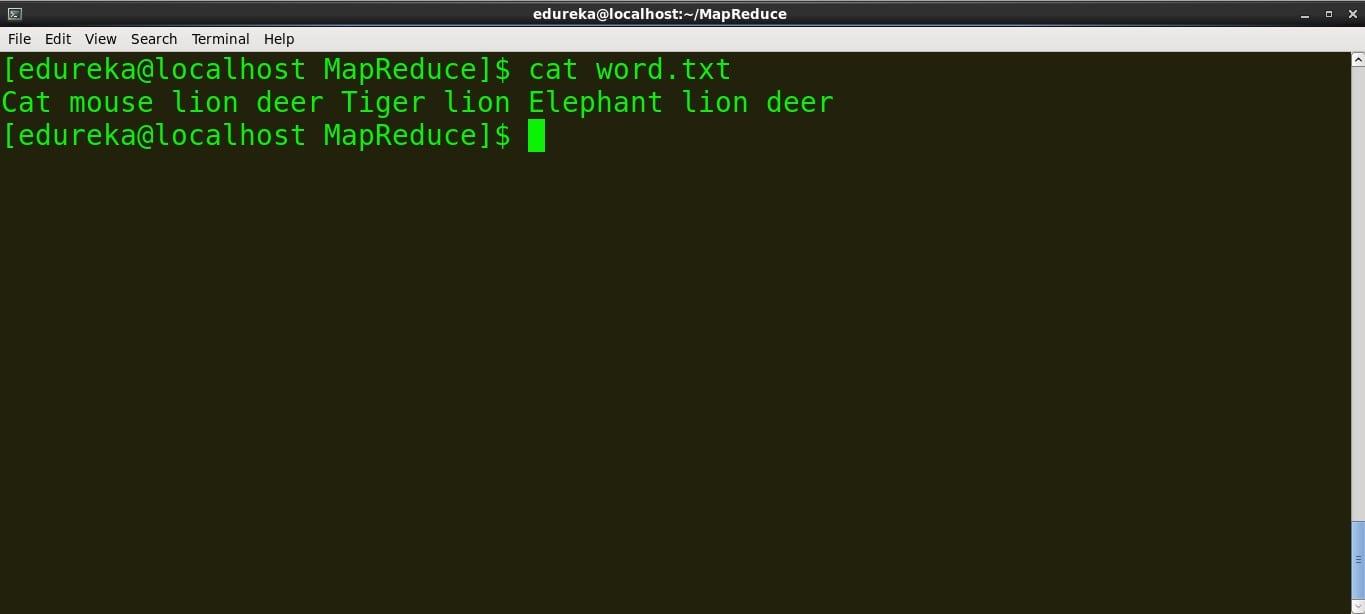
- 创建一个包含以下内容的文件并将其命名为 word.txt。
猫鼠狮鹿虎狮象狮鹿
- 将 mapper.py 和 reducer.py 脚本复制到上述文件所在的同一文件夹中。
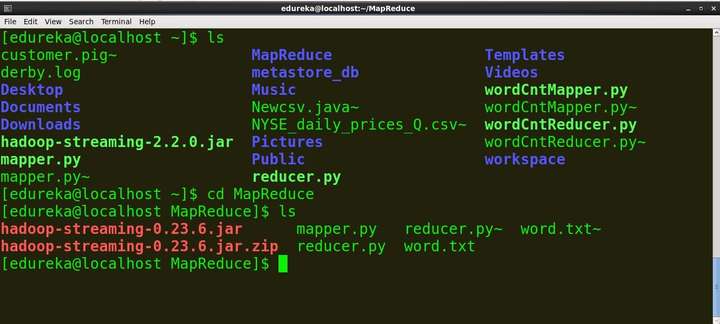
- 打开终端并找到文件所在的目录。 命令:ls:列出目录中的所有文件cd:更改目录/文件夹
- 查看文件的内容。
命令:cat file_name
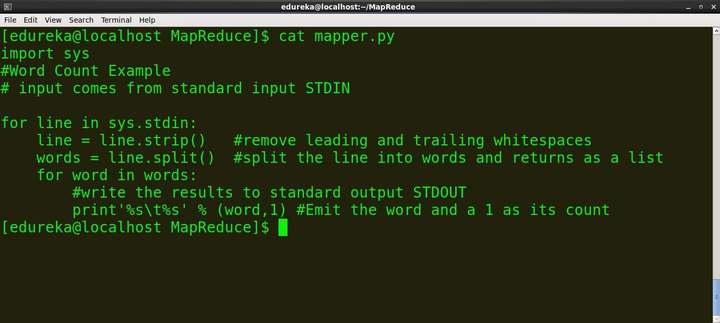
> mapper.py 的内容
命令:cat mapper.py
>reducer.py 的内容
命令:cat reducer.py
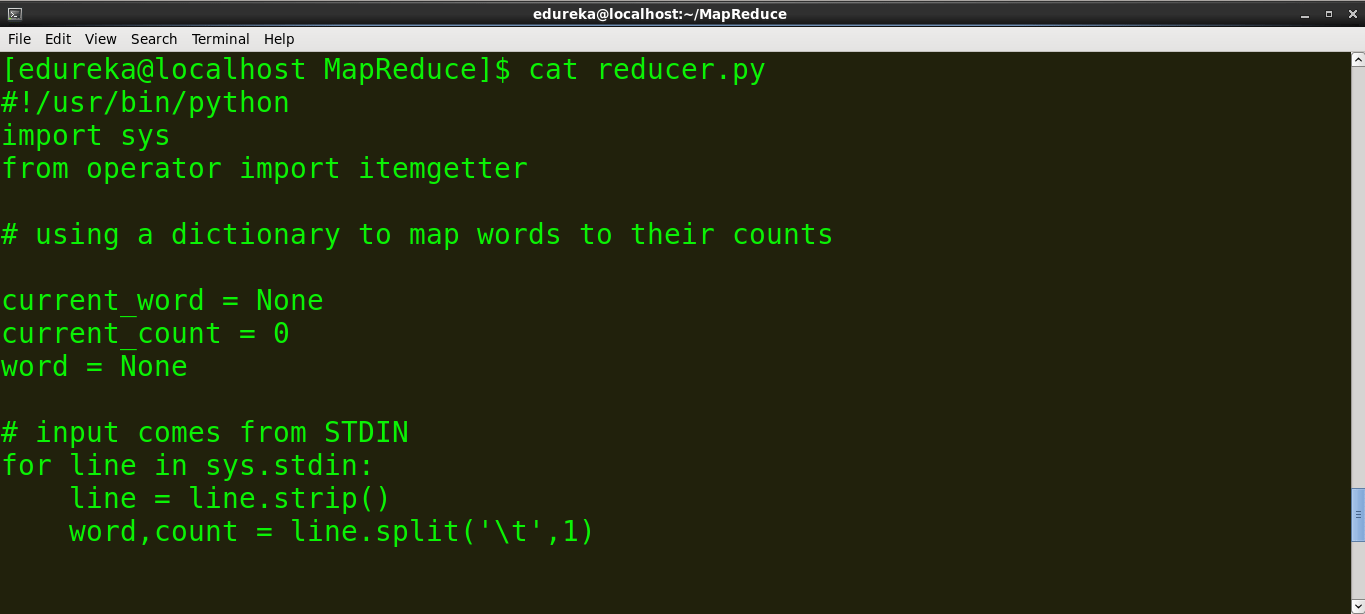
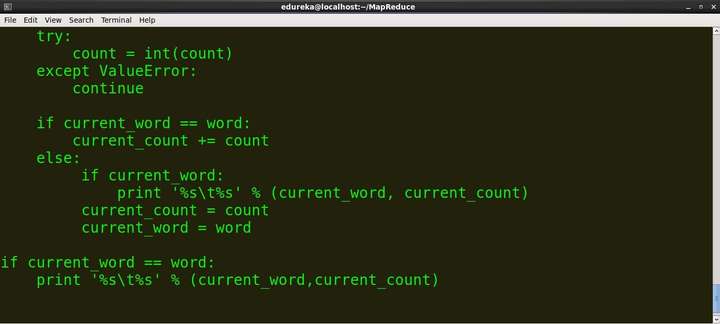
我们可以在本地文件(例如:word.txt)上运行 mapper 和 reducer。为了在 Hadoop 分布式文件系统 (HDFS) 上运行 Map 和 Reduce,我们需要Hadoop Streaming jar。所以在我们在 HDFS 上运行脚本之前,让我们在本地运行它们以确保它们工作正常。
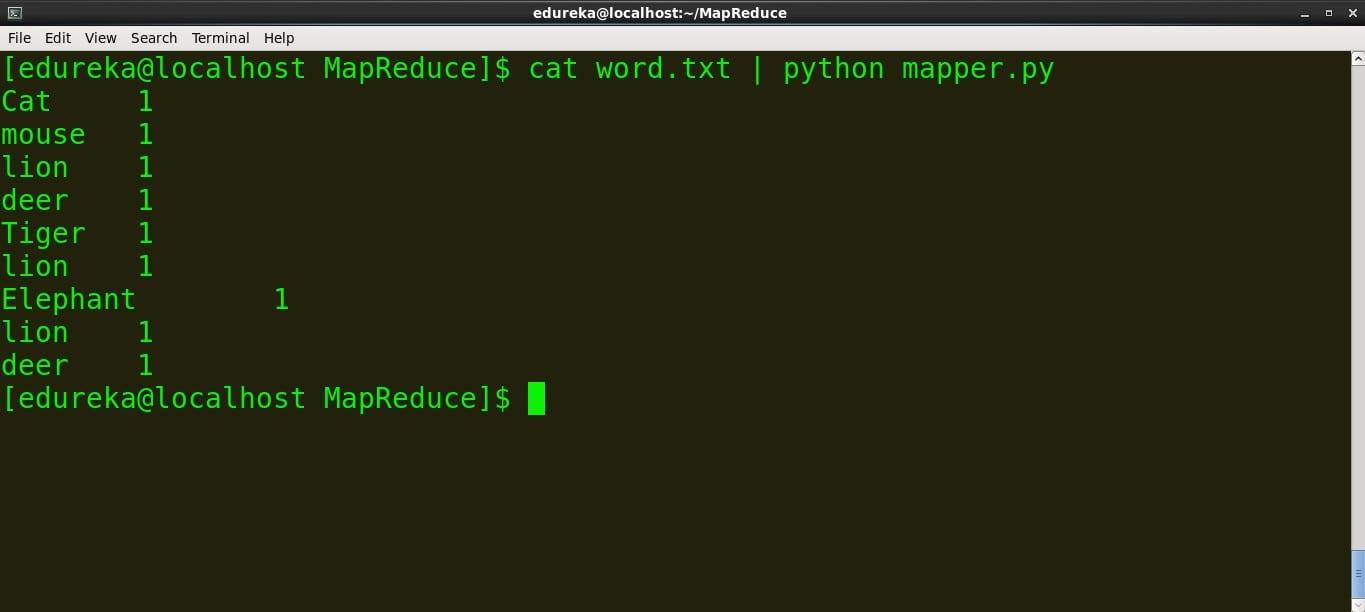
>运行映射器
命令:cat word.txt | python mapper.py
>运行reducer.py
命令: cat word.txt | python mapper.py | sort -k1,1 | python reducer.py
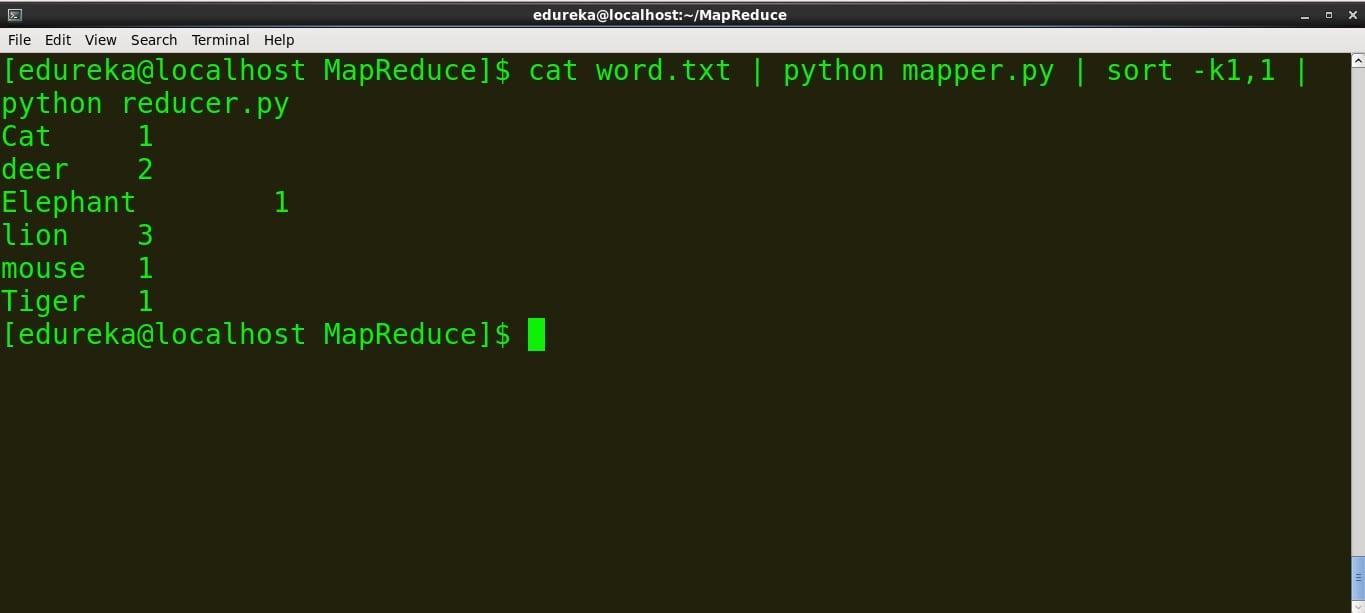
我们可以看到映射器和减速器按预期工作,因此我们不会面临任何进一步的问题。
在 Hadoop 上运行Python 代码
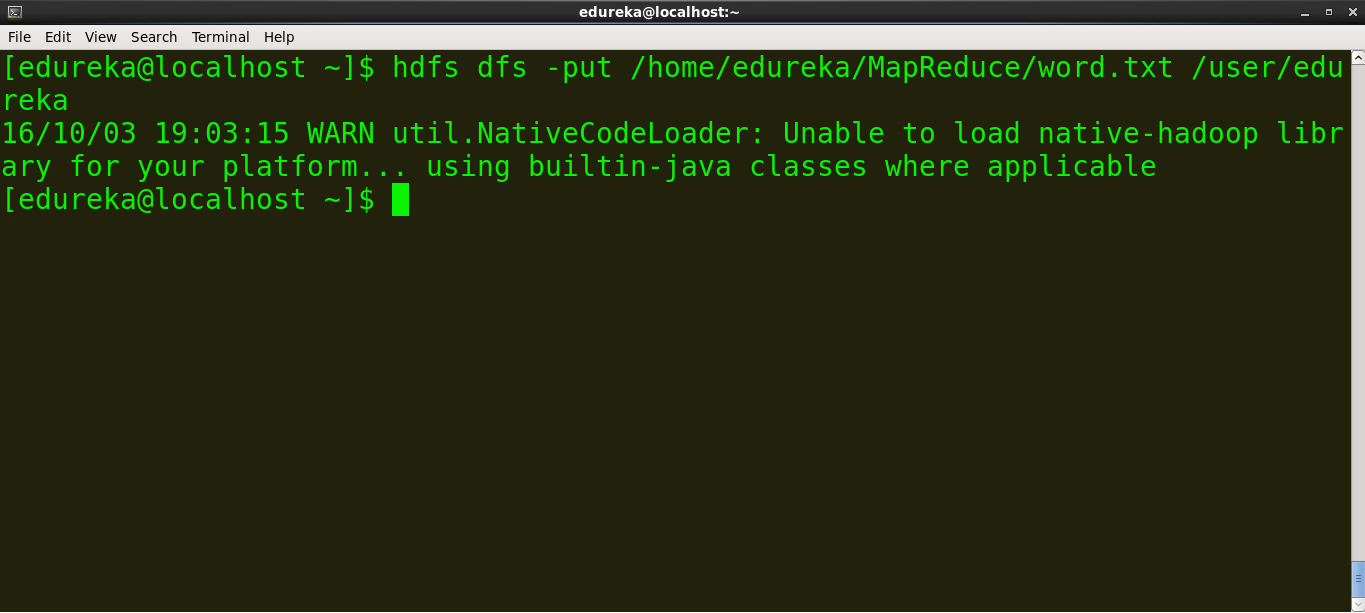
在我们在 Hadoop 上运行 MapReduce 任务之前,将本地数据(word.txt)复制到 HDFS
> 示例:hdfs dfs -put source_directory hadoop_destination_directory
命令:hdfs dfs -put /home/edureka/MapReduce/word.txt /user/edureka
复制jar文件的路径
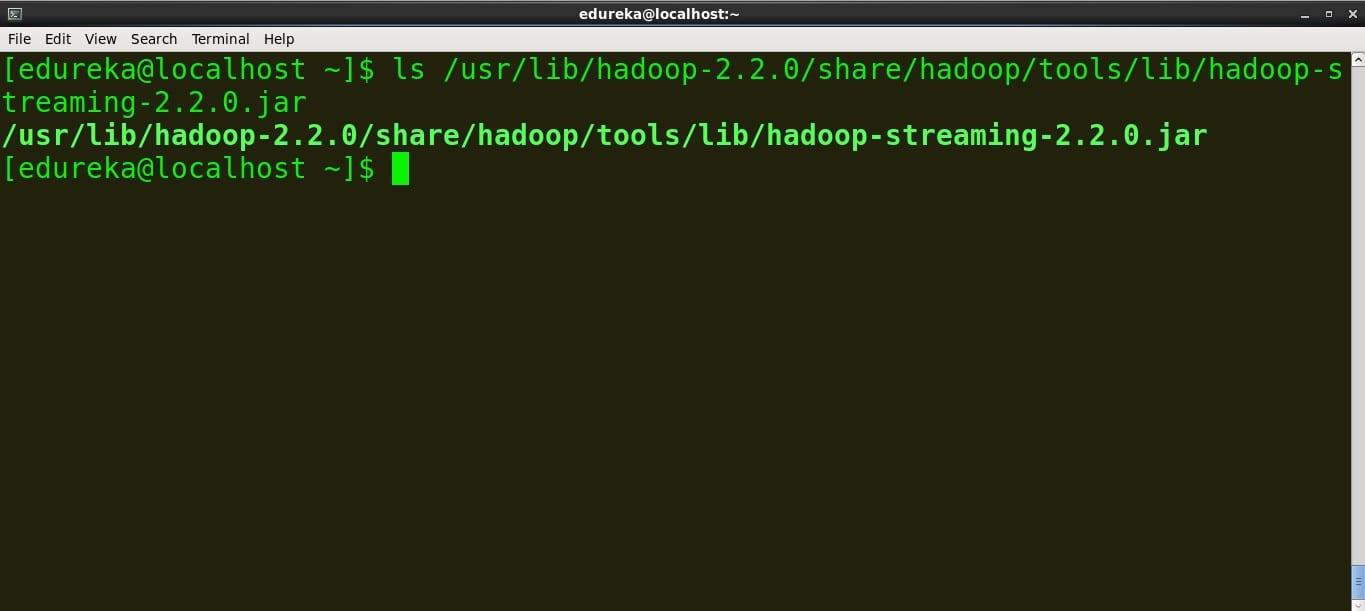
基于jar版本的Hadoop Streaming jar路径为:
/usr/lib/hadoop-2.2.X/share/hadoop/tools/lib/hadoop-streaming-2.2.X.jar
因此,在您的终端上找到 Hadoop Streaming jar 并复制路径。
命令:
ls /usr/lib/hadoop-2.2.0/share/hadoop/tools/lib/hadoop-streaming-2.2.0.jar
运行 MapReduce 作业
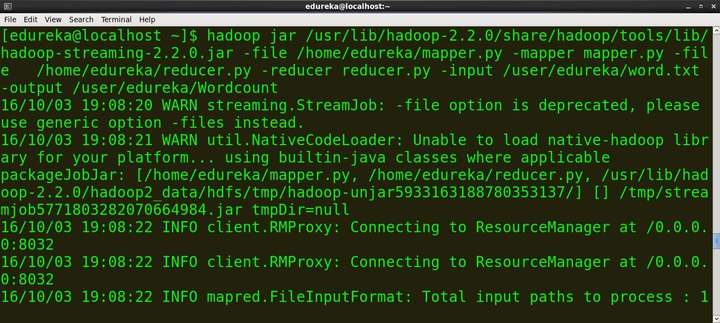
命令:
hadoop jar /usr/lib/hadoop-2.2.0/share/hadoop/tools/lib/hadoop-streaming-2.2.0.jar -file /home/edureka/mapper.py -mapper mapper.py -file /home/ edureka/reducer.py -reducer reducer.py -input /user/edureka/word -output /user/edureka/Wordcount
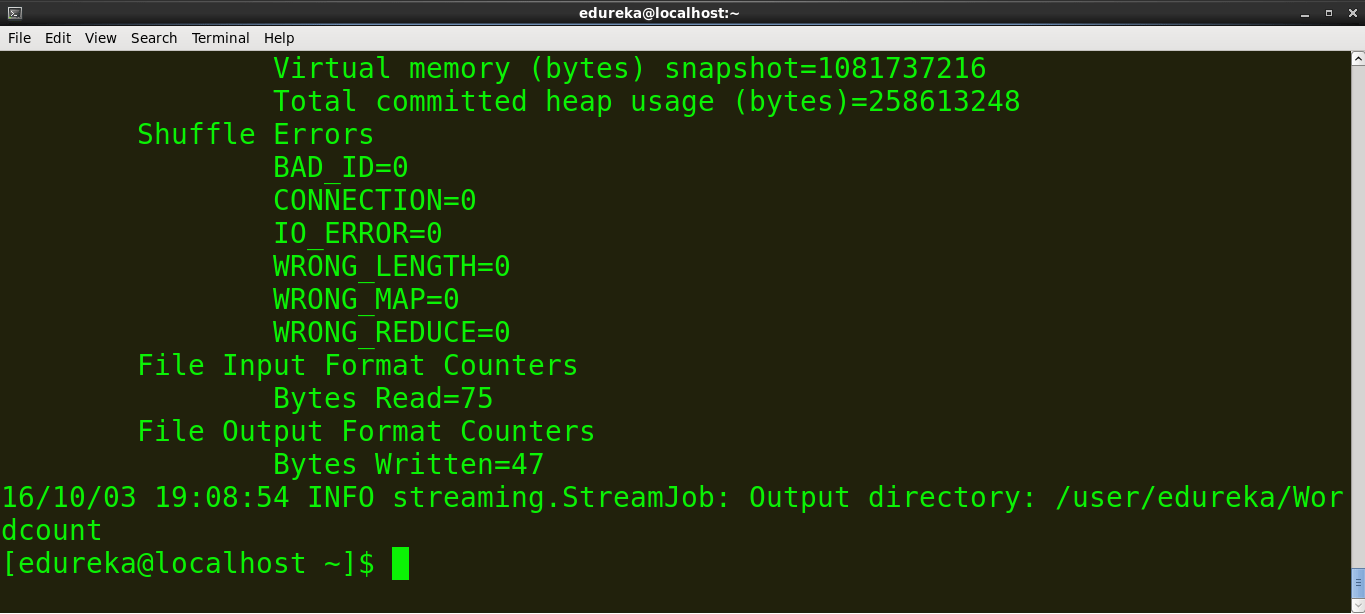
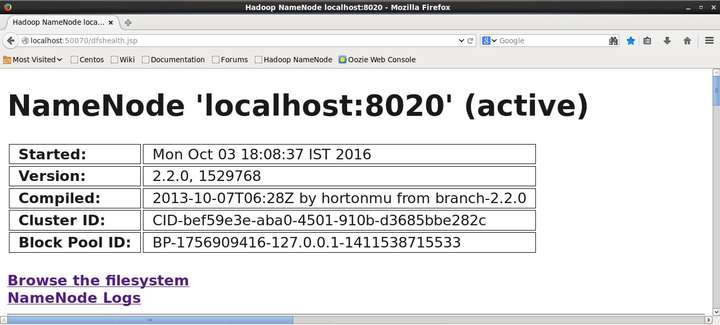
Hadoop 为统计和信息提供了一个基本的 Web 界面。当 Hadoop 集群运行时,在浏览器中打开 http://localhost:50070。这是 Hadoop Web 界面的屏幕截图。
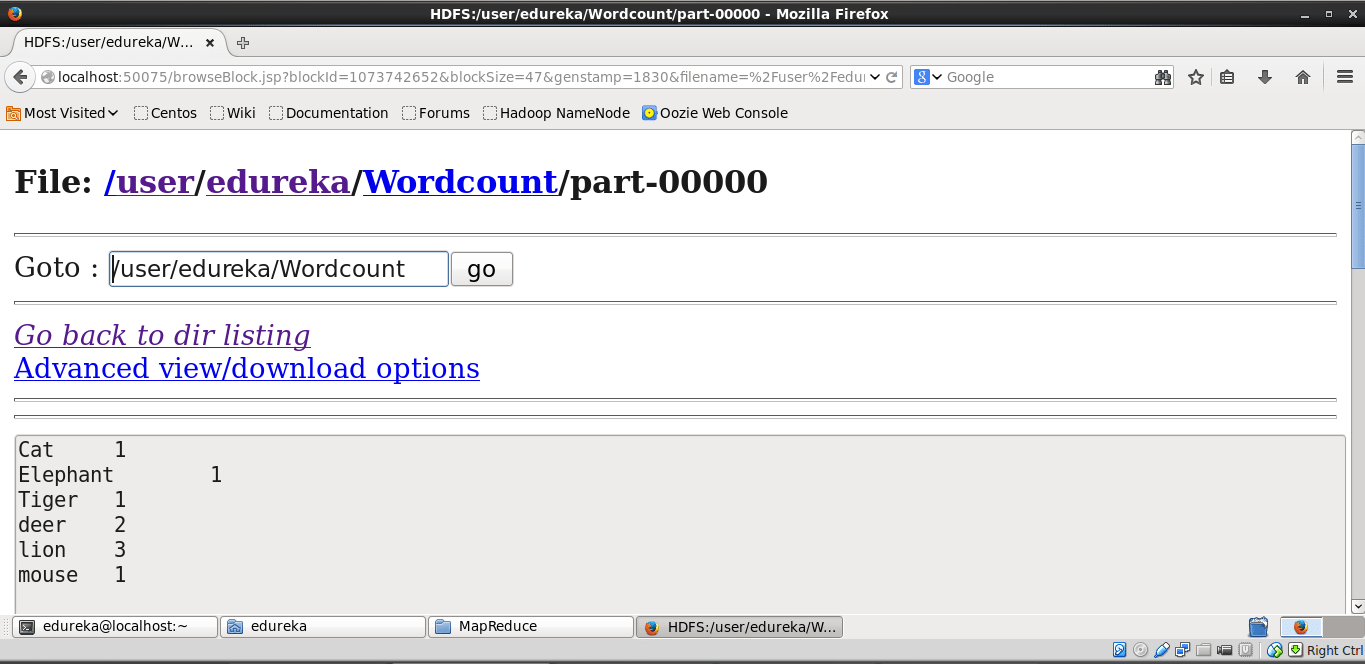
现在浏览文件系统并找到生成的 wordcount 文件以查看输出。下面是截图。
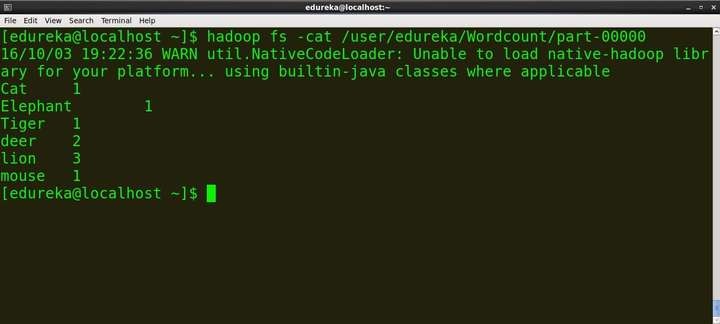
我们可以使用这个命令在终端上看到输出
命令:hadoop fs -cat /user/edureka/Wordcount/part-00000
您现在已经学会了如何使用 Hadoop Streaming 执行用 Python 编写的 MapReduce 程序!
教你用Python 编写 Hadoop MapReduce 程序的更多相关文章
- 使用Python实现Hadoop MapReduce程序
转自:使用Python实现Hadoop MapReduce程序 英文原文:Writing an Hadoop MapReduce Program in Python 根据上面两篇文章,下面是我在自己的 ...
- [python]使用python实现Hadoop MapReduce程序:计算一组数据的均值和方差
这是参照<机器学习实战>中第15章“大数据与MapReduce”的内容,因为作者写作时hadoop版本和现在的版本相差很大,所以在Hadoop上运行python写的MapReduce程序时 ...
- Python实现Hadoop MapReduce程序
1.概述 Hadoop Streaming提供了一个便于进行MapReduce编程的工具包,使用它可以基于一些可执行命令.脚本语言或其他编程语言来实现Mapper和 Reducer,从而充分利用Had ...
- 简单的java Hadoop MapReduce程序(计算平均成绩)从打包到提交及运行
[TOC] 简单的java Hadoop MapReduce程序(计算平均成绩)从打包到提交及运行 程序源码 import java.io.IOException; import java.util. ...
- Python编写守护进程程序
Python编写守护进程程序思路 1. fork子进程,父进程退出通常,我们执行服务端程序的时候都会通过终端连接到服务器,成功连接后会加载shell环境,终端和shell都是进程,shell进程是终端 ...
- Python编写简易木马程序(转载乌云)
Python编写简易木马程序 light · 2015/01/26 10:07 0x00 准备 文章内容仅供学习研究.切勿用于非法用途! 这次我们使用Python编写一个具有键盘记录.截屏以及通信功能 ...
- 用Python语言写Hadoop MapReduce程序Writing an Hadoop MapReduce Program in Python
In this tutorial I will describe how to write a simple MapReduce program for Hadoop in the Python pr ...
- Hadoop(三)通过C#/python实现Hadoop MapReduce
MapReduce Hadoop中将数据切分成块存在HDFS不同的DataNode中,如果想汇总,按照常规想法就是,移动数据到统计程序:先把数据读取到一个程序中,再进行汇总. 但是HDFS存的数据量非 ...
- 【转载】Python编写简易木马程序
转载来自: http://drops.wooyun.org/papers/4751?utm_source=tuicool 使用Python编写一个具有键盘记录.截屏以及通信功能的简易木马. 首先准备好 ...
- HDFS基本命令与Hadoop MapReduce程序的执行
一.HDFS基本命令 1.创建目录:-mkdir [jun@master ~]$ hadoop fs -mkdir /test [jun@master ~]$ hadoop fs -mkdir /te ...
随机推荐
- Chromium 消息循环和线程池详解
Chromium 中的多线程机制由 base 库提供,要理解 Chromium 中的多线程机制,首先要理解的概念就是 base::MessageLoop 和 base::TaskScheduler , ...
- JS逆向实战25——某壳找房模拟登录+百度喵星人指纹加密破解.
声明 本文章中所有内容仅供学习交流,抓包内容.敏感网址.数据接口均已做脱敏处理,严禁用于商业用途和非法用途,否则由此产生的一切后果均与作者无关,若有侵权,请联系我立即删除! 目标 目标网站 aHR0c ...
- SSH简述
远程访问及控制 1.SSH 1.1 简单介绍 SSH协议(secure shell) 是一种安全通道协议 对数据进行加密处理,用于远程管理 OpenSSH(安装包名,centos7自带) 服务名称:s ...
- InfiniBand 的前世今生
今年,以 ChatGPT 为代表的 AI 大模型强势崛起,而 ChatGPT 所使用的网络,正是 InfiniBand,这也让 InfiniBand 大火了起来.那么,到底什么是 InfiniBand ...
- 【re】[NISACTF 2022]string --linux下的随机数
附件下载,查壳 发现是ELF程序,64位,ida打开分析 flag函数点进去 前面一堆代码其实都不重要,直接看主要代码: puts("The length of flag is 13&qu ...
- 字符串转换整数(atoi)(4.3leetcode每日打卡)
一堆if不及python的一个正则表达式系列 请你来实现一个 atoi 函数,使其能将字符串转换成整数. 首先,该函数会根据需要丢弃无用的开头空格字符,直到寻找到第一个非空格的字符为止.接下来的转化规 ...
- 手撕Vue-Router-初始化路由信息
前言 经过上一节课的学习,我们已经完成了提取我们想要的路由信息数据格式,提取完毕了之后,接下来我们该干什么,接下来需要做的步骤就是监听路由的变化,保存当前的路由. 那么就会遇到几个问题,就是怎么监听, ...
- 不要轻易定义指向std::vector中的元素的指针
类应该是被封装的,类的用户通过接口使用类提供的功能,而不必关心类的内部如何实现.然而,C++标准库容器 std::vector 的实现渗透到了接口中来.对于以下代码: const int pushNu ...
- python内置模块——logging
内置模块-logging loging模块是python提供的内置模块,用来做日志处理. 日志等级: 等级 释义 级别数值 CRITICAL(fatal) 致命错误,程序根本跑不起来 50 ERROR ...
- Batrix企业能力库之物流交易域能力建设实践
简介 Batrix企业能力库,是京东物流战略级项目-技术中台架构升级项目的基础底座.致力于建立企业级业务复用能力平台,依托能力复用业务框架Batrix,通过通用能力/扩展能力的定义及复用,灵活支持业务 ...