
【Kafka】自定义分区策略
自定义分区策略
思路
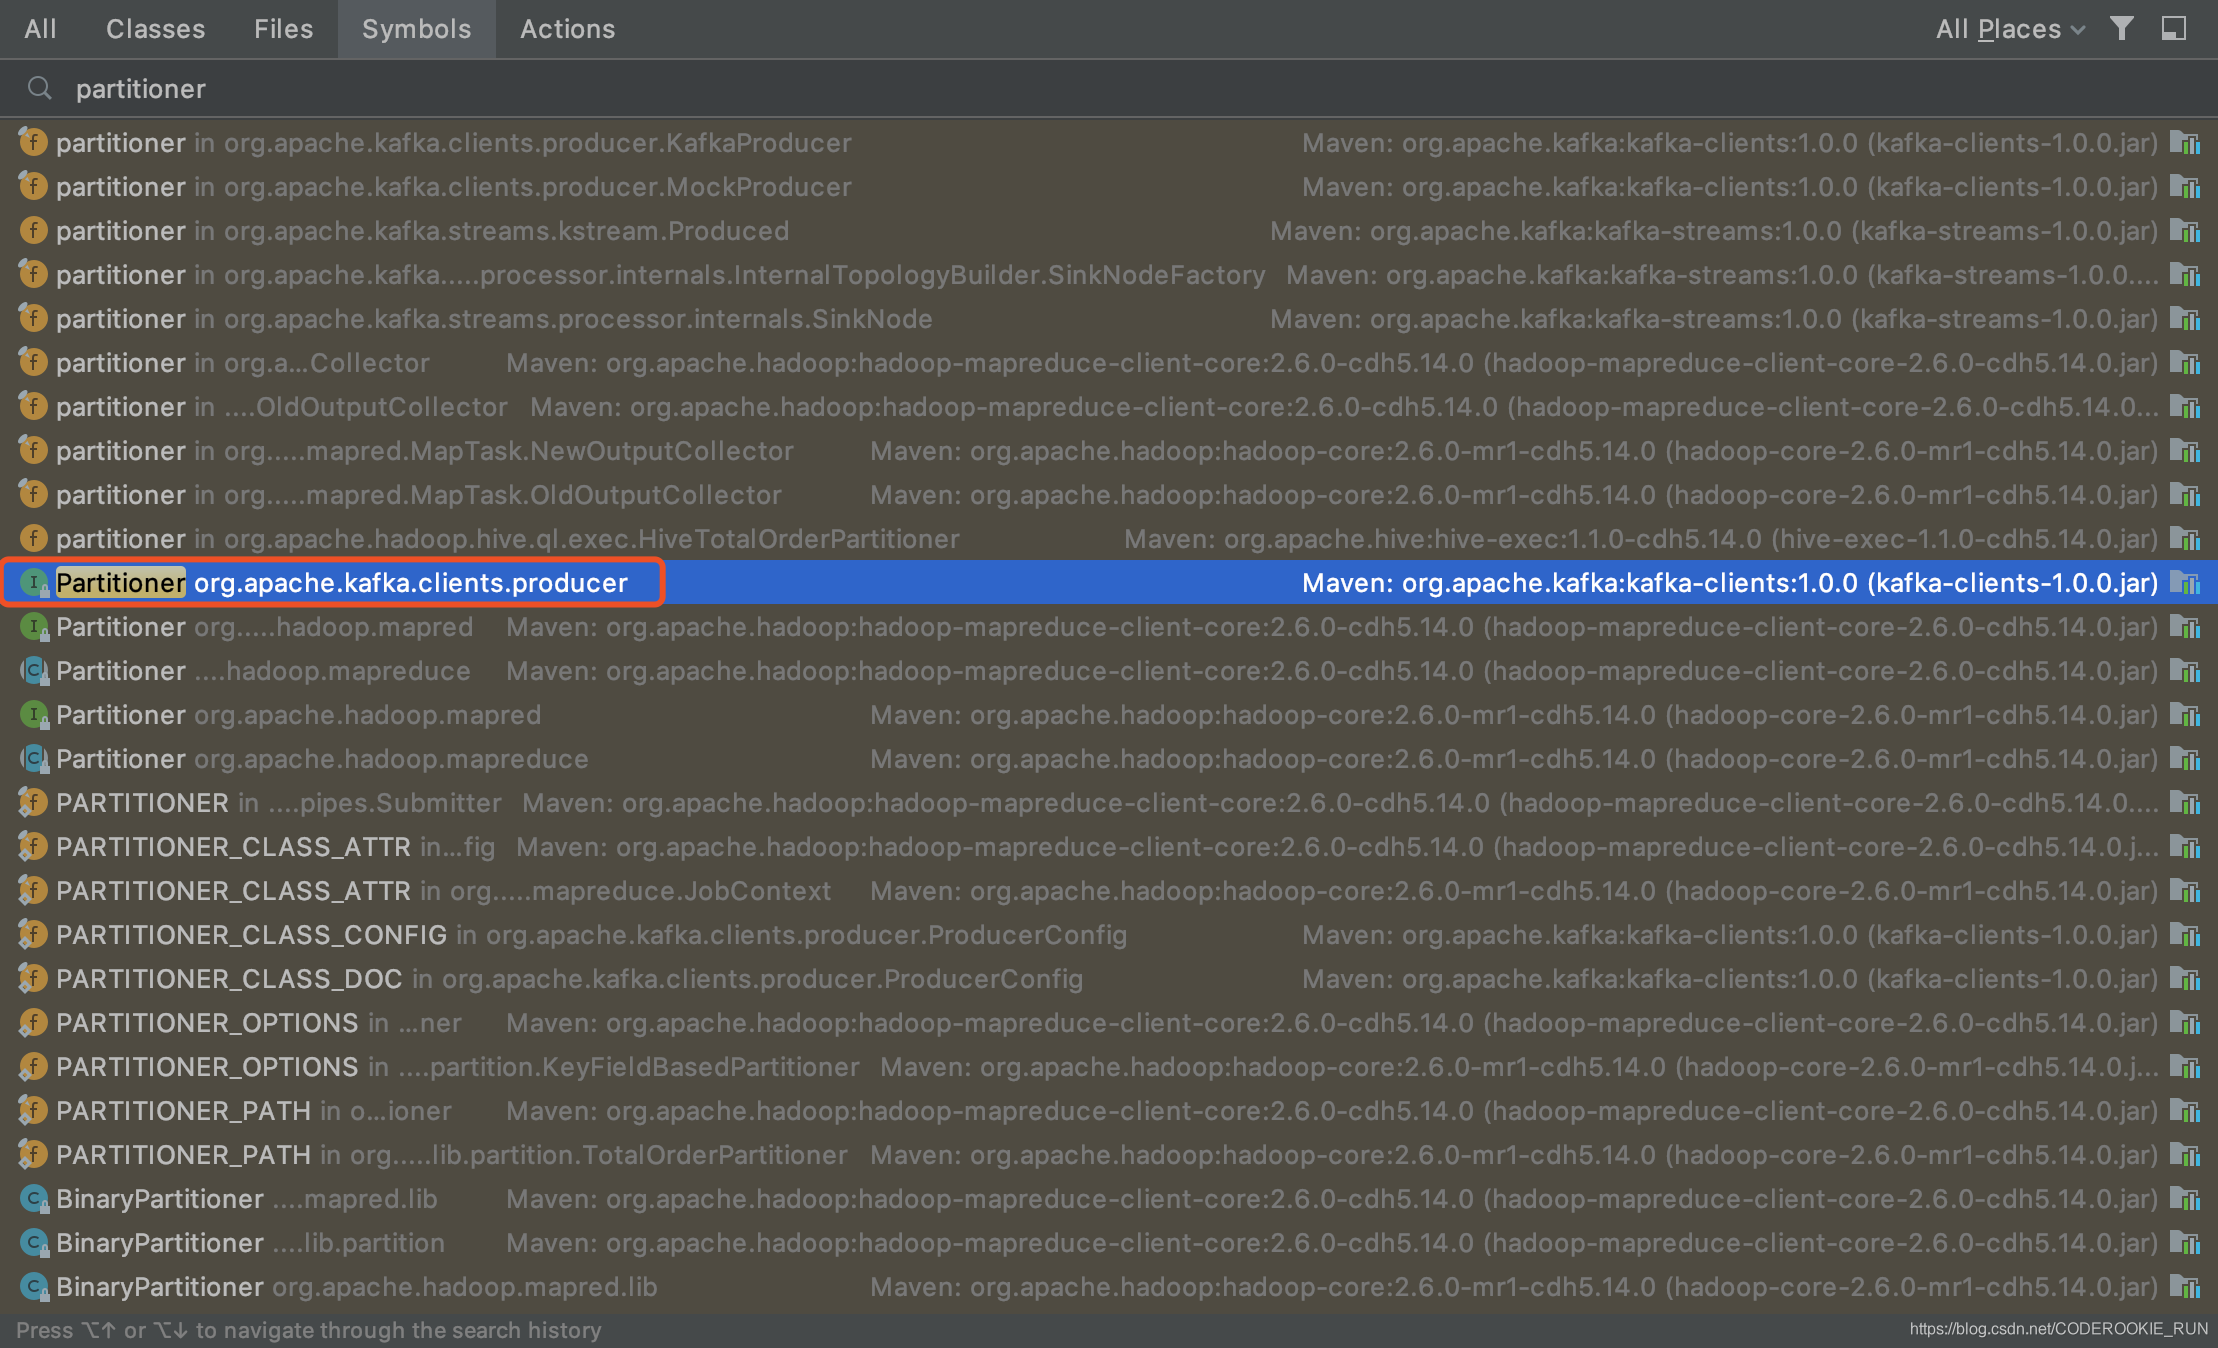
Command+Option+shift+N 调出查询页面,找到producer包的Partitioner接口
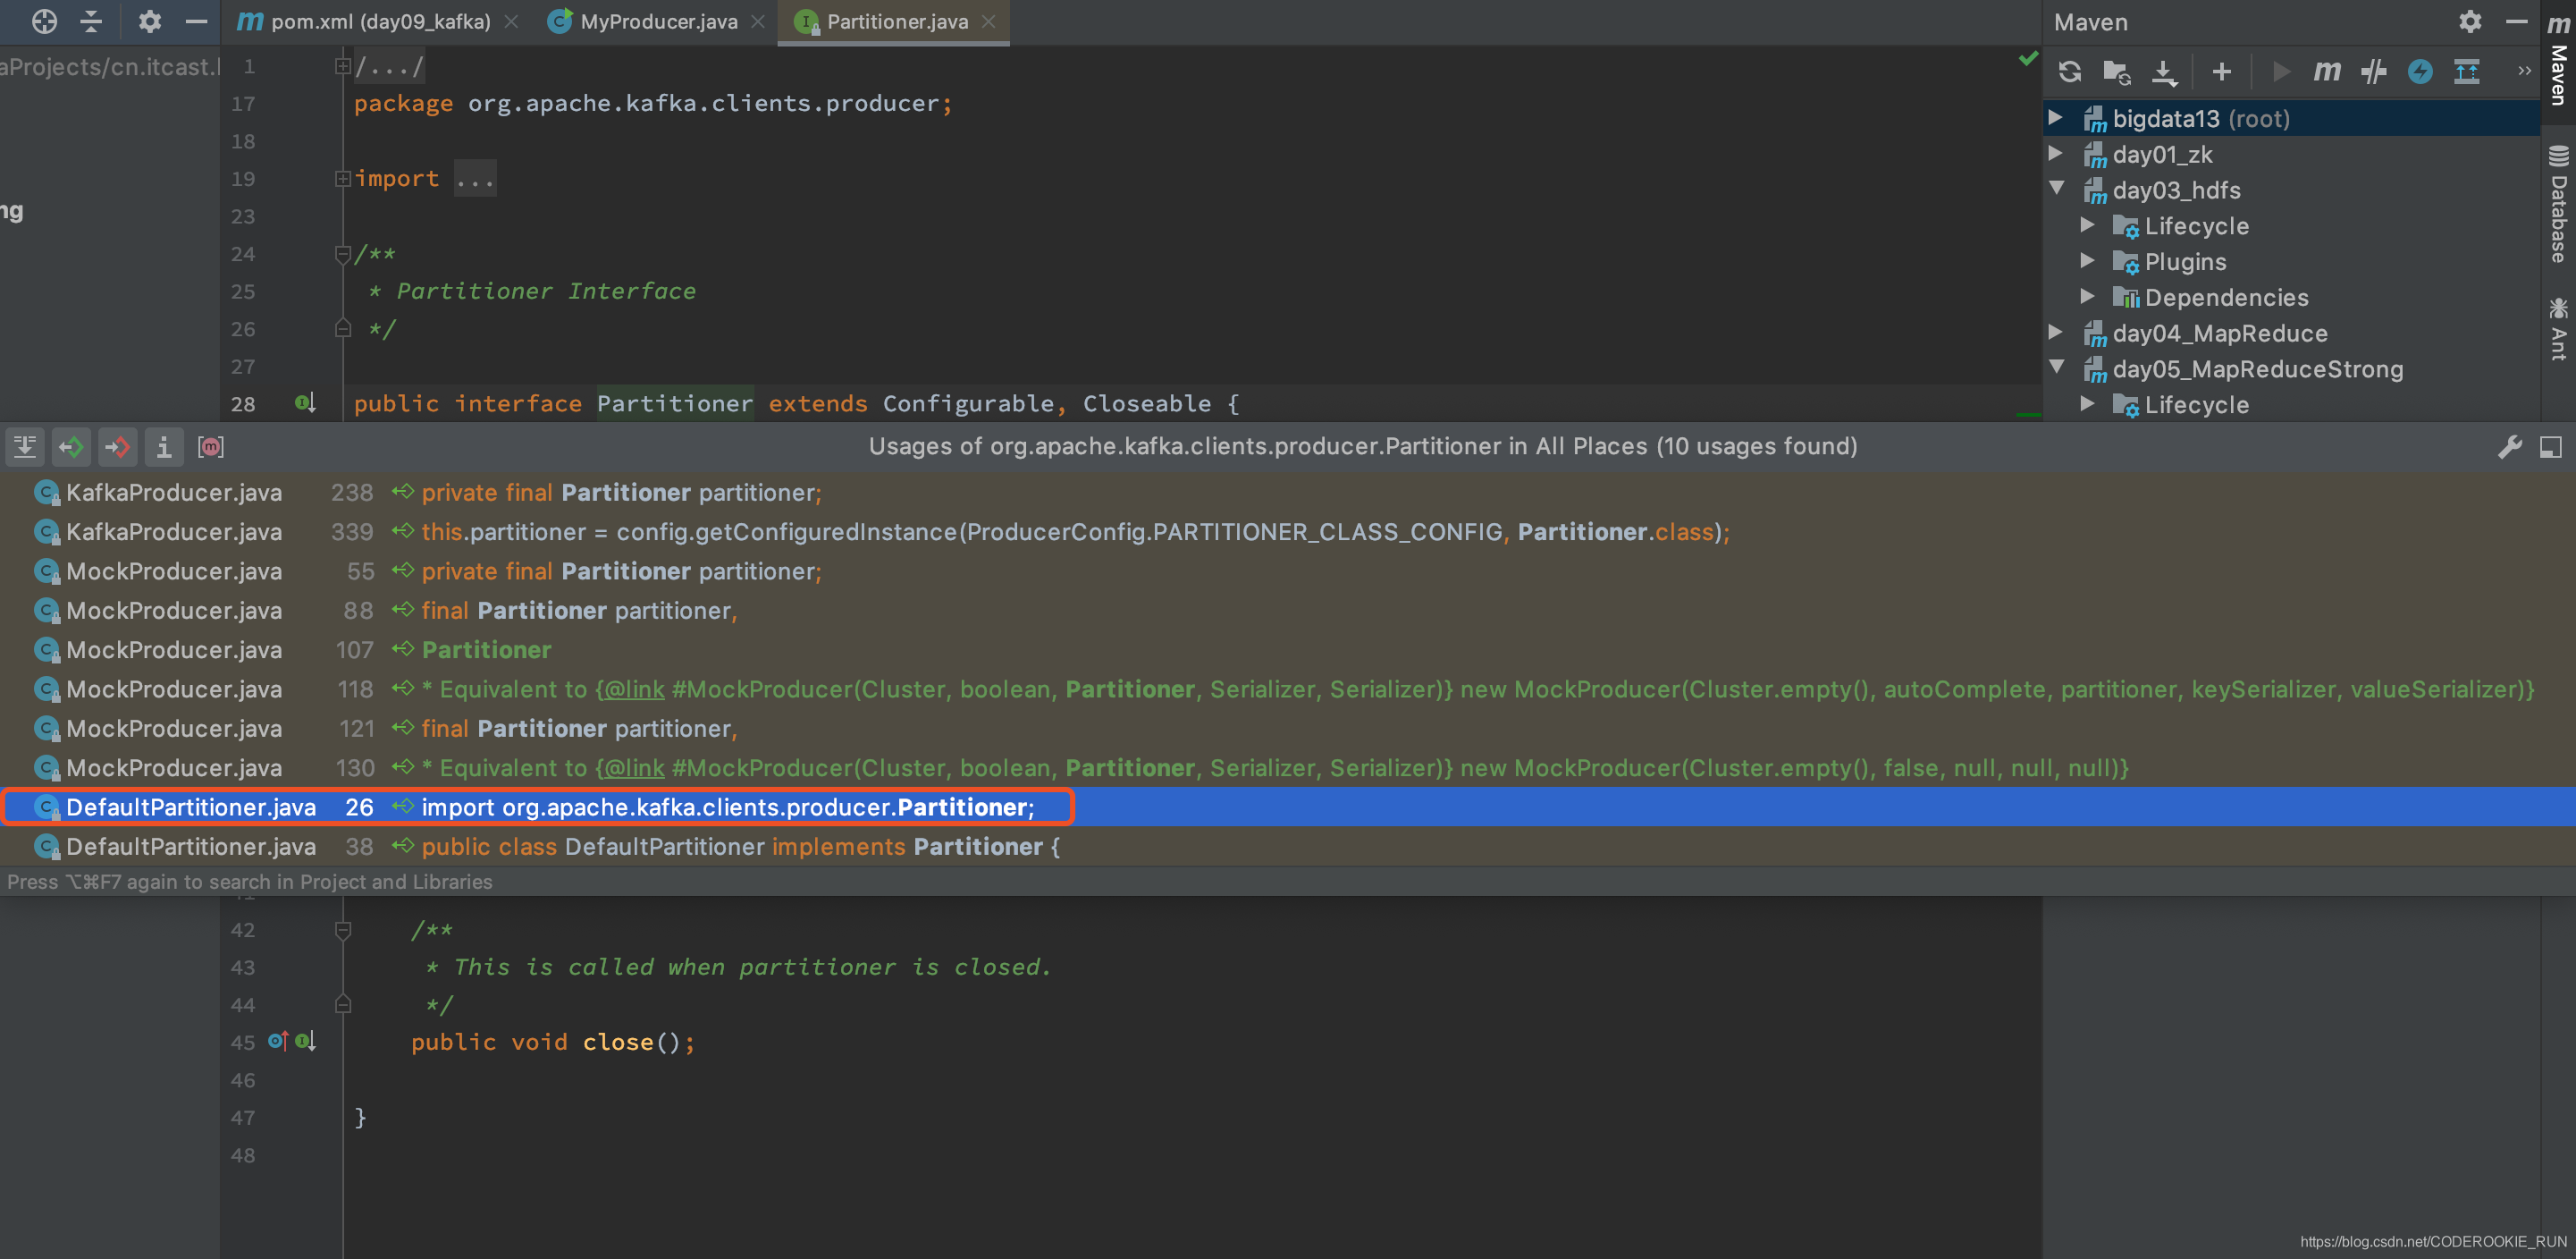
Partitioner下有一个DefaultPartitioner实现类
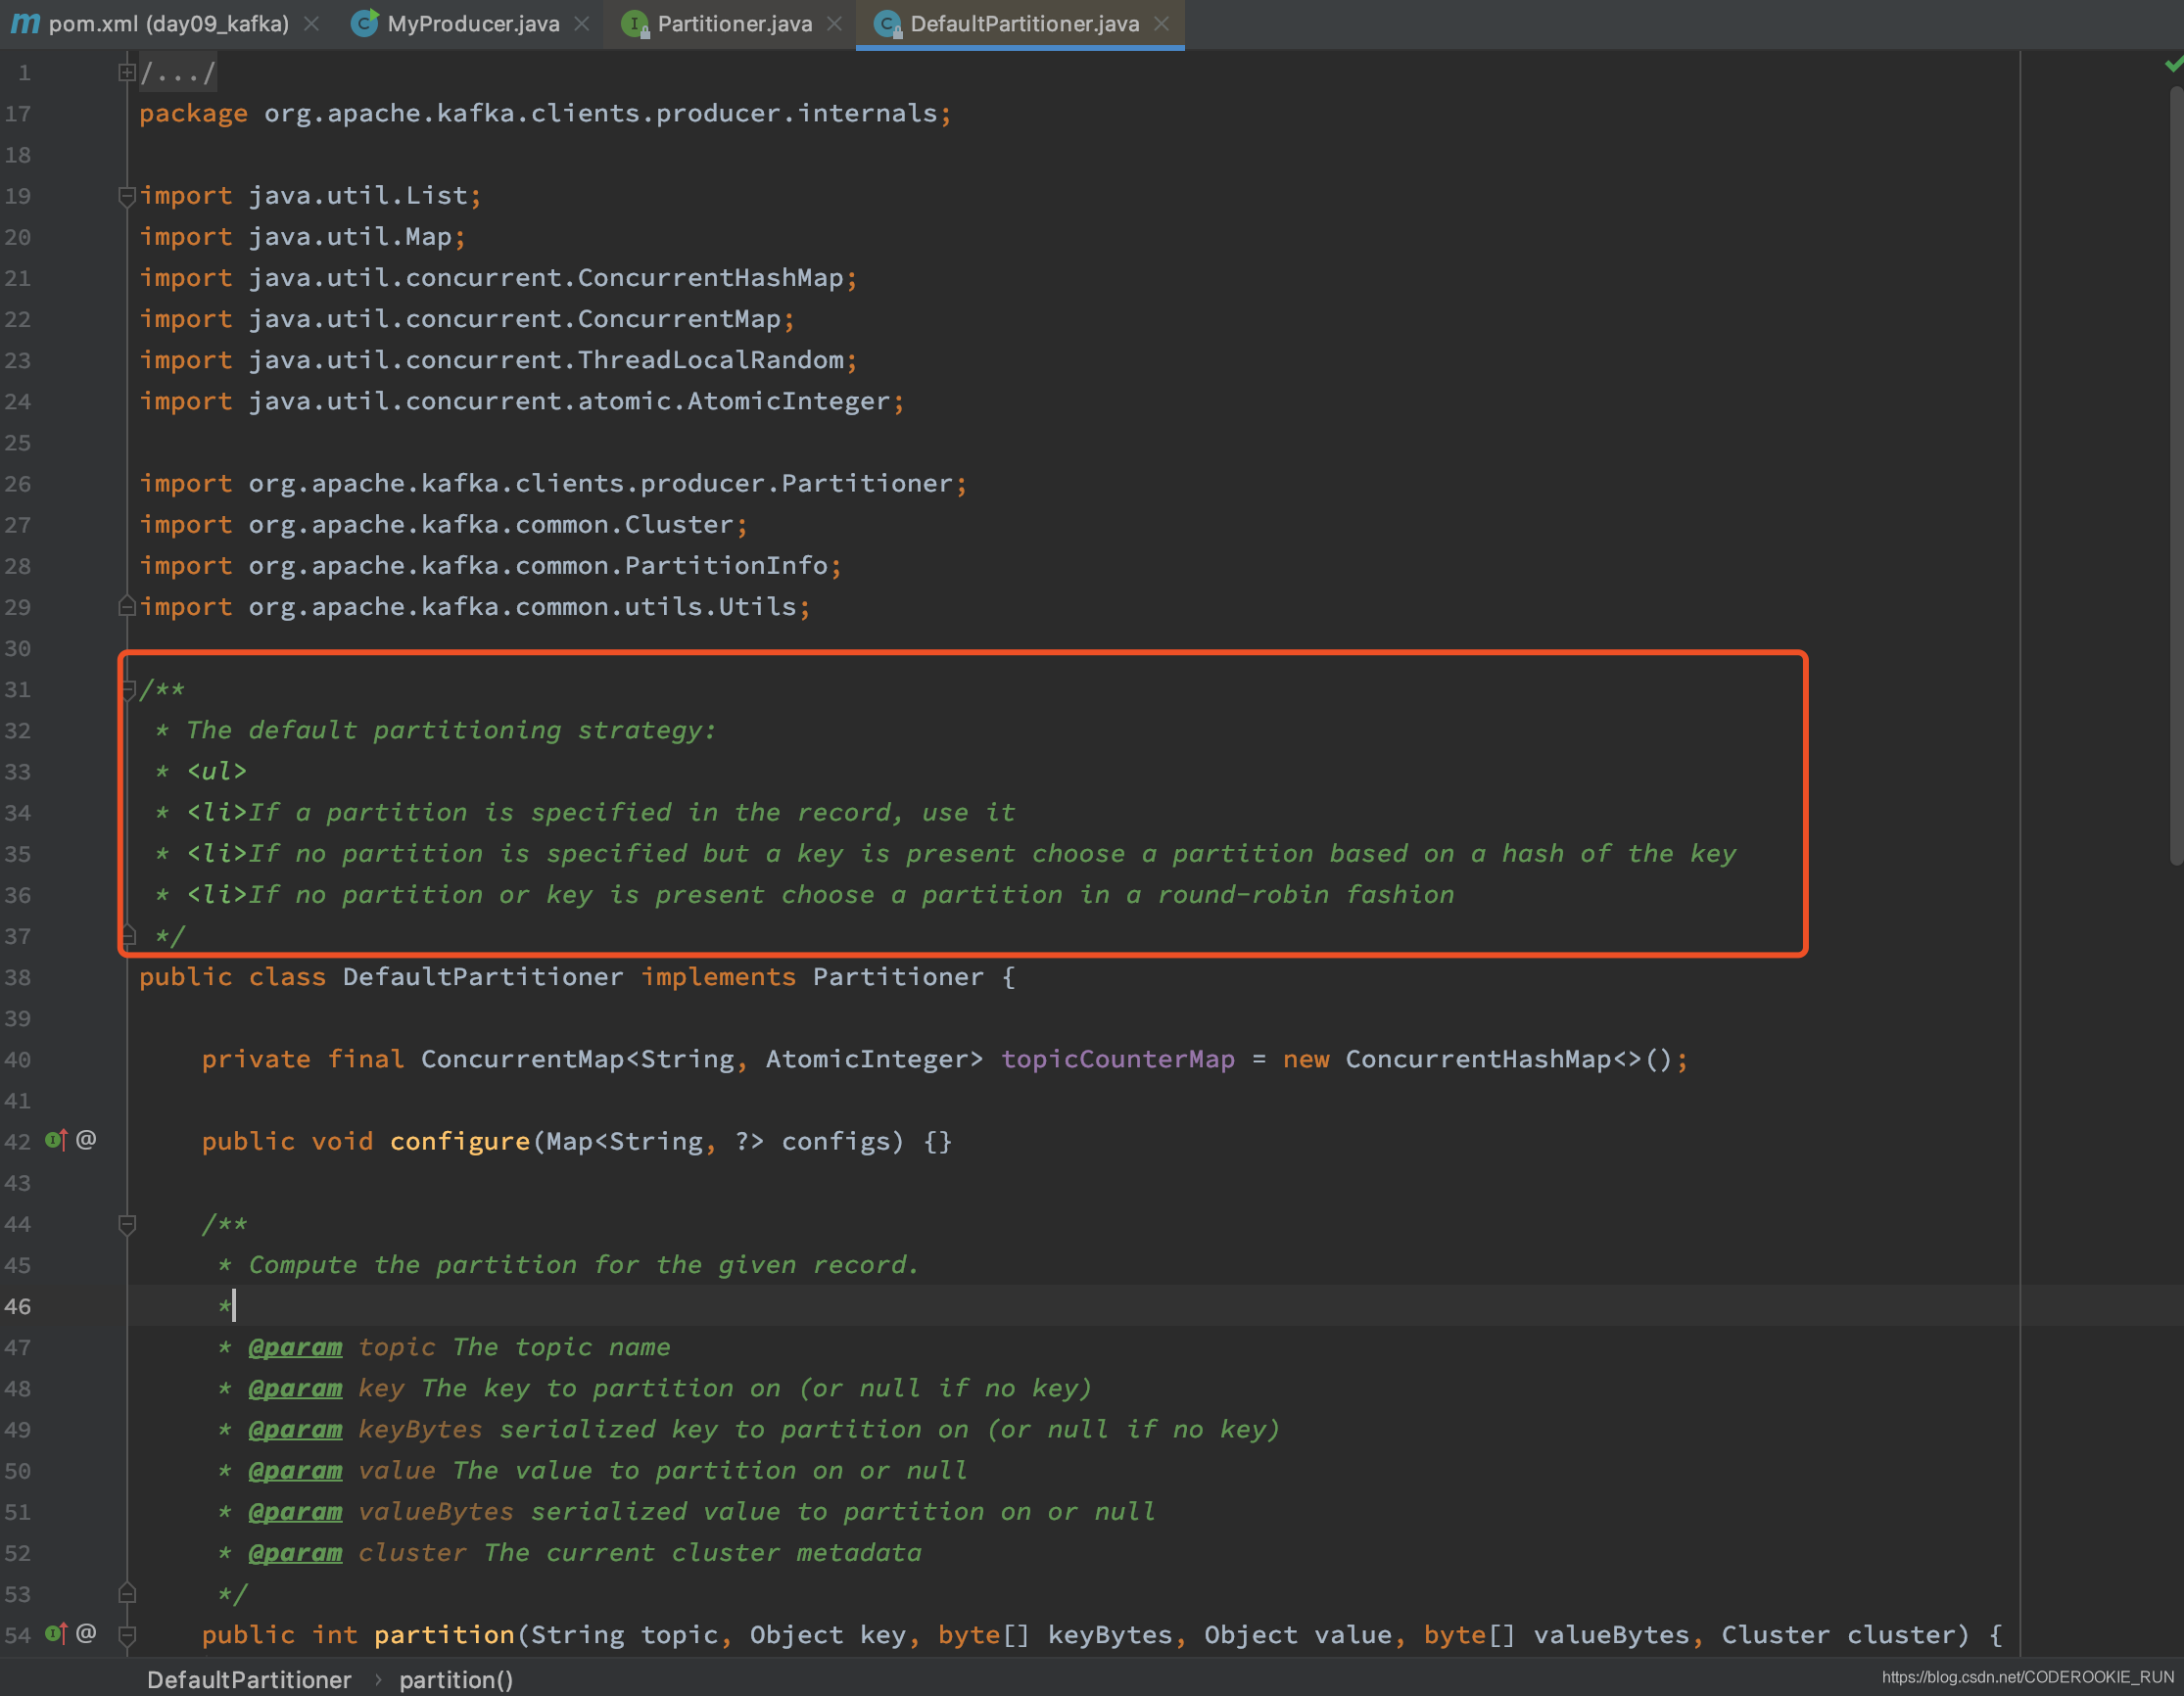
这里就有之前提到kafka数据分区策略
自定义分区策略
创建一个MyPartitioner类,继承并重新定义上面的Partitioner类
package cn.itcast.kafka.demo1;

import org.apache.kafka.clients.producer.Partitioner;

import org.apache.kafka.common.Cluster;

import java.util.Map;

public class MyPartitioner implements Partitioner {

    /**

     * 此方法是确定分区规则

     * @param topic

     * @param key

     * @param keyBytes

     * @param value

     * @param valueBytes

     * @param cluster

     * @return 返回的int值为分区

     */

    @Override

    public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {

    	//return 3 则指定发送数据到3分区

        return 3;

    }

    @Override

    public void close() {

    }

    @Override

    public void configure(Map<String, ?> configs) {

    }

}
还需要在MyProducer中添加一行代码
props.put("partitioner.class","cn.itcast.kafka.demo1.MyPartitioner");
而且在MyProducer类中不需要指定分区号
producer.send(new ProducerRecord<String, String>("test" , "mykey" + i,"这是第" + i + "条message"));
【Kafka】自定义分区策略的更多相关文章
- kafka 自定义分区器
package cn.xiaojf.kafka.producer; import org.apache.kafka.clients.producer.Partitioner; import org.a ...
- Kafka 生产者分区策略
分区策略 1)分区的原因 (1)方便在集群中扩展,每个 Partition 可以通过调整以适应它所在的机器,而一个 topic 又可以有多个 Partition 组成,因此整个集群就可以适应任意大小的 ...
- 【Kafka】数据分区策略
数据分区策略 四种策略 一.指定分区号,数据会直接发送到所指定的分区 二.没有指定分区号,指定了数据的key,可以通过key获取hashCode决定数据发送到哪个分区 三.都没有指定的话,会采取rou ...
- Kafka分区策略
Kafka分区策略 所谓分区策略是决定生产者将消息发送到哪个分区的算法.Kafka 为我们提供了默认的分区策略,同时它也支持你自定义分区策略. 常见的分区策略包含以下几种:轮询策略.随机策略 .按消息 ...
- Spark自定义分区(Partitioner)
我们都知道Spark内部提供了HashPartitioner和RangePartitioner两种分区策略,这两种分区策略在很多情况下都适合我们的场景.但是有些情况下,Spark内部不能符合咱们的需求 ...
- kafka的分区分配策略
用过 Kafka 的同学应该都知道,每个 Topic 一般会有很多个 partitions.为了使得我们能够及时消费消息,我们也可能会启动多个 Consumer 去消费,而每个 Consumer 又会 ...
- kafka数据分区的四种策略
kafka的数据的分区 探究的是kafka的数据生产出来之后究竟落到了哪一个分区里面去了 第一种分区策略:给定了分区号,直接将数据发送到指定的分区里面去 第二种分区策略:没有给定分区号,给定数据的ke ...
- Kafka的接口回调 +自定义分区、拦截器
一.接口回调+自定义分区 1.接口回调:在使用消费者的send方法时添加Callback回调 producer.send(new ProducerRecord<String, String> ...
- kafka Poll轮询机制与消费者组的重平衡分区策略剖析
注意本文采用最新版本进行Kafka的内核原理剖析,新版本每一个Consumer通过独立的线程,来管理多个Socket连接,即同时与多个broker通信实现消息的并行读取.这就是新版的技术革新.类似于L ...
随机推荐
- 如何将一个div水平垂直居中?6种方法做推荐
方案一: div绝对定位水平垂直居中[margin:auto实现绝对定位元素的居中], 兼容性:,IE7及之前版本不支持 div{ width: 200px; height: 200px; backg ...
- 阿里Canal框架数据库同步-实战教程
一.Canal简介: canal是阿里巴巴旗下的一款开源项目,纯Java开发.基于数据库增量日志解析,提供增量数据订阅&消费,目前主要支持了MySQL(也支持mariaDB). 二.背景介绍: ...
- MySQL 归纳总结
1.MySQL存储引擎 主要使用的就是两个存储引擎,分别是InnoDB和MyISAM. InnoDB InnoDB是MySQL的默认存储引擎.InnoDB采用MVCC来支持高并发,并且实现了四个标准的 ...
- 原创hadoop2.6集群环境搭建
三台机器: Hmaster 172.168.2.3.Hslave1 172.168.2.4.Hslave2 172.168.2.6 JDK:1.8.49 OS:red hat 5.4 64 (由于后期 ...
- Golang Web入门(3):如何优雅的设计中间件
摘要 在上一篇文章中,我们已经可以实现一个性能较高,且支持RESTful风格的路由了.但是,在Web应用的开发中,我们还需要一些可以被扩展的功能. 因此,在设计框架的过程中,应该留出可以扩展的空间,比 ...
- 详解 Arrays类
请关注本人博文--<详解 普通数组 -- Arrays类 与 浅克隆> Arrays类: 概述: 针对数组进行操作的工具类.它提供了对于数组的值的排序.查找等功能. 现在,本人来展示一下A ...
- [V&N2020 公开赛]TimeTravel 复现
大佬友链(狗头):https://www.cnblogs.com/p201821440039/ 参考博客: https://www.zhaoj.in/read-6407.html https://cj ...
- pytorch 文本情感分类和命名实体识别NER中LSTM输出的区别
文本情感分类: 文本情感分类采用LSTM的最后一层输出 比如双层的LSTM,使用正向的最后一层和反向的最后一层进行拼接 def forward(self,input): ''' :param inpu ...
- Python 删除含有只读文件(夹)的文件夹
def rm_read_only(fn, tmp, info): if os.path.isfile(tmp): os.chmod(tmp, stat.S_IWRITE) os.remove(tmp) ...
- [Qt] QlineEdit 限制输入,例如只能输入整数
要注意validor的作用域,如果超出作用域,则会无效.例如下面的代码,在UI的类的构造函数里.所以要new一个validtor. QIntValidator *intValidator = new ...