
python数据统计分析
1. 常用函数库
scipy包中的stats模块和statsmodels包是python常用的数据分析工具,scipy.stats以前有一个models子模块,后来被移除了。这个模块被重写并成为了现在独立的statsmodels包。
scipy的stats包含一些比较基本的工具,比如:t检验,正态性检验,卡方检验之类,statsmodels提供了更为系统的统计模型,包括线性模型,时序分析,还包含数据集,做图工具等等。
2. 小样本数据的正态性检验
(1) 用途
夏皮罗维尔克检验法 (Shapiro-Wilk) 用于检验参数提供的一组小样本数据线是否符合正态分布,统计量越大则表示数据越符合正态分布,但是在非正态分布的小样本数据中也经常会出现较大的W值。需要查表来估计其概率。由于原假设是其符合正态分布,所以当P值小于指定显著水平时表示其不符合正态分布。
正态性检验是数据分析的第一步,数据是否符合正态性决定了后续使用不同的分析和预测方法,当数据不符合正态性分布时,我们可以通过不同的转换方法把非正太态数据转换成正态分布后再使用相应的统计方法进行下一步操作。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

x = stats.norm.rvs(loc=5, scale=10, size=80) # loc为均值,scale为方差

print(stats.shapiro(x))

# 运行结果:(0.9654011726379395, 0.029035290703177452)
(3) 结果分析
返回结果 p-value=0.029035290703177452,比指定的显著水平(一般为5%)小,则拒绝假设:x不服从正态分布。
3. 检验样本是否服务某一分布
(1) 用途
科尔莫戈罗夫检验(Kolmogorov-Smirnov test),检验样本数据是否服从某一分布,仅适用于连续分布的检验。下例中用它检验正态分布。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

x = stats.norm.rvs(loc=0, scale=1, size=300)

print(stats.kstest(x,'norm'))

# 运行结果:KstestResult(statistic=0.0315638260778347, pvalue=0.9260909172362317)
(3) 结果分析
生成300个服从N(0,1)标准正态分布的随机数,在使用k-s检验该数据是否服从正态分布,提出假设:x从正态分布。最终返回的结果,p-value=0.9260909172362317,比指定的显著水平(一般为5%)大,则我们不能拒绝假设:x服从正态分布。这并不是说x服从正态分布一定是正确的,而是说没有充分的证据证明x不服从正态分布。因此我们的假设被接受,认为x服从正态分布。如果p-value小于我们指定的显著性水平,则我们可以肯定的拒绝提出的假设,认为x肯定不服从正态分布,这个拒绝是绝对正确的。
4.方差齐性检验
(1) 用途
方差反映了一组数据与其平均值的偏离程度,方差齐性检验用以检验两组或多组数据与其均值偏离程度是否存在差异,也是很多检验和算法的先决条件。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

rvs1 = stats.norm.rvs(loc=5,scale=10,size=500)

rvs2 = stats.norm.rvs(loc=25,scale=9,size=500)

print(stats.levene(rvs1, rvs2))

# 运行结果:LeveneResult(statistic=1.6939963163060798, pvalue=0.19337536323599344)
(3) 结果分析
返回结果 p-value=0.19337536323599344, 比指定的显著水平(假设为5%)大,认为两组数据具有方差齐性。
5. 图形描述相关性
(1) 用途
最常用的两变量相关性分析,是用作图描述相关性,图的横轴是一个变量,纵轴是另一变量,画散点图,从图中可以直观地看到相关性的方向和强弱,线性正相关一般形成由左下到右上的图形;负相关则是从左上到右下的图形,还有一些非线性相关也能从图中观察到。
(2) 示例
import statsmodels.api as sm

import matplotlib.pyplot as plt

data = sm.datasets.ccard.load_pandas().data

plt.scatter(data['INCOMESQ'], data['INCOME'])
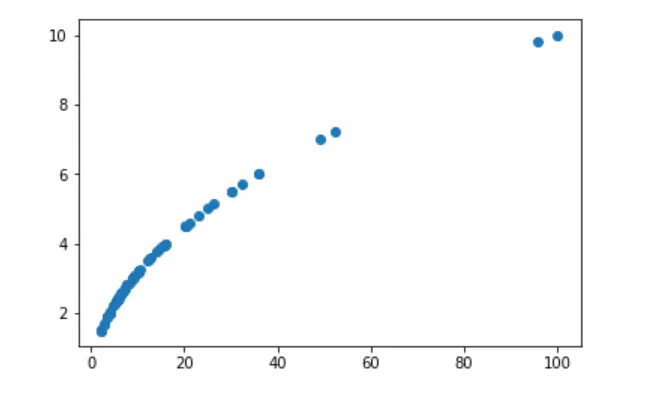
(3) 结果分析
从图中可以看到明显的正相关趋势。
6. 正态资料的相关分析
(1) 用途
皮尔森相关系数(Pearson correlation coefficient)是反应俩变量之间线性相关程度的统计量,用它来分析正态分布的两个连续型变量之间的相关性。常用于分析自变量之间,以及自变量和因变量之间的相关性。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

a = np.random.normal(0,1,100)

b = np.random.normal(2,2,100)

print(stats.pearsonr(a, b))

# 运行结果:(-0.034173596625908326, 0.73571128614545933)
(3) 结果分析
返回结果的第一个值为相关系数表示线性相关程度,其取值范围在[-1,1],绝对值越接近1,说明两个变量的相关性越强,绝对值越接近0说明两个变量的相关性越差。当两个变量完全不相关时相关系数为0。第二个值为p-value,统计学上,一般当p-value<0.05时,可以认为两变量存在相关性。
7. 非正态资料的相关分析
(1) 用途
斯皮尔曼等级相关系数(Spearman’s correlation coefficient for ranked data ),它主要用于评价顺序变量间的线性相关关系,在计算过程中,只考虑变量值的顺序(rank, 秩或称等级),而不考虑变量值的大小。常用于计算类型变量的相关性。
(2) 示例
from scipy import stats

import numpy as np

print(stats.spearmanr([1,2,3,4,5], [5,6,7,8,7]))

# 运行结果:SpearmanrResult(correlation=0.82078268166812329, pvalue=0.088587005313543812)
(3) 结果分析
返回结果的第一个值为相关系数表示线性相关程度,本例中correlation趋近于1表示正相关。第二个值为p-value,p-value越小,表示相关程度越显著。
8. 单样本T检验
(1) 用途
单样本T检验,用于检验数据是否来自一致均值的总体,T检验主要是以均值为核心的检验。注意以下几种T检验都是双侧T检验。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

rvs = stats.norm.rvs(loc=5, scale=10, size=(100,2))

print(stats.ttest_1samp(rvs, [1, 5]))

# 运行结果:Ttest_1sampResult(statistic=array([ 5.12435977,  1.07927393]), pvalue=array([  1.47820719e-06,   2.83088106e-01]))
(3) 结果分析
本例中生成了2列100行的数组,ttest_1samp的第二个参数是分别对两列估计的均值,p-value返回结果,第一列1.47820719e-06比指定的显著水平(一般为5%)小,认为差异显著,拒绝假设;第二列2.83088106e-01大于指定显著水平,不能拒绝假设:服从正态分布。
9. 两独立样本T检验
(1) 用途
有于比较两组数据是否来自于同一正态分布的总体。注意:如果要比较的两组数据不满足方差齐性, 需要在ttest_ind()函数中添加参数equal_var = False。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

rvs1 = stats.norm.rvs(loc=5,scale=10,size=500)

rvs2 = stats.norm.rvs(loc=6,scale=10,size=500)

print(stats.ttest_ind(rvs1,rvs2))

# 运行结果:Ttest_indResult(statistic=-1.3022440006355476, pvalue=0.19313343989106416)
(3) 结果分析
返回结果的第一个值为统计量,第二个值为p-value,pvalue=0.19313343989106416,比指定的显著水平(一般为5%)大,不能拒绝假设,两组数据来自于同一总结,两组数据之间无差异。
10. 配对样本T检验
(1) 用途
配对样本T检验可视为单样本T检验的扩展,检验的对象由一群来自正态分布独立样本更改为二群配对样本观测值之差。它常用于比较同一受试对象处理的前后差异,或者按照某一条件进行两两配对分别给与不同处理的受试对象之间是否存在差异。
(2) 示例
from scipy import stats

import numpy as np

np.random.seed(12345678)

rvs1 = stats.norm.rvs(loc=5,scale=10,size=500)

rvs2 = (stats.norm.rvs(loc=5,scale=10,size=500) + stats.norm.rvs(scale=0.2,size=500))

print(stats.ttest_rel(rvs1,rvs2))

运行结果:Ttest_relResult(statistic=0.24101764965300979, pvalue=0.80964043445811551)
(3) 结果分析
返回结果的第一个值为统计量,第二个值为p-value,pvalue=0.80964043445811551,比指定的显著水平(一般为5%)大,不能拒绝假设。
11. 单因素方差分析
(1) 用途
方差分析(Analysis of Variance,简称ANOVA),又称F检验,用于两个及两个以上样本均数差别的显著性检验。方差分析主要是考虑各组之间的均数差别。
单因素方差分析(One-wayAnova),是检验由单一因素影响的多组样本某因变量的均值是否有显著差异。
当因变量Y是数值型,自变量X是分类值,通常的做法是按X的类别把实例成分几组,分析Y值在X的不同分组中是否存在差异。
(2) 示例
from scipy import stats

a = [47,56,46,56,48,48,57,56,45,57]  # 分组1

b = [87,85,99,85,79,81,82,78,85,91]  # 分组2

c = [29,31,36,27,29,30,29,36,36,33]  # 分组3

print(stats.f_oneway(a,b,c))

# 运行结果:F_onewayResult(statistic=287.74898314933193, pvalue=6.2231520821576832e-19)
(3) 结果分析
返回结果的第一个值为统计量,它由组间差异除以组间差异得到,上例中组间差异很大,第二个返回值p-value=6.2231520821576832e-19小于边界值(一般为0.05),拒绝原假设, 即认为以上三组数据存在统计学差异,并不能判断是哪两组之间存在差异 。只有两组数据时,效果同 stats.levene 一样。
12. 多因素方差分析
(1) 用途
当有两个或者两个以上自变量对因变量产生影响时,可以用多因素方差分析的方法来进行分析。它不仅要考虑每个因素的主效应,还要考虑因素之间的交互效应。
(2) 示例
from statsmodels.formula.api import ols

from statsmodels.stats.anova import anova_lm

import pandas as pd

X1 = [1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2,2]

X2 = [1,1,1,1,1,1,1,1,1,1,2,2,2,2,2,2,2,2,2,2,1,1,1,1,1,1,1,1,1,1,2,2,2,2,2,2,2,2,2,2]

Y  = [76,78,76,76,76,74,74,76,76,55,65,90,65,90,65,90,90,79,70,90, 88,76,76,76,56,76,76,98,88,78,65,67,67,87,78,56,54,56,54,56]

data = {'T':X1, 'G':X2, 'L':Y}

df = pd.DataFrame(data)

formula = 'L~T+G+T:G' # 公式

model = ols(formula,df).fit()

print(anova_lm(model))

'''

运行结果:

            df    sum_sq      mean_sq         F    PR(>F)

T          1.0   265.225   265.225000  2.444407  0.126693

G          1.0   207.025   207.025000  1.908016  0.175698

T:G        1.0  1050.625  1050.625000  9.682932  0.003631

Residual  36.0  3906.100   108.502778       NaN       NaN

'''
(3) 结果分析
上述程序定义了公式,公式中,"~"用于隔离因变量和自变量,”+“用于分隔各个自变量, ":"表示两个自变量交互影响。从返回结果的P值可以看出,X1和X2的值组间差异不大,而组合后的T:G的组间有明显差异。
13. 卡方检验
(1) 用途
上面介绍的T检验是参数检验,卡方检验是一种非参数检验方法。相对来说,非参数检验对数据分布的要求比较宽松,并且也不要求太大数据量。卡方检验是一种对计数资料的假设检验方法,主要是比较理论频数和实际频数的吻合程度。常用于特征选择,比如,检验男人和女人在是否患有高血压上有无区别,如果有区别,则说明性别与是否患有高血压有关,在后续分析时就需要把性别这个分类变量放入模型训练。
基本数据有R行C列, 故通称RC列联表(contingency table), 简称RC表,它是观测数据按两个或更多属性(定性变量)分类时所列出的频数表。
(2) 示例
import numpy as np

import pandas as pd

from scipy.stats import chi2_contingency

np.random.seed(12345678)

data = np.random.randint(2, size=(40, 3)) # 2个分类,50个实例,3个特征

data = pd.DataFrame(data, columns=['A', 'B', 'C'])

contingency = pd.crosstab(data['A'], data['B']) # 建立列联表

print(chi2_contingency(contingency)) # 卡方检验

'''

运行结果:

(0.36556036556036503, 0.54543425102570975, 1,

array([[ 10.45,   8.55],

       [ 11.55,   9.45]]))'''
(3) 结果分析
卡方检验函数的参数是列联表中的频数,返回结果第一个值为统计量值,第二个结果为p-value值,p-value=0.54543425102570975,比指定的显著水平(一般5%)大,不能拒绝原假设,即相关性不显著。第三个结果是自由度,第四个结果的数组是列联表的期望值分布。
14. 单变量统计分析
(1) 用途
单变量统计描述是数据分析中最简单的形式,其中被分析的数据只包含一个变量,不处理原因或关系。单变量分析的主要目的是通过对数据的统计描述了解当前数据的基本情况,并找出数据的分布模型。
单变量数据统计描述从集中趋势上看,指标有:均值,中位数,分位数,众数;从离散程度上看,指标有:极差、四分位数、方差、标准差、协方差、变异系数,从分布上看,有偏度,峰度等。需要考虑的还有极大值,极小值(数值型变量)和频数,构成比(分类或等级变量)。
此外,还可以用统计图直观展示数据分布特征,如:柱状图、正方图、箱式图、频率多边形和饼状图。
15. 多元线性回归
(1) 用途
多元线性回归模型(multivariable linear regression model ),因变量Y(计量资料)往往受到多个变量X的影响,多元线性回归模型用于计算各个自变量对因变量的影响程度,可以认为是对多维空间中的点做线性拟合。
(2) 示例
import statsmodels.api as sm

data = sm.datasets.ccard.load_pandas().data

model = sm.OLS(endog = data['AVGEXP'], exog = data[['AGE','INCOME','INCOMESQ','OWNRENT']]).fit()

print(model.summary())

'''

运行结果:

                            OLS Regression Results

==============================================================================

Dep. Variable:                 AVGEXP   R-squared:                       0.543

Model:                            OLS   Adj. R-squared:                  0.516

Method:                 Least Squares   F-statistic:                     20.22

Date:                Thu, 31 Jan 2019   Prob (F-statistic):           5.24e-11

Time:                        15:11:29   Log-Likelihood:                -507.24

No. Observations:                  72   AIC:                             1022.

Df Residuals:                      68   BIC:                             1032.

Df Model:                           4

Covariance Type:            nonrobust

==============================================================================

                 coef    std err          t      P>|t|      [0.025      0.975]

------------------------------------------------------------------------------

AGE           -6.8112      4.551     -1.497      0.139     -15.892       2.270

INCOME       175.8245     63.743      2.758      0.007      48.628     303.021

INCOMESQ      -9.7235      6.030     -1.613      0.111     -21.756       2.309

OWNRENT       54.7496     80.044      0.684      0.496    -104.977     214.476

==============================================================================

Omnibus:                       76.325   Durbin-Watson:                   1.692

Prob(Omnibus):                  0.000   Jarque-Bera (JB):              649.447

Skew:                           3.194   Prob(JB):                    9.42e-142

Kurtosis:                      16.255   Cond. No.                         87.5

==============================================================================

'''
(3) 结果分析
直接通过返回结果中各变量的P值与0.05比较,来判定对应的解释变量的显著性,P<0.05则认为自变量具有统计学意义,从上例中可以看到收入INCOME最有显著性。
16. 逻辑回归
(1) 用途
当因变量Y为2分类变量(或多分类变量时)可以用相应的logistic回归分析各个自变量对因变量的影响程度。
(2) 示例
import statsmodels.api as sm

data = sm.datasets.ccard.load_pandas().data

data['OWNRENT'] = data['OWNRENT'].astype(int)

model = sm.Logit(endog = data['OWNRENT'], exog = data[['AVGEXP','AGE','INCOME','INCOMESQ']]).fit()

print(model.summary())

'''

运行结果:

Optimization terminated successfully.

         Current function value: 0.504920

         Iterations 8

                           Logit Regression Results

==============================================================================

Dep. Variable:                OWNRENT   No. Observations:                   72

Model:                          Logit   Df Residuals:                       68

Method:                           MLE   Df Model:                            3

Date:                Fri, 01 Feb 2019   Pseudo R-squ.:                  0.2368

Time:                        17:05:47   Log-Likelihood:                -36.354

converged:                       True   LL-Null:                       -47.633

                                        LLR p-value:                 4.995e-05

==============================================================================

                 coef    std err          z      P>|z|      [0.025      0.975]

------------------------------------------------------------------------------

AVGEXP         0.0002      0.001      0.228      0.820      -0.002       0.002

AGE            0.0853      0.042      2.021      0.043       0.003       0.168

INCOME        -2.5798      0.822     -3.137      0.002      -4.191      -0.968

INCOMESQ       0.4243      0.126      3.381      0.001       0.178       0.670

==============================================================================

'''
(3) 结果分析
直接通过返回结果中各变量的P值与0.05比较,来判定对应的解释变量的显著性,P<0.05则认为自变量具有统计学意义。
python数据统计分析的更多相关文章
- [原创博文] 用Python做统计分析 (Scipy.stats的文档)
[转自] 用Python做统计分析 (Scipy.stats的文档) 对scipy.stats的详细介绍: 这个文档说了以下内容,对python如何做统计分析感兴趣的人可以看看,毕竟Python的库也 ...
- Python数据可视化 -- Wordcloud
Python数据可视化 -- Wordcloud 安装 启动命令行,输入:pip install wordcloud word cloud 库介绍 及简单使用 wordcloud库,可以说是pytho ...
- 关于python数据序列化的那些坑
-----世界上本来没那么多坑,python更新到3以后坑就多了 无论哪一门语言开发,都离不了数据储存与解析,除了跨平台性极好的xml和json之外,python要提到的还有自身最常用pickle模块 ...
- Python数据可视化编程实战——导入数据
1.从csv文件导入数据 原理:with语句打开文件并绑定到对象f.不必担心在操作完资源后去关闭数据文件,with的上下文管理器会帮助处理.然后,csv.reader()方法返回reader对象,通过 ...
- Python 数据分析(二 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识
Python 数据分析(二) 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识 第1节 groupby 技术 第2节 数据聚合 第3节 分组级运算和转换 第4 ...
- Python数据网络采集5--处理Javascript和重定向
Python数据网络采集5--处理Javascript和重定向 到目前为止,我们和网站服务器通信的唯一方式,就是发出HTTP请求获取页面.有些网页,我们不需要单独请求,就可以和网络服务器交互(收发信息 ...
- Python数据可视化——使用Matplotlib创建散点图
Python数据可视化——使用Matplotlib创建散点图 2017-12-27 作者:淡水化合物 Matplotlib简述: Matplotlib是一个用于创建出高质量图表的桌面绘图包(主要是2D ...
- Python数据可视化-seaborn库之countplot
在Python数据可视化中,seaborn较好的提供了图形的一些可视化功效. seaborn官方文档见链接:http://seaborn.pydata.org/api.html countplot是s ...
- Python数据可视化编程实战pdf
Python数据可视化编程实战(高清版)PDF 百度网盘 链接:https://pan.baidu.com/s/1vAvKwCry4P4QeofW-RqZ_A 提取码:9pcd 复制这段内容后打开百度 ...
随机推荐
- vueThink框架搭建与填坑(new)
自己跟着官网搭建vueThink框架,发现github上文档有很多坑.所以总结一下(仅针对WIN端下载使用) 1.安装node.js 前端部分是基于node.js上运行的,所以必须先安装node.js ...
- Thinking in Java,Fourth Edition(Java 编程思想,第四版)学习笔记(四)之Operators
At the lowest level, data in Java is manipulated using operators Using Java Operators An operator ta ...
- Thinking in Java,Fourth Edition(Java 编程思想,第四版)学习笔记(一)之Introduction
Learn Java I found out that I and other speakers tended to give the typical audience too many topics ...
- 绕过CDN查找真实 IP 姿势总结
返回域名解析对应多个 IP 地址,网站可能部署CDN业务,我们就需要bypass CDN,去查找真正的服务器ip地址 0x01.域名搜集 由于成本问题,可能某些厂商并不会将所有的子域名都部署 CDN, ...
- 在学习java之余,js的使用精髓-闭包和原型链
这里分享下廖雪峰官网写的js教程,内容写的比较实用,易懂,其中简介的原型链和闭包的知识,小伙伴们一起上呀,畅游在知识的海洋中: 地址:https://www.liaoxuefeng.com/wiki/ ...
- A Bug's Life POJ 2492
D - A Bug's Life 二分图 并查集 BackgroundProfessor Hopper is researching the sexual behavior of a rare spe ...
- lua使用笔记1:Linux 中安装lua
1.lua安装 1)http://www.lua.org/download.html为下载页面 linux中运行 wget http://www.lua.org/ftp/lua-5.2.3.tar.g ...
- 反转链表-PHP的实现
<? //节点 class Node { private $Data;//节点数据 private $Next;//下一节点 public function setData($value) { ...
- c++<ctime>中常用函数
先说一下c++标准库并没有提供所谓的日期类型,而是继承了c的日期类型 <cmath>里面有些常用的函数,比如计时函数clock().获取系统时间的函数time(),下面就具体的介绍一下 1 ...
- 在 Azure CentOS VM 中配置 SQL Server 2019 AG - (上)
前文 假定您对Azure和SQL Server HA具有基础知识 假定您对Azure Cli具有基础知识 目标是在Azure Linux VM上创建一个具有三个副本的可用性组,并实现侦听器和Fenci ...