
Python爬虫连载5-Proxy、Cookie解析
一、ProxyHandler处理(代理服务器)
1.使用代理IP,是爬虫的常用手段
2.获取代理服务器的地址:
www.xicidaili.com
www.goubanjia.com
3.代理用来隐藏真实访问中,代理不允许频繁访问某一个固定网站,所以代理一定要很多很多。
4.基本使用步骤:
(1)设置代理地址
(2)创建PoxyHandler
(3)创建Opener
(4)安装Opener
"""
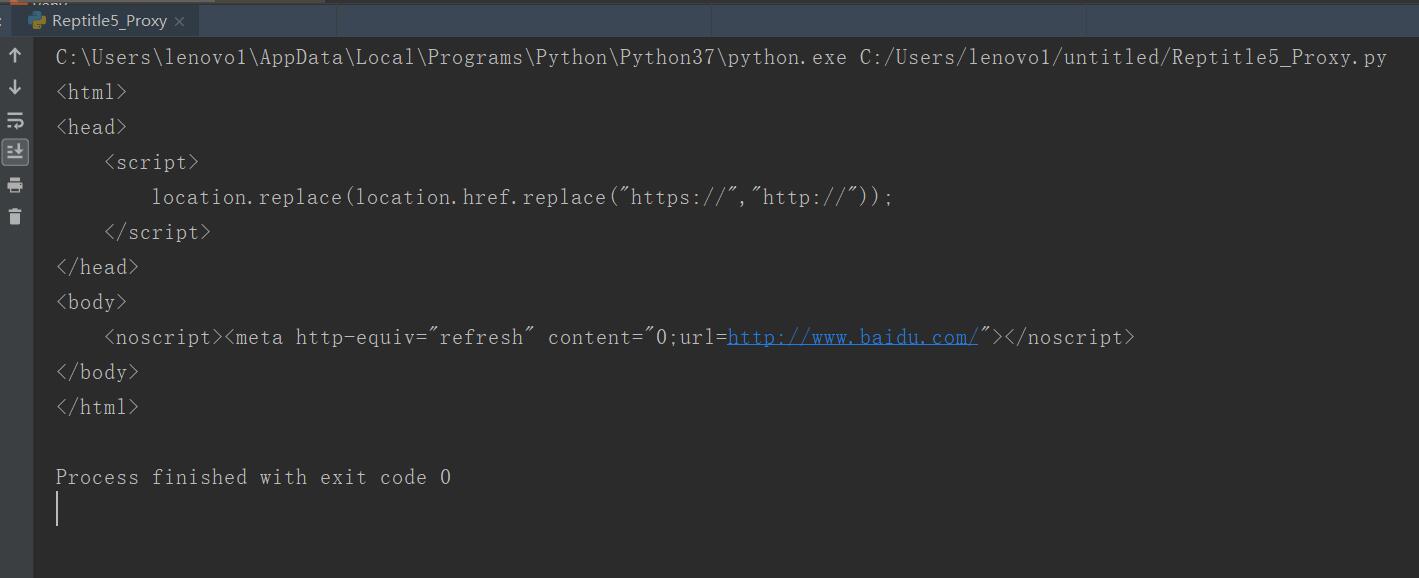
使用代理访问百度首页
"""
from urllib import request,error
if __name__ =="__main__":
url = "https://www.baidu.com"
#设置代理地址
proxy = {"http":"39.106.114.143:80"}
#创建ProxyHandler
proxy_handler = request.ProxyHandler(proxy)
#创建Opener
opener = request.build_opener(proxy_handler)
#安装Opener
request.install_opener(opener)
#现在如果访问url。那么就会使用代理服务器
try:
rsp = request.urlopen(url)
html = rsp.read().decode()
print(html)
except error.URLError as e:
print(e)
except Exception as e:
print(e)
二、cookie
1..由于http协议的无记忆性,人们为了弥补这个缺憾,所采用的一个补充协议。
2.cookie是发放给用户(即http浏览器)的一段信息,session是保存在服务器上的对应的另一半的信息,用来记录用户信息。
3.cookie和session的区别
(1)存放的位置不相同;(2)cookie不安全;(3)session会保存在服务器上一定时间,会过期;(3)单个cookie保存数据不超过4k,很多浏览器限制一个站点最多保存20个。
4.session存放位置
(1)存在服务器上;(2)一般情况下,session是放在内存中或者数据库中。
5.案例:
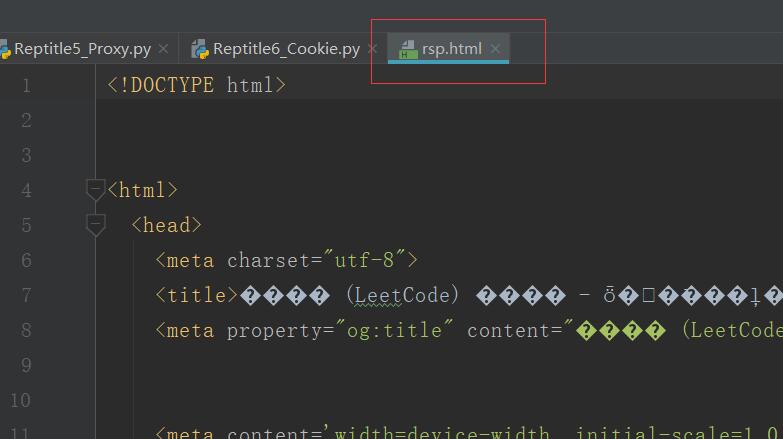
没有cookie登录则反馈网页为未登录状态
使用cookie登录
from urllib import request
if __name__ == "__main__":
url = "https://leetcode-cn.com/"
headers = {
"cookie":"_ga=GA1.2.606835635.1580743041; gr_user_id=d15dfef5-20a7-44a4-8181-f088825ee052; grwng_uid=1d99b83c-8186-4ffa-905e-c912960d9049; __auc=952db4f31700ba0a3811855dc67; csrftoken=zW1tIWrqqDGQ2gDeEAiRM3Pu41f3qetXjvNP5jxuDpekTTyHj262rmfnO2PtXiCI; LEETCODE_SESSION=eyJ0eXAiOiJKV1QiLCJhbGciOiJIUzI1NiJ9.eyJfYXV0aF91c2VyX2lkIjoiOTUxOTE1IiwiX2F1dGhfdXNlcl9iYWNrZW5kIjoiYXV0aGVudGljYXRpb24uYXV0aF9iYWNrZW5kcy5QaG9uZUF1dGhlbnRpY2F0aW9uQmFja2VuZCIsIl9hdXRoX3VzZXJfaGFzaCI6ImQ0ODczNmFiODAwZjk0ZTU3ZjAwMmQ4YjU1YjRmNWZmMDViMDllOTIiLCJpZCI6OTUxOTE1LCJlbWFpbCI6IiIsInVzZXJuYW1lIjoicnVpZ2VnZTY2IiwidXNlcl9zbHVnIjoicnVpZ2VnZTY2IiwiYXZhdGFyIjoiaHR0cHM6Ly9hc3NldHMubGVldGNvZGUtY24uY29tL2FsaXl1bi1sYy11cGxvYWQvZGVmYXVsdF9hdmF0YXIucG5nIiwicGhvbmVfdmVyaWZpZWQiOnRydWUsInRpbWVzdGFtcCI6IjIwMjAtMDItMDMgMTU6MTg6MDYuNjYw160b58f59beeae32; a2873925c34ecbd2_gr_session_id=e9ba4267-3dbc-47c1-aa02-c6e92e8eb4a8; a2873925c34ecbd2_gr_last_sent_sid_with_cs1=e9ba4267-3dbc-47c1-aa02-c6e92e8eb4a8; a2873925c34ecbd2_gr_session_id_e9ba4267-3dbc-47c1-aa02-c6e92e8eb4a8=true; _gid=GA1.2.1242221115.1580917808; Hm_lpvt_fa218a3ff7179639febdb15e372f411c=1580917870; a2873925c34ecbd2_gr_cs1=ruigege66; _gat_gtag_UA_131851415_1=1"
}
req = request.Request(url,headers=headers)
rsp = request.urlopen(req)
html = rsp.read().decode()
with open("rsp.html","w") as f:
f.write(html.encode("GBK","ignore").decode("GBK"))
三、源码
Reptitle5_Proxy.py
Reptitle6_Cookie.py
https://github.com/ruigege66/PythonReptile/blob/master/Reptitle5_Proxy.py
https://github.com/ruigege66/PythonReptile/blob/master/Reptitle6_Cookie.py
2.CSDN:https://blog.csdn.net/weixin_44630050
3.博客园:https://www.cnblogs.com/ruigege0000/
4.欢迎关注微信公众号:傅里叶变换,个人公众号,仅用于学习交流,后台回复”礼包“,获取大数据学习资料
Python爬虫连载5-Proxy、Cookie解析的更多相关文章
- python爬虫 - Urllib库及cookie的使用
http://blog.csdn.net/pipisorry/article/details/47905781 lz提示一点,python3中urllib包括了py2中的urllib+urllib2. ...
- Python爬虫入门六之Cookie的使用
大家好哈,上一节我们研究了一下爬虫的异常处理问题,那么接下来我们一起来看一下Cookie的使用. 为什么要使用Cookie呢? Cookie,指某些网站为了辨别用户身份.进行session跟踪而储存在 ...
- 小白学 Python 爬虫(21):解析库 Beautiful Soup(上)
小白学 Python 爬虫(21):解析库 Beautiful Soup(上) 人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前 ...
- 小白学 Python 爬虫(22):解析库 Beautiful Soup(下)
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(23):解析库 pyquery 入门
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- Python爬虫教程-15-读取cookie(人人网)和SSL(12306官网)
Python爬虫教程-15-爬虫读取cookie(人人网)和SSL(12306官网) 上一篇写道关于存储cookie文件,本篇介绍怎样读取cookie文件 cookie的读取 案例v16ssl文件:h ...
- Python爬虫连载1-urllib.request和chardet包使用方式
一.参考资料 1.<Python网络数据采集>图灵工业出版社 2.<精通Python爬虫框架Scrapy>人民邮电出版社 3.[Scrapy官方教程](http://scrap ...
- Python爬虫连载10-Requests模块、Proxy代理
一.Request模块 1.HTTP for Humans,更简洁更友好 2.继承了urllib所有的特征 3.底层使用的是urllib3 4.开源地址:https://github.com/req ...
- Python爬虫连载3-Post解析、Request类
一.访问网络的两种方法 1.get:利用参数给服务器传递信息:参数为dict,然后parse解码 2.post:一般向服务器传递参数使用:post是把信息自动加密处理:如果想要使用post信息,需要使 ...
随机推荐
- PyQt5打印机
1.打印机操作(打印默认文本里面的内容)from PyQt5 import QtGui,QtWidgets,QtPrintSupportfrom PyQt5.QtWidgets import *imp ...
- Python中的lambda函数介绍
Lambda函数,即Lambda 表达式(lambda expression),是一个匿名函数(不存在函数名的函数),Lambda表达式基于数学中的λ演算得名,直接对应于其中的lambda抽象(lam ...
- 关于OSPF LSA不稳定!
Issue 1 Solution It is important that you understand the error message during attempts to troublesho ...
- 临时解决执行 Composer Install 返回 Killed 的问题
昨天在 Linux 服务器上部署 PHP 项目时遇到了一个问题,系统为 Centos 7 ,1 核 1G 的配置.通过 Git 拉取代码后,由于是基于 Laravel 框架的项目,所以需要使用 Com ...
- 动态规划-爬楼梯问题java实现
最近开始看算法导论,研究了一下动态规划,下面就开始直入主题开始记录近期看的第一个知识点动态规划.提起动态规划就不得不提几个动态规划的金典问题爬楼梯.国王金矿.背包问题.今天就仔细分析一下爬楼梯问题. ...
- LeetCode中等题(三)
题目一: 反转从位置 m 到 n 的链表.请使用一趟扫描完成反转. 说明:1 ≤ m ≤ n ≤ 链表长度. 示例: 输入: 1->2->3->4->5->NULL, m ...
- 与英特尔分道扬镳,苹果的5G业务掉队了吗?
5G概念已经大热,越来越多的厂商推出相关产品,中国骄傲之华为不仅在5G通信标准制定方面参与感非常强,也先于竞争对手推出5G智能终端,连同三星/Vivo等也纷纷推出5G终端,而作为智能手机市场绝对的利润 ...
- [ DLPytorch ] 循环神经网络进阶&拟合问题&梯度消失与爆炸
循环神经网络进阶 BPTT 反向传播过程中,训练模型通常需要模型参数的梯度. \[ \frac{\partial L}{\partial \boldsymbol{W}_{qh}} = \sum_{t= ...
- 【摘录自MDN】对事件冒泡和捕捉的解释
当一个事件触发了一个有父元素的元素(例如我们的<video>时),现代浏览器运行两个不同的阶段 - 捕获阶段和冒泡阶段. 在捕获阶段: 浏览器检查元素的最外层祖先(<html> ...
- python合并大量ts文件成mp4格式(ps:上限是450,亲测)
import os #exec_str = r'copy /b ts/c9645620628078.ts+ts/c9645620628079.ts ts/1.ts' #os.system(exec_s ...