
怎样借助Python爬虫给宝宝起个好名字
每个人一生中都会遇到一件事情,在事情出现之前不会关心,但是事情一旦来临就发现它极其重要,并且需要在很短的时间内做出重大决定,那就是给自己的新生宝宝起个名字。因为要在孩子出生后两周内起个名字(需要办理出生证明了),估计很多人都像我一样,刚开始是很慌乱的,虽然感觉汉字非常的多随便找个字做名字都行,后来才发现真不是随便的事情,怎么想都发现不合适,于是到处翻词典、网上搜、翻唐诗宋词、诗经、甚至武侠小说,然而想了很久得到的名字,往往却受到家属的意见和反对,比如不顺口、和亲戚重名重音等问题,这样就陷入了重复寻找和否定的循环,越来越混乱。
每个人一生中都会遇到一件事情,在事情出现之前不会关心,但是事情一旦来临就发现它极其重要,并且需要在很短的时间内做出重大决定,那就是给自己的新生宝宝起个名字。
因为要在孩子出生后两周内起个名字(需要办理出生证明了),估计很多人都像我一样,刚开始是很慌乱的,虽然感觉汉字非常的多随便找个字做名字都行,后来才发现真不是随便的事情,怎么想都发现不合适,于是到处翻词典、网上搜、翻唐诗宋词、诗经、甚至武侠小说,然而想了很久得到的名字,往往却受到家属的意见和反对,比如不顺口、和亲戚重名重音等问题,这样就陷入了重复寻找和否定的循环,越来越混乱。
于是我们再次回到网上各种搜索,找到很多网上给出的“男宝宝好听的名字大全”之类的文章,这些文章一下子给出几百上千个名字,看的眼花缭乱没法使用。而有不少的测名字的网站或者APP,输入名字能给出八字或者五格的评分,这样的功能感觉还挺好的能给个参考,然而要么我们需要一个个名字的输入进行测试、要么这些网站或者APP自身的名字很少、要么不能满足我们的需求比如限定字、要么就开始收费,到最后也找不到一个好用的。
于是我想做这么一个程序:
- 主要的功能,是给出批量名字提供参考,这些名字是结合宝宝的生辰八字算出来的;
- 自己可以扩充名字库,比如网上发现了一批诗经里的好名字,想看看怎么样,添加进去就能用;
- 可以限定名字的使用字,比如有的家族谱有限定,当前是“国”字辈,名字中必须有“国”字;
- 名字列表可以给出评分,这样倒排后就可以从高分往低分来看名字;
通过这种方式可以得到一份符合自己孩子生辰八字、自己的家谱限制、以及自己喜好的名字列表,并且该列表已经给出了分数用于参考,以此为基准我们可以挨个琢磨找出心仪的名字。当然如果有新的想法,随时可以把新的名字添加到词库里面,进行重新计算。
程序的代码结构
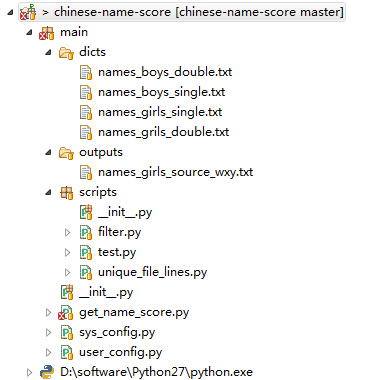
代码介绍:
- /chinese-name-score 代码根目录
- /chinese-name-score/main 代码目录
- /chinese-name-score/main/dicts 词典文件目录
- /chinese-name-score/main/dicts/names_boys_double.txt 词典文件,男孩的双字名字
- /chinese-name-score/main/dicts/names_boys_single.txt 词典文件,男孩的单字名字
- /chinese-name-score/main/dicts/names_girls_single.txt 词典文件,女孩的双字名字
- /chinese-name-score/main/dicts/names_grils_double.txt 词典文件,女孩的单字名字
- /chinese-name-score/main/outputs 输出数据目录
- /chinese-name-score/main/outputs/names_girls_source_wxy.txt 输出的示例文件
- /chinese-name-score/main/scripts 一些对词典文件做预处理的脚本
- /chinese-name-score/main/scripts/unique_file_lines.py 设定词典文件,对词典中的名字去重和去空白行
- /chinese-name-score/main/sys_config.py 程序的系统配置,包含爬取得目标URL、词典文件路径
- /chinese-name-score/main/user_config.py 程序的用户配置,包括宝宝的年月日时分性别等设定
- /chinese-name-score/main/get_name_score.py 程序的运行入口
使用代码的方法:
- 如果没有限定字,就找到词典文件names_boys_double.txt和names_grils_double.txt,可以在这里添加自己找到的一些名字列表,按行分割添加在最后即可;
- 如果有限定字,就找到词典文件names_boys_single.txt和names_girls_single.txt,在这里添加自己预先中意的单个字列表,按行分割添加在最后即可;
- 打开user_config.py,进行配置,配置项见下一节;
- 运行脚本get_name_score.py
- 在outputs目录中,查看自己的产出文件,可以复制到Excel,进行排序等操作;
程序的配置入口
程序的配置如下:
Python
| 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 |
# coding:GB18030 """ 在这里写好配置 """ setting = {} # 限定字,如果配置了该值,则会取用单字字典,否则取用多字字典 setting["limit_world"] = "国" # 姓 setting["name_prefix"] = "李" # 性别,取值为 男 或者 女 setting["sex"] = "男" # 省份 setting["area_province"] = "北京" # 城市 setting["area_region"] = "海淀" # 出生的公历年份 setting['year'] = "2017" # 出生的公历月份 setting['month'] = "1" # 出生的公历日子 setting['day'] = "11" # 出生的公历小时 setting['hour'] = "11" # 出生的公历分钟 setting['minute'] = "11" # 结果产出文件名称 setting['output_fname'] = "names_girls_source_xxx.txt" |
根据配置项setting[“limit_world”],系统自动来决定选用单字词典还是多字词典:
- 如果设置了该项,比如等于“国”,那么程序会组合所有的单字为名字用于计算,比如国浩和浩国两个名字都会计算;
- 如果不设置该项,保持空字符串,则程序只会读取*_double.txt的双字词典
程序的原理
这是一个简单的爬虫。大家可以打开http://life.httpcn.com/xingming.asp网站查看,这是一个POST表单,填写需要的参数,点提交,就会打开一个结果页面,结果页面的最下方包含了八字分数和五格分数。
如果想得到分数,就需要做两件事情,一是爬虫自动提交表单,获取结果页面;二是从结果页面提取分数;
对于第一件事情,很简单,urllib2即可实现(代码在/chinese-name-score/main/get_name_score.py):
Python
| 1 2 3 |
post_data = urllib.urlencode(params) req = urllib2.urlopen(sys_config.REQUEST_URL, post_data) content = req.read() |
这里的params是个参数dict,使用这种方式,就进行了POST带数据的提交,然后从content得到了结果数据。
params的参数设定如下:
Python
| 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 |
params = {} # 日期类型,0表示公历,1表示农历 params['data_type'] = "0" params['year'] = "%s" % str(user_config.setting["year"]) params['month'] = "%s" % str(user_config.setting["month"]) params['day'] = "%s" % str(user_config.setting["day"]) params['hour'] = "%s" % str(user_config.setting["hour"]) params['minute'] = "%s" % str(user_config.setting["minute"]) params['pid'] = "%s" % str(user_config.setting["area_province"]) params['cid'] = "%s" % str(user_config.setting["area_region"]) # 喜用五行,0表示自动分析,1表示自定喜用神 params['wxxy'] = "0" params['xing'] = "%s" % (user_config.setting["name_prefix"]) params['ming'] = name_postfix # 表示女,1表示男 if user_config.setting["sex"] == "男": params['sex'] = "1" else: params['sex'] = "0" params['act'] = "submit" params['isbz'] = "1" |
第二件事情,就是从网页中提取需要的分数,我们可以使用BeautifulSoup4来实现,其语法也很简单:
Python
| 1 2 3 4 5 6 7 8 9 10 11 12 13 |
soup = BeautifulSoup(content, 'html.parser', from_encoding="GB18030") full_name = get_full_name(name_postfix) # print soup.find(string=re.compile(u"姓名五格评分")) for node in soup.find_all("div", class_="chaxun_b"): node_cont = node.get_text() if u'姓名五格评分' in node_cont: name_wuge = node.find(string=re.compile(u"姓名五格评分")) result_data['wuge_score'] = name_wuge.next_sibling.b.get_text() if u'姓名八字评分' in node_cont: name_wuge = node.find(string=re.compile(u"姓名八字评分")) result_data['bazi_score'] = name_wuge.next_sibling.b.get_text() |
通过该方法,就能对HTML解析,提取八字和五格的分数。
运行结果事例
| 1 2 3 4 5 6 7 8 9 10 11 12 |
1/1287 李国锦姓名八字评分=61.5姓名五格评分=78.6总分=140.1 2/1287 李国铁姓名八字评分=61姓名五格评分=89.7总分=150.7 3/1287 李国晶姓名八字评分=21姓名五格评分=81.6总分=102.6 4/1287 李鸣国姓名八字评分=21姓名五格评分=90.3总分=111.3 5/1287 李柔国姓名八字评分=64姓名五格评分=78.3总分=142.3 6/1287 李国经姓名八字评分=21姓名五格评分=89.8总分=110.8 7/1287 李国蒂姓名八字评分=22姓名五格评分=87.2总分=109.2 8/1287 李国登姓名八字评分=21姓名五格评分=81.6总分=102.6 9/1287 李略国姓名八字评分=21姓名五格评分=83.7总分=104.7 10/1287 李国添姓名八字评分=21姓名五格评分=81.6总分=102.6 11/1287 李国天姓名八字评分=22姓名五格评分=83.7总分=105.7 12/1287 李国田姓名八字评分=22姓名五格评分=93.7总分=115.7 |
有了这些分数,我们就可以进行排序,是一个很实用的参考资料。
友情提示
- 分数跟很多因素有关,比如出生时刻、已经限定的字、限定字的笔画等因素,这些条件决定了有些名字不会分数高,不要受此影响,找出相对分数高的就可以了;
- 目前程序只能抓取一个网站的内容,地址是http://life.httpcn.com/xingming.asp
- 本列表仅供参考,看过一些文章,历史上很多名人伟人,姓名八字评分都非常低但是都建功立业,名字确实会有些影响但有时候朗朗上口就是最好的;
- 从本列表中选取名字之后,可以在百度、人人网等地方查查,以防有些负面的人重名、或者起这个名字的人太多了烂大街;
- 八字分数是中国传承,五格分数是日本人近代发明的,有时候也可以试试西方的星座起名法,并且奇怪的是八字和五个分数不同网站打分相差很大,更说明了这东西只供参考;
怎样借助Python爬虫给宝宝起个好名字的更多相关文章
- 怎样借助Python爬虫给宝宝起个好名字--python 学习
每个人一生中都会遇到一件事情,在事情出现之前不会关心,但是事情一旦来临就发现它极其重要,并且需要在很短的时间内做出重大决定,那就是给自己的新生宝宝起个名字. 因为要在孩子出生后两周内起个名字(需要办理 ...
- 一个简单的python爬虫程序
python|网络爬虫 概述 这是一个简单的python爬虫程序,仅用作技术学习与交流,主要是通过一个简单的实际案例来对网络爬虫有个基础的认识. 什么是网络爬虫 简单的讲,网络爬虫就是模拟人访问web ...
- Python 爬虫修养-处理动态网页
Python 爬虫修养-处理动态网页 本文转自:i春秋社区 0x01 前言 在进行爬虫开发的过程中,我们会遇到很多的棘手的问题,当然对于普通的问题比如 UA 等修改的问题,我们并不在讨论范围,既然要将 ...
- Python爬虫之使用Fiddler+Postman+Python的requests模块爬取各国国旗
介绍 本篇博客将会介绍一个Python爬虫,用来爬取各个国家的国旗,主要的目标是为了展示如何在Python的requests模块中使用POST方法来爬取网页内容. 为了知道POST方法所需要传 ...
- python爬虫常见面试题(二)
前言 之所以在这里写下python爬虫常见面试题及解答,一是用作笔记,方便日后回忆:二是给自己一个和大家交流的机会,互相学习.进步,希望不正之处大家能给予指正:三是我也是互联网寒潮下岗的那批人之一,为 ...
- Python爬虫实战---抓取图书馆借阅信息
Python爬虫实战---抓取图书馆借阅信息 原创作品,引用请表明出处:Python爬虫实战---抓取图书馆借阅信息 前段时间在图书馆借了很多书,借得多了就容易忘记每本书的应还日期,老是担心自己会违约 ...
- 【Python爬虫】听说你又闹书荒了?豆瓣读书9.0分书籍陪你过五一
说明 五一将至,又到了学习的季节.目前流行的各大书单主打的都是豆瓣8.0评分书籍,却很少有人来聊聊这9.0评分的书籍长什么样子.刚好最近学了学python爬虫,那就拿豆瓣读书来练练手. 爬虫 本来思路 ...
- Python爬虫教程-05-python爬虫实现百度翻译
使用python爬虫实现百度翻译功能 python爬虫实现百度翻译: python解释器[模拟浏览器],发送[post请求],传入待[翻译的内容]作为参数,获取[百度翻译的结果] 通过开发者工具,获取 ...
- python爬虫之认识爬虫和爬虫原理
python爬虫之基础学习(一) 网络爬虫 网络爬虫也叫网络蜘蛛.网络机器人.如今属于数据的时代,信息采集变得尤为重要,可以想象单单依靠人力去采集,是一件无比艰辛和困难的事情.网络爬虫的产生就是代替人 ...
随机推荐
- Linux 定时实行一次任务命令
当我们想在指定的时间自动执行 一次 任务的时候,可以使用at命令 启动服务 使用时首先检查atq的服务是否启动 service atd status # 检查atd的状态 service atd st ...
- 使用Azure Rest API获得Access Token介绍
背景 本文主要介绍如何获取如何获取Azure Rest API的访问token,所采用的是v2.0版本的Microsoft标识平台,关于1.0和2.0的区别可以参考 https://docs.azur ...
- mac 升级到mavericks 安装php扩展现问题
mac 升级到mavericks 安装php扩展现以下问题 grep: /usr/include/php/main/php.h: No such file or directory grep: /us ...
- Golang Web入门(1):自顶向下理解Http服务器
摘要 由于Golang优秀的并发处理,很多公司使用Golang编写微服务.对于Golang来说,只需要短短几行代码就可以实现一个简单的Http服务器.加上Golang的协程,这个服务器可以拥有极高的性 ...
- "二号标题"组件:<h2> —— 快应用组件库H-UI
 <import name="h2" src="../Common/ui/h-ui/text/c_h2"></import> < ...
- 萌新带你开车上p站(三)
本文作者:萌新 前情回顾: 萌新带你开车上p站(一) 萌新带你开车上p站(二) 0x08 题目给的提示是和运算符优先级有关 登录后直接看源码 mistake@pwnable:~$ ls flag mi ...
- spring jar 包 用处功能:
自己积累的: @ spring-context-3.0.5.RELEASE.jar :主要用于 spring程序中加载类 ApplicationContext 用.eq: ApplicationC ...
- AJ学IOS 之微博项目实战(6)导航控制器NavigationController 的滑动回退功能实现
AJ分享,必须精品 一:效果 第二篇里面写了怎样自定义navigation实现自定义的导航控制器左右按钮样式,但是当我们自己实现后,系统自带的向右边滑动来实现回退的功能就不能用了. 这里主要实现滑动回 ...
- ios 中使用 animation-play-state: paused 属性失效的问题
前言 因为要做一个播放器的播放图片旋转动画,像这样子 当音乐播放就转动,停止就暂停. 开始于是很自然地想到了使用Css3的 animation 动画属性CSS3 animation(动画) 属性 an ...
- 给我Python几十行代码,我还你一个微信聊天助手
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 故事胶片 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...