
Transformer模型---decoder
一、结构
1.编码器
Transformer模型---encoder - nxf_rabbit75 - 博客园
2.解码器
(1)第一个子层也是一个多头自注意力multi-head self-attention层,但是,在计算位置i的self-attention时屏蔽掉了位置i之后的序列值,这意味着:位置i的attention只能依赖于它之前的结果,不能依赖它之后的结果。因此,这种self-attention也被称作masked self-attention。
(2)第二个子层是一个多头注意力multi-head attention层,用于捕获decoder output和encoder output之间的attention。第三个子层是一个简单的全连接层。
(3)和encoder一样:每个子层都使用残差直连,并且残差直连之后跟随一个layer normalization:LN;decoder所有层的输入、输出的向量维度也是$d_{model}=512$维。
二、Tips
1.使用multi-head attention的三个适用场景:
encoder-decoder attention:使用multi-head attention,输入为encoder的输出和decoder的self-attention输出,其中encoder的self-attention作为 key and value,decoder的self-attention作为query
encoder self-attention:使用 multi-head attention,输入的Q、K、V都是一样的(input embedding and positional embedding)
decoder self-attention:在decoder的self-attention层中,deocder 都能够访问当前位置前面的位置
2.decoder的masked self-attention
注意encoder里面是叫self-attention,decoder里面是叫masked self-attention。
这里的masked就是要在做language modelling(或者像翻译)的时候,不给模型看到未来的信息。
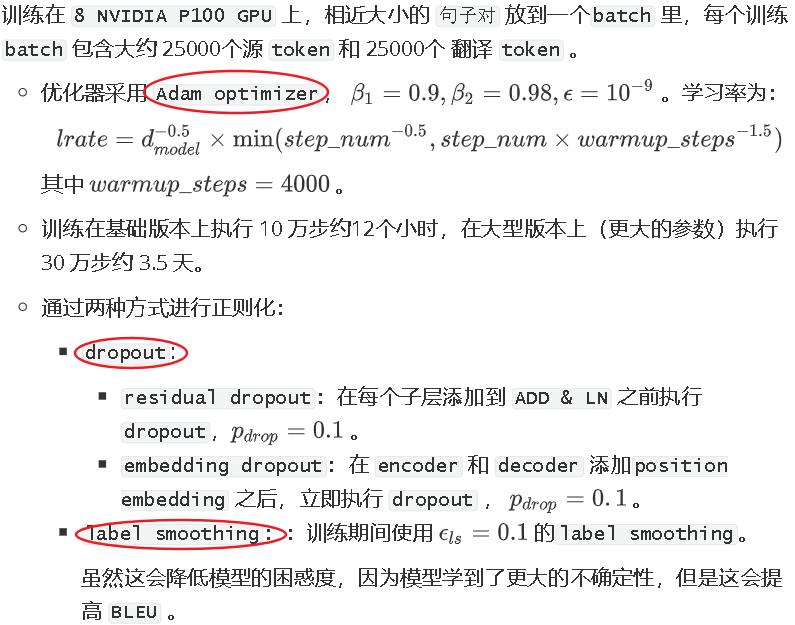
3.优化
三、Transformer vs CNN vs RNN
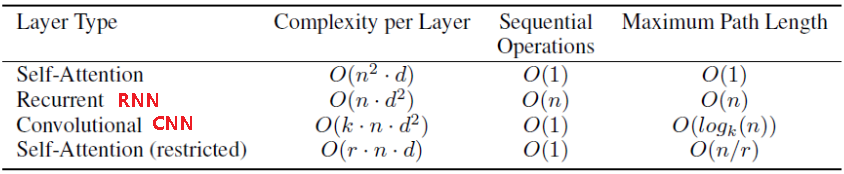
1.假设输入序列长度为n,每个元素的维度为$d:\{x_1,...,x_n\}$,输出序列长度也为n,每个元素的维度也是d:$\{y_1,...,y_n\}$,从每层的计算复杂度、并行的操作数量、学习距离长度三个方面比较Transformer、CNN、RNN三个特征提取器:
1.每层的计算复杂度:
考虑到n个key和n个query两两点乘,因此self-attention每层计算复杂度为$O(n^2*d)$
考虑到矩阵(维度为$n*n$)和输入向量相乘,因此RNN每层计算复杂度为$O(n*d^2)$
对于k个卷积核经过n次一维卷积,因此CNN每层计算复杂度为$O(k*n*d^2)$,如果考虑深度可分离卷积,则计算复杂度下降为$O(k*n*d+n*d^2)$
因此:
当$n<d$时,self attention要比RNN和CNN快;
当$n>d$时,可以使用受限self attention,即:计算attention时仅考虑每个输出位置附近窗口的r个输入。这将带来两个效果:每层计算复杂度降为$O(r*n*d)$
最长学习距离降低为r,因此需要执行$O(n/r)$次才能覆盖到所有输入。
2.并行操作数量:
可以通过必须串行的操作数量来描述:
对于self-attention,CNN,其串行操作数量为O(1),并行度最大;
对于RNN,其串行操作数量为O(n),较难并行化。
3.最长计算路径:
覆盖所有输入的操作的数量
对于self-attention,最长计算路径为O(1);对于self-attention stricted,最长计算路径为O(n/r);
对于常规卷积,则需要O(n/k)个卷积才能覆盖所有的输入;对于空洞卷积,则需要$O(log_kn)$才能覆盖所有的输入;
对于RNN,最长计算路径为O(n)
4.作为额外收益,self-attention可以产生可解释性的模型:
通过检查模型中的注意力分布,可以展示与句子语法和语义结构相关的信息。
参考文献:
【1】BERT专题系列(二):Transformer (Attention is all you need)_哔哩哔哩 (゜-゜)つロ 干杯~-bilibili
【2】NLP学习(5)----attention/ self-attention/ seq2seq/ transformer - Lee_yl - 博客园
Transformer模型---decoder的更多相关文章
- 文本分类实战(八)—— Transformer模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 详解Transformer模型(Atention is all you need)
1 概述 在介绍Transformer模型之前,先来回顾Encoder-Decoder中的Attention.其实质上就是Encoder中隐层输出的加权和,公式如下: 将Attention机制从Enc ...
- transformer模型解读
最近在关注谷歌发布关于BERT模型,它是以Transformer的双向编码器表示.顺便回顾了<Attention is all you need>这篇文章主要讲解Transformer编码 ...
- transformer模型简介
Transformer模型由<Attention is All You Need>提出,有一个完整的Encoder-Decoder框架,其主要由attention(注意力)机制构成.论文地 ...
- Transformer模型---encoder
一.简介 论文链接:<Attention is all you need> 由google团队在2017年发表于NIPS,Transformer 是一种新的.基于 attention 机制 ...
- Transformer模型总结
Transformer改进了RNN最被人诟病的训练慢的缺点,利用self-attention机制实现快速并行. 它是由编码组件.解码组件和它们之间的连接组成. 编码组件部分由一堆编码器(6个 enco ...
- NLP与深度学习(四)Transformer模型
1. Transformer模型 在Attention机制被提出后的第3年,2017年又有一篇影响力巨大的论文由Google提出,它就是著名的Attention Is All You Need[1]. ...
- Transformer模型详解
2013年----word Embedding 2017年----Transformer 2018年----ELMo.Transformer-decoder.GPT-1.BERT 2019年----T ...
- RealFormer: 残差式 Attention 层的Transformer 模型
原创作者 | 疯狂的Max 01 背景及动机 Transformer是目前NLP预训练模型的基础模型框架,对Transformer模型结构的改进是当前NLP领域主流的研究方向. Transformer ...
随机推荐
- scrapy 爬取视频
利用FilesPipeline 下载视频 1.setting.py # 保存log信息的文件名 LOG_LEVEL = "INFO" # LOG_STDOUT = True # L ...
- Monkey小白入门篇
一.monkey简介 中文名:猴子 职业:压力测试小工具 用途:对待测Android应用程序进行压力测试,测试app是否会crash Android官方描述: The Monkey is a prog ...
- python将xml文件数据增强(labelimg)
在处理faster-rcnn和yolo时笔者使用labelimg标注图片 但是我们只截取了大概800张左右的图,这个量级在训练时肯定是不够的,所以我们需要使用数据增强(无非是旋转加噪调量度)来增加我们 ...
- postman(十二):发送携带md5签名、随机数等参数的请求
想起来之前在借助百度翻译接口做翻译小工具的时候,需要把参数进行md5加密后再传输. 而在平时的接口测试工作中难免会遇到类似这种请求参数,比如md5加密.时间戳.随机数等等.固然可以先计算出准确的参数, ...
- 消息队列的使用<二>:ActiveMQ的基本使用(Java)
目录 ActiveMQ 介绍 下载.安装和初次运行 Java上初次使用activeMQ 设置请求属性: 可靠性机制 事务 消息消费方式 receive 监听器: 消息类型 发布/订阅模式 非持久订阅 ...
- 【解决错误】Non-reversible reg-exp portion: '(?i'
在将Django升级到2.1后,运行 Django 自带后台后,或 使用 redirect 方法,就一直报错:Non-reversible reg-exp portion: '(?i'. 错误一 Dj ...
- matplotlib动态绘图
目录 package Process 解决中文乱码问题 simple_plot() scatter_plot() three_dimension_scatter() Jupyter notebook ...
- python中count和index
str = [1,2,3,4,5] #定义一个列表 str = 3 #列表3 str [1, 2, 3, 4, 5, 1, 2, 3, 4, 5, 1, 2, 3, 4, 5] str.count(1 ...
- Python连载23-file_analysis
一.文件 1.定义:长久保存信息的一种信息集合 2.常用操作:(1)打开关闭(2)读写内容(3)查找 3.open函数 (1)意义:打开文件,带有很多参数 (2)第一个参数:必须有,文件的路径和名称 ...
- SQL Server 判断各种对象是否存在和sysobjects的关系
一.判断表是否存在 object_id():获取表的ID,其中N表示Unicode类型.可以支持不同语种的对象名 ) drop table [dbo].[表名] 二.判断要创建的存储过程名是否存在 ) ...