
machine learning (2)-linear regression with one variable
machine learning- linear regression with one variable(2)
- Linear regression with one variable = univariate linear regression: 由一个输入变量预测出一个output (regression problem预测连续的值). single input<--->single output
- training set: 机器进行学习的元素集

- univariate linear regression = Linear regression with one variable
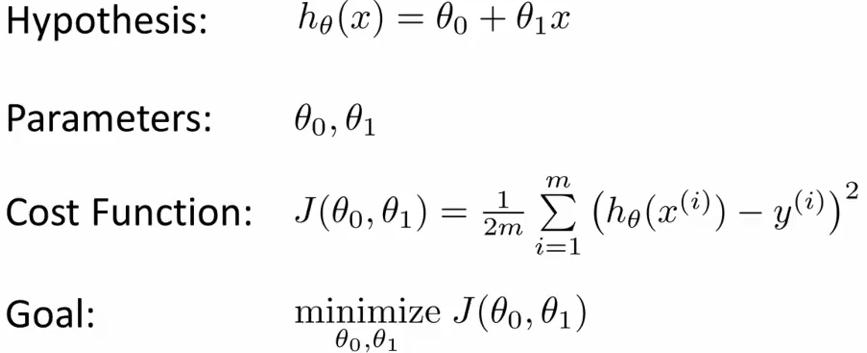
The Hypothesis Function(for linear regression):
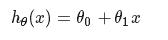 ,这是一个关于x的函数(θ0与θ1是固定的).这是一个假设的函数(求出假设的 θ0 和 θ1,这个是我们的目标,愈近的接近真实的y值),这样可以根据input value(x)来计算output value(y)
Cost Function(for linear regression):
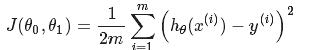 (y为真实的值),这是一个关于θ1与θ2(parameters)的函数,用来衡量假设函数(hypothesis function)的准确性,目的是选择使cost function最小的θ1与θ2的值,这样就能确定假设函数(Hypothesis Function)了.
- 图片
- 图片
- Squared error function = cost function
- Mean squared error = cost function
Gradient Descent: 一种用来自动提高hypothesis function准确性的方法,使cost function取最小值(不仅适用于linear regression,可用于整个机器学习).
图片
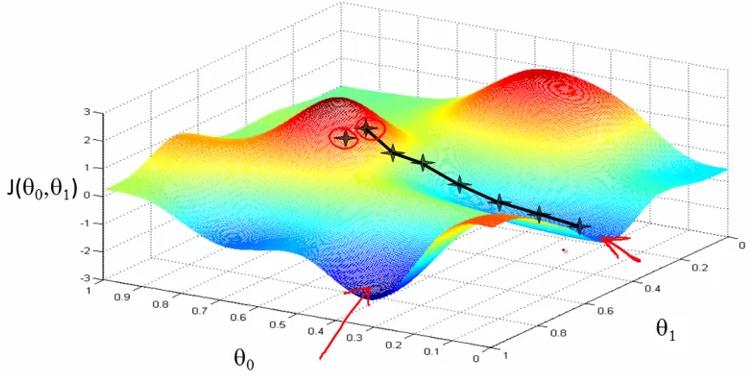 (非cost function for linear regression,一般情况下的J(θ0,θ1))
- 由上图可知,不同的初始值,利用gradient descent可能得出不同的局部最优解(有不同的极小值)
大概方法步骤:
function: J(θ0,θ1)
目标: 求出J(θ0,θ1)的最小值
- 先预设 θ0,θ1的值
- 利用gradient descent反复求θ0,θ1的值
- 直至θ0,θ1的值收敛于一个确定的值(J(θ0,θ1)的极小值),(收敛是因为当到达极值时,cost function的偏导为0,这时会收敛)
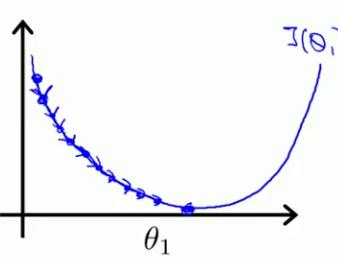
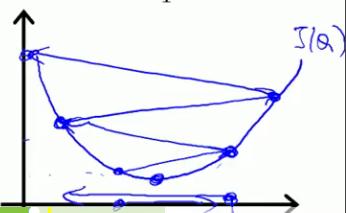
- learning rate: ∂(大于0),朝着cost function的梯度方向以a(learning rate)系数倍数逼近cost function(θ0,θ1为参数)的最小值。
- learning rate太小:使求出收敛的值时迭代的次数变多,使收敛过程变慢(下图是假设θ0已知,θ1未知时的cost function图形,若都未知则图应是立体的,如上图)
- learning rate太大:可能会导致无法收敛,得不到正确的值(下图是假设θ0已知,θ1未知时的cost function图形,若都未知则图应是立体的,如上图)
- The gradient descent equation:
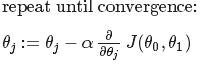 (j=0,1)
- :=为赋值操作,=为truth assertion操作
- 要同时更新θ0,θ1的值(update simultaneously),即算出θ0的新值后,不能利用这个新值的J(θ0,θ1)去算θ1,而是同时更新θ0,θ1
- 求的是局部最优解(即cost function的极小值,但是不是最小值)
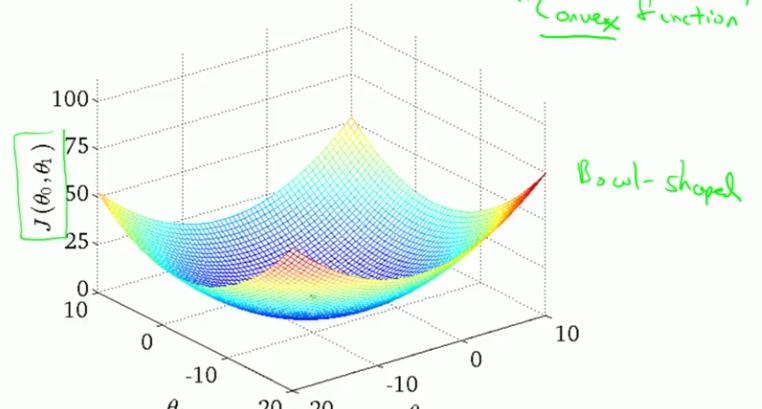
- 但是由cost function for linear regression的图(像一个碗状)可知,它只有一个极小值(也是它的最小值),所以对于linear regression问题,gradient descent求的是cost function的最小值
Gradient Descent for Linear Regression:
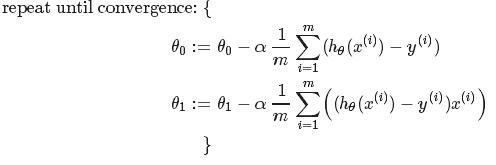 (是将h(x)=θ0+θ1x和J(θ0,θ1)代入求导求得)
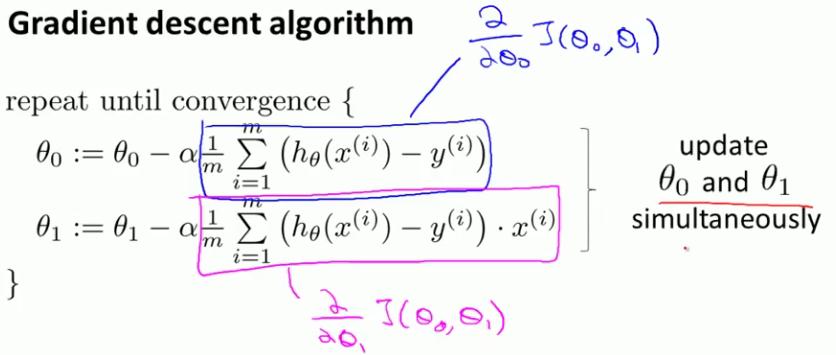
- cost function for linear regression由它的图(上图)可知,它没有局部极小值,只有一个全局最小值。所以用gradient descent求出的是使cost function取最小值的θ0,θ1
- "batch" gradient descent = gradient descent algorithm,因为在计算θ0,θ1时是利用了所有的trainning set,帮称为batch
machine learning (2)-linear regression with one variable的更多相关文章
- Machine Learning #Lab1# Linear Regression
Machine Learning Lab1 打算把Andrew Ng教授的#Machine Learning#相关的6个实验一一实现了贴出来- 预计时间长度战线会拉的比較长(毕竟JOS的7级浮屠还没搞 ...
- CheeseZH: Stanford University: Machine Learning Ex1:Linear Regression
(1) How to comput the Cost function in Univirate/Multivariate Linear Regression; (2) How to comput t ...
- 【Coursera - machine learning】 Linear regression with one variable-quiz
Question 1 Consider the problem of predicting how well a student does in her second year of college/ ...
- Machine learning(2-Linear regression with one variable )
1.Model representation Our Training Set [训练集]: We will start with this ''Housing price prediction'' ...
- Machine Learning 学习笔记2 - linear regression with one variable(单变量线性回归)
一.Model representation(模型表示) 1.1 训练集 由训练样例(training example)组成的集合就是训练集(training set), 如下图所示, 其中(x,y) ...
- [Machine Learning] 单变量线性回归(Linear Regression with One Variable) - 线性回归-代价函数-梯度下降法-学习率
单变量线性回归(Linear Regression with One Variable) 什么是线性回归?线性回归是利用数理统计中回归分析,来确定两种或两种以上变量间相互依赖的定量关系的一种统计分析方 ...
- Stanford机器学习---第二讲. 多变量线性回归 Linear Regression with multiple variable
原文:http://blog.csdn.net/abcjennifer/article/details/7700772 本栏目(Machine learning)包括单参数的线性回归.多参数的线性回归 ...
- Stanford机器学习---第一讲. Linear Regression with one variable
原文:http://blog.csdn.net/abcjennifer/article/details/7691571 本栏目(Machine learning)包括单参数的线性回归.多参数的线性回归 ...
- 机器学习 (一) 单变量线性回归 Linear Regression with One Variable
文章内容均来自斯坦福大学的Andrew Ng教授讲解的Machine Learning课程,本文是针对该课程的个人学习笔记,如有疏漏,请以原课程所讲述内容为准.感谢博主Rachel Zhang的个人笔 ...
随机推荐
- Mongodb CPU占用率达90%的优化调整报告
1问题描述 1.1现场的数据库部署情况 服务器基本情况如下: CPU 20逻辑核,40线程 内存 64 G 硬盘 D盘 :1T SSD E盘:3T SATA F盘:3T SATA 在这台机器上同时部署 ...
- 逸鹏说道公众号福利:逆天常用的一些谷歌浏览器插件V1.3
插件导出:http://www.cnblogs.com/dunitian/p/5426552.html 插件导入:https://www.cnblogs.com/dotnetcrazy/p/97537 ...
- Appium UiWatchers 监听解决各种非期待弹窗,弹层,弹弹弹等问题
app自动化时,各种不期待的弹层弹窗,升级广告等时有飞出,由于弹窗具有不定时,不定页面等很多不确定性.有的弹窗很不友好,不×掉,很难进行下一步操作,造成 测试用例失败.而判断是否有弹窗,弹层很麻烦.研 ...
- CF1260D A Game with Traps
http://codeforces.com/problemset/problem/1260/D 首先很明显可以想到二分答案,把能力值数组排个序就好. 考虑怎么check. 设当前二分值为w,即不能直接 ...
- 14 SpringMVC框架的基本概念
1.三层架构 我们的开发架构一般都是基于两种形式,一种是 C/S 架构,也就是客户端/服务器,另一种是 B/S 架构,也就是浏览器服务器.在 JavaEE 开发中,几乎全都是基于 B/S 架构的开发. ...
- c++快速排序原理及优化
快速排序 快速排序的时间复杂度为O(logn) 注意:快速排序主要是标志数的选取,如果所选的数恰好为最小或者最大,则是最糟糕的情况,即一轮下来数据没有发生变化! 如何选取中间的标志数成为了算法的关键. ...
- mysql中数据表记录的增删查改(2)
select `数据表.字段1`, group_concat(`数据表.字段2`) from `数据表` group by `数据表.字段1` order by `数据表.字段1` desc; sel ...
- 5. JDBC/ODBC服务器
Spark SQL也提供JDBC连接支持,这对于让商业智能(BI)工具连接到Spark集群上以及在多用户间共享一个集群的场景都非常有用.JDBC服务器作为一个独立的Spark驱动器程序运行,可以在多用 ...
- 最简单的centos上安装Nginx办法
基本几个简单命令就能搞定 由于yum源中没有我们想要的nginx,那么我们就需要创建一个“/etc/yum.repos.d/nginx.repo”的文件,其实就是新增一个yum源. vi /etc/y ...
- 斐波那契数列(递归)c#
我郑重宣布 我爱递归 我自己编程几乎都没用过递归 我看到这个题的时候虽然想到了用递归 但是我个脑残一直在想怎么设置动态数组 明明纯递归更简单 我也是可无语 反正我爱上递归了 爱惹 无法自拔