
GJM : Python简单爬虫入门 (一) [转载]
| 版权声明:本文原创发表于 【请点击连接前往】 ,未经作者同意必须保留此段声明!如有侵权请联系我删帖处理! |
为大家介绍一个简单的爬虫工具BeautifulSoup
BeautifulSoup拥有强大的解析网页及查找元素的功能本次测试环境为python3.4(由于python2.7编码格式问题)
此工具在搜索你想爬的数据匹配的方式就是html标签嵌套的顺序(html介绍在其它随笔内)
首先来聊聊BeautifulSoup的安装pip install python-bs4 包含BeautifulSoup方法
再来安装依赖工具requests和解析格式lxml下载安装包 解压进入目录 python setup.py install此方法是请求服务
先来写一个简单的网页解析代码如下:

#!/usr/bin/env python
# -*- coding:utf-8 -*-

from bs4 import BeautifulSoup
import requests

headers = {
    'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/45.0.2454.101 Safari/537.36',
}
url = "http://www.jd.com/"

wb_data = requests.get(url,headers=headers)
soup = BeautifulSoup(wb_data.text,'lxml')
print(soup)
来简单说明下每行代码得作用:
from从bs4库里import导入BeautifulSoup方法
import导入requests方法
headers表示头文件,伪装成浏览器浏览网页,当然我这里写得简单还没写全
url网页地址
wb_data网页数据requests.get请求访问(url网页京东,headers伪装的头文件)
soup解析后的数据BeautifulSoup解析数据(wb_data网页数据,lxml解析的格式按这个要求解析)
print答应soup解析后的网页数据 也就是网页源代码如下 由于网页源代码很长所以这里截图只能显示一部分
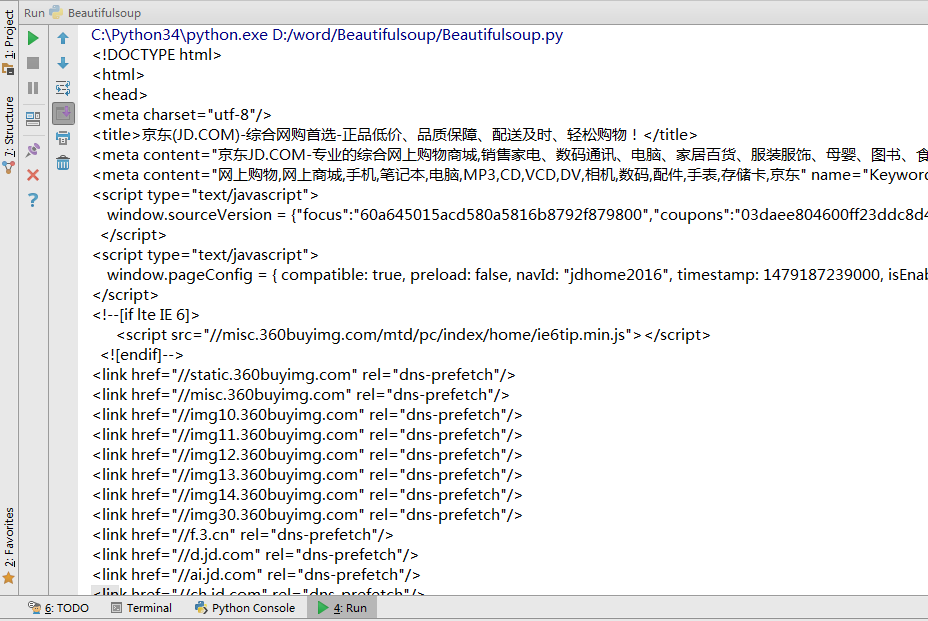
学好基础包括html的结构标签的嵌套还有CSS的名字在网页位置等后教你们怎么去抓电影等网站并且把内容归类好方便查阅
下面是我抓去某电影网站的数据及归类效果掩饰:

GJM : Python简单爬虫入门 (一) [转载]的更多相关文章
- GJM : Python简单爬虫入门(二) [转载]
感谢您的阅读.喜欢的.有用的就请大哥大嫂们高抬贵手"推荐一下"吧!你的精神支持是博主强大的写作动力以及转载收藏动力.欢迎转载! 版权声明:本文原创发表于 [请点击连接前往] ,未经 ...
- Python简单爬虫入门三
我们继续研究BeautifulSoup分类打印输出 Python简单爬虫入门一 Python简单爬虫入门二 前两部主要讲述我们如何用BeautifulSoup怎去抓取网页信息以及获取相应的图片标题等信 ...
- Python简单爬虫入门二
接着上一次爬虫我们继续研究BeautifulSoup Python简单爬虫入门一 上一次我们爬虫我们已经成功的爬下了网页的源代码,那么这一次我们将继续来写怎么抓去具体想要的元素 首先回顾以下我们Bea ...
- Python简单爬虫入门一
为大家介绍一个简单的爬虫工具BeautifulSoup BeautifulSoup拥有强大的解析网页及查找元素的功能本次测试环境为python3.4(由于python2.7编码格式问题) 此工具在搜索 ...
- python网络爬虫入门范例
python网络爬虫入门范例 Windows用户建议安装anaconda,因为有些套件难以安装. 安装使用pip install * 找出所有含有特定标签的HTML元素 找出含有特定CSS属性的元素 ...
- Python 简单爬虫案例
Python 简单爬虫案例 import requests url = "https://www.sogou.com/web" # 封装参数 wd = input('enter a ...
- Python简单爬虫记录
为了避免自己忘了Python的爬虫相关知识和流程,下面简单的记录一下爬虫的基本要求和编程问题!! 简单了解了一下,爬虫的方法很多,我简单的使用了已经做好的库requests来获取网页信息和Beauti ...
- python网络爬虫入门(二)
刚去看了一下,18年2月份写了第一篇关于爬虫的文章(仅仅介绍了使用requests库去获取HTML代码),一年多之后看来很稚嫩也没有多少参考的意义,但没想着要去修改它,留着也是一个回忆吧.至少证明着我 ...
- Python简单爬虫
爬虫简介 自动抓取互联网信息的程序 从一个词条的URL访问到所有相关词条的URL,并提取出有价值的数据 价值:互联网的数据为我所用 简单爬虫架构 实现爬虫,需要从以下几个方面考虑 爬虫调度端:启动爬虫 ...
随机推荐
- SQL Server排序函数row_number和rank的区别
SQL Server排序函数row_number和rank的区别 直接看测试结果 declare @table table(name varchar(100),amount int, memo var ...
- Python下划线与命名规范
Python下划线与命名规范 先看结论,节省只想知道答案你的宝贵时间: _xxx 不能用于from module import * 以单下划线开头的表示的是protected类型的变量.即保护类型只能 ...
- 快速入门系列--MVC--05行为
Action执行包含内容比较多,主要有同步/异步Action的概念和执行过程,Authorationfilter, ActionFiltor, ResultFilter, ExceptionFilte ...
- PL/SQL异常处理
As we all known,程序的错误一般分为两类:编译错误和运行时错误.其中运行时错误被称为异常.PL/SQL语句块中处理异常的部分即为异常处理部分.在异常处理部分,可以指定当特定异常发生时所采 ...
- Debugging WebLogic Server Applications Using Eclipse and the WebLogic-Plugin
http://www.oracle.com/technetwork/cn/tutorials/eclipse-plugin-093411.html
- 精选12个时尚的 CSS3 效果【附源码下载】
这里是精选的12个很炫的 CSS3 效果.CSS3 是对 CSS 规范的一个很大的改善和增强,它使得 Web 开发人员可以很容易的在网站中加入时尚的效果.以前很多需要编写复杂的 JavaScript ...
- idea快捷键总结
使用好快捷键会快很多,这里我慢慢添加我用习惯的快捷键.参考 1.alt+enter 这个几乎万能,有错误提示的时候将光标移动到错误处,然后alt+enter,会给出建议方案:写完一个表达式后,alt+ ...
- oracle创建表相关
--创建表 create table person( id number primary key, name ), birth date ); --创建序列 create sequence perso ...
- C#多线程技术总结(同步)
二.串行(同步): 1.lock.Monitor--注意锁定的对象必需是引用类型(string类型除外) 示例: private static object syncObject = new obje ...
- Python科学计算包模块的安装(ubuntu)
Python的科学计算包设计到C语言代码的编译,采用pip的方式安装会出现错误. 一种简单的方式是采用的集成包,具体的步骤参考:https://www.continuum.io/downloads#_ ...