
【Kafka】《Kafka权威指南》——分区partition
在上篇的例子里(【Kafka】《Kafka权威指南》——写数据), ProducerRecord 对象包含了目标主题、键和值。 Kafka 的消息是 一个个 键值对, ProducerRecord对象可以只包含目标主题和值,键可以设置为默认的 null,不过大多数应用程序会用到键。键有两个用途 :可以作为消息的附加信息,也可以用来决定消息该被写到主题的哪个分区。拥有相同键的悄息将被写到同一个分区。 也就是说,如果一个进程只从一个主题的分区读取数据(第 4章会介绍更多细节),那么具有相 同键的所有记录都会被该进程读取。要创建一个包含键值的记录,只需像下面这样创建 ProducerRecord 对象: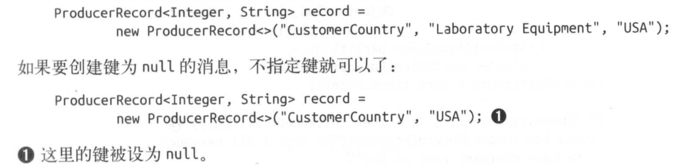
如果键值为 null, 井且使用了默认的分区器,那么记录将被随机地发送到主题内各个可用的分区上。分区器使用轮询(Round Robin)算法将消息均衡地分布到各个分区上。
如果键不为空,并且使用了默认的分区器,那么Kafka会对键进行散列(使用 Kafka 自己的散列算法,即使升级Java版本,散列值也不会发生变化),然后根据散列值把消息映射到特定的分区上。这里的关键之处在于 ,同一个键总是被映射到同一个分区上 ,所以在进 行映射时,我们会使用主题所有的分区,而不仅仅是可用的分区 。这也意味着,如果写入数据的分区是不可用的,那么就会发生错误。但这种情况很少发生。我们将在第 6章讨论 Kafka 的复制功能和可用性。
只有在不改变主题分区数量的情况下,键与分区之间的映射才能保持不变 。举个例子,在分区数量保持不变的情况下,可以保证用户 045189 的记录总是被写到分区 34。在从分区读取数据肘,可以进行各种优化。不过,一旦主题增加了新的分区,这些就无法保证 了——旧数据仍然留在分区 34,但新的记录可能被写到其他分区上 。 如果要使用键来映射分区,那么最好在创建主题的时候就把分区规划好,而且永远不要增加新分区。
实现自定义分区策略
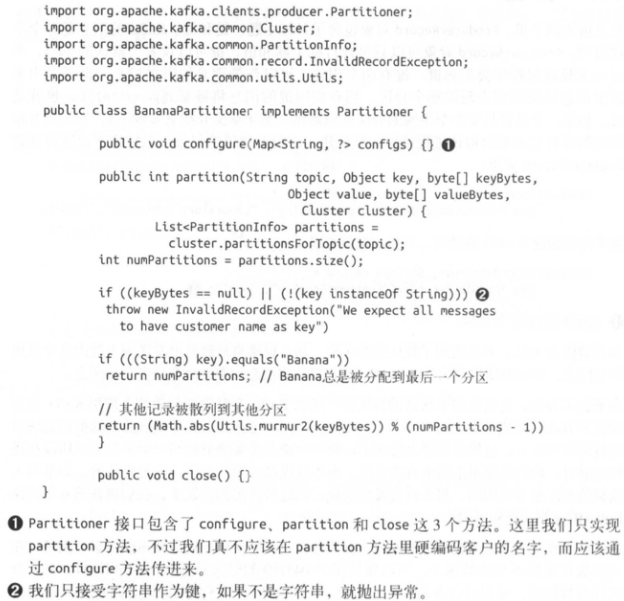
我们已经讨论了默认分区器的特点,它是使用次数最多的分区器。不过 ,除了散列分区之 外,有时候也需要对数据进行不一样的分区。假设你是一个 B2B 供应商,你有 一 个大客 户,它是手持设备 Banana 的制造商。 Banana 占据了你整体业务 10% 的份额。如果使用默 认的散列分区算怯, Banana 的账号记录将和其他账号记录一起被分配给相同的分区,导致 这个分区比其他分区要大一些。服务器可能因此出现存储空 间不足、处理缓慢等问题。我 们需要给 Banana 分配单独的分区,然后使用散列分区算住处理其他账号 。
下面是一个自定义分区器的例子 :
【Kafka】《Kafka权威指南》——分区partition的更多相关文章
- Kafka权威指南——broker的常用配置
前面章节中的例子,用来作为单个节点的服务器示例是足够的,但是如果想要把它应用到生产环境,就远远不够了.在Kafka中有很多参数可以控制它的运行和工作.大部分的选项都可以忽略直接使用默认值就好,遇到一些 ...
- 《Kafka权威指南》读书笔记-操作系统调优篇
<Kafka权威指南>读书笔记-操作系统调优篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 大部分Linux发行版默认的内核调优参数配置已经能够满足大多数应用程序的运 ...
- kafka的log存储解析——topic的分区partition分段segment以及索引等
转自:http://blog.csdn.net/jewes/article/details/42970799 引言 Kafka中的Message是以topic为基本单位组织的,不同的topic之间是相 ...
- kafka的log存储解析——topic的分区partition分段segment以及索引等(转发)
原文 https://www.cnblogs.com/dorothychai/p/6181058.html 引言 Kafka中的Message是以topic为基本单位组织的,不同的topic之间是相互 ...
- 【Kafka】《Kafka权威指南》入门
发布与订阅消息系统 在正式讨论Apache Kafka (以下简称Kafka)之前,先来了解发布与订阅消息系统的概念, 并认识这个系统的重要性.数据(消息)的发送者(发布者)不会直接把消息发送给接收 ...
- 【转】Spark Streaming和Kafka整合开发指南
基于Receivers的方法 这个方法使用了Receivers来接收数据.Receivers的实现使用到Kafka高层次的消费者API.对于所有的Receivers,接收到的数据将会保存在Spark ...
- Spark Streaming和Kafka整合开发指南(二)
在本博客的<Spark Streaming和Kafka整合开发指南(一)>文章中介绍了如何使用基于Receiver的方法使用Spark Streaming从Kafka中接收数据.本文将介绍 ...
- ELK+KAFKA安装部署指南
一.ELK 背景 通常,日志被分散的储存不同的设备上.如果你管理数十上百台服务器,你还在使用依次登录每台机器的传统方法查阅日志.这样是不是感觉很繁琐和效率低下.当务之急我们使用集中化的日志管理,例如: ...
- Kafka文件存储机制及partition和offset
转载自: https://yq.aliyun.com/ziliao/65771 参考: Kafka集群partition replication默认自动分配分析 如何为kafka选择合适的p ...
随机推荐
- Redis实现之字典跳跃表
跳跃表 跳跃表是一种有序数据结构,它通过在每个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的.跳跃表支持平均O(logN).最坏O(N)的时间复杂度查找,还可以通过顺序性操作来批量处理节 ...
- Python虚拟机类机制之填充tp_dict(二)
填充tp_dict 在Python虚拟机类机制之对象模型(一)这一章中,我们介绍了Python的内置类型type如果要完成到class对象的转变,有一个重要的步骤就是填充tp_dict对象,这是一个极 ...
- 可拖动jquery插件
http://www.open-open.com/ajax/DragDrop.htm http://sc.chinaz.com/info/130722592854.htm http://sc.itcn ...
- 【Luogu P1120】小木棍
题目: 乔治有一些同样长的小木棍,他把这些木棍随意砍成几段,直到每段的长都不超过$50$.现在,他想把小木棍拼接成原来的样子,但是却忘记了自己开始时有多少根木棍和它们的长度.给出每段小木棍的长度,编程 ...
- 实用拜占庭容错算法PBFT
实用拜占庭容错算法PBFT 实用拜占庭容错算法PBFT 96 乔延宏 2017.06.19 22:58* 字数 1699 阅读 4972评论 0喜欢 11 分布式架构遭遇的问题 分布式架构会遭遇到以下 ...
- DataFrame的iloc与loc的区别是什么?
对于一个DataFrame A,A.loc[k]是读取A中index为k的那一行.A.iloc[k]是读取A中的第k行.
- 获取完整的URL request.getQueryString()
public String codeToString(String str) { String strString = str; try { byte tempB[] = strString.getB ...
- web常见攻击总结
1.Sql注入 攻击者把sql命令插入到web表单的输入域或页面请求的查询字符串, 欺骗服务器执行恶意的sql命令 防御措施 前端: 1.正则验证字符串格式 2.过滤字符串的非法字符 后端: 1.不要 ...
- git下载其他人分支的代码
1. 在工作空间,右键,打开Git Bash 2. clone主分支的代码(即下载主分支代码的过程) 执行命令: git clone xxx.git 3. 进入工程目录 cd xxx 4. 切换到 ...
- 理解exports
webpack-nodejs-模块系统 其实,Module.exports才是真正的接口,exports只不过是它的一个辅助工具. 最终返回给调用的是Module.exports而不是exports. ...