
轻量级ORM框架——第二篇:Dapper中的一些复杂操作和inner join应该注意的坑
上一篇博文中我们快速的介绍了dapper的一些基本CURD操作,也是我们manipulate db不可或缺的最小单元,这一篇我们介绍下相对复杂
一点的操作,源码分析暂时就不在这里介绍了。
一:table sql
为了方便,这里我们生成两个表,一个Users,一个Product,sql如下:
<1> Users table
CREATE TABLE [dbo].[Users](

    [UserID] [int] IDENTITY(1,1) NOT NULL,

    [UserName] [varchar](50) NULL,

    [Email] [varchar](100) NULL,

    [Address] [varchar](100) NULL,

 CONSTRAINT [PK_Users] PRIMARY KEY CLUSTERED

(

    [UserID] ASC

)WITH (PAD_INDEX  = OFF, STATISTICS_NORECOMPUTE  = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS  = ON, ALLOW_PAGE_LOCKS  = ON) ON [PRIMARY]

) ON [PRIMARY]
<2> Product table
CREATE TABLE [dbo].[Product](

    [ProductID] [int] IDENTITY(1,1) NOT NULL,

    [ProductName] [varchar](220) NULL,

    [ProductDesc] [varchar](220) NULL,

    [UserID] [int] NULL,

    [CreateTime] [datetime] NULL,

 CONSTRAINT [PK_Product] PRIMARY KEY CLUSTERED

(

    [ProductID] ASC

)WITH (PAD_INDEX  = OFF, STATISTICS_NORECOMPUTE  = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS  = ON, ALLOW_PAGE_LOCKS  = ON) ON [PRIMARY]

) ON [PRIMARY]
二:in操作
很多时候我们在manipulate table的时候,或多或少的都会用到 ”in关键字”,比如:我要找到User表中Email in ('5qq.com','8qq.com')的
Users record。。。
 static void Main(string[] args)

        {

            var connection = new SqlConnection("Data Source=.;Initial Catalog=Datamip;Integrated Security=True;MultipleActiveResultSets=True");

            var sql = "select * from Users where Email in @emails";

            var info = connection.Query<Users>(sql, new { emails = new string[] { "5qq.com", "7qq.com" } });

        }
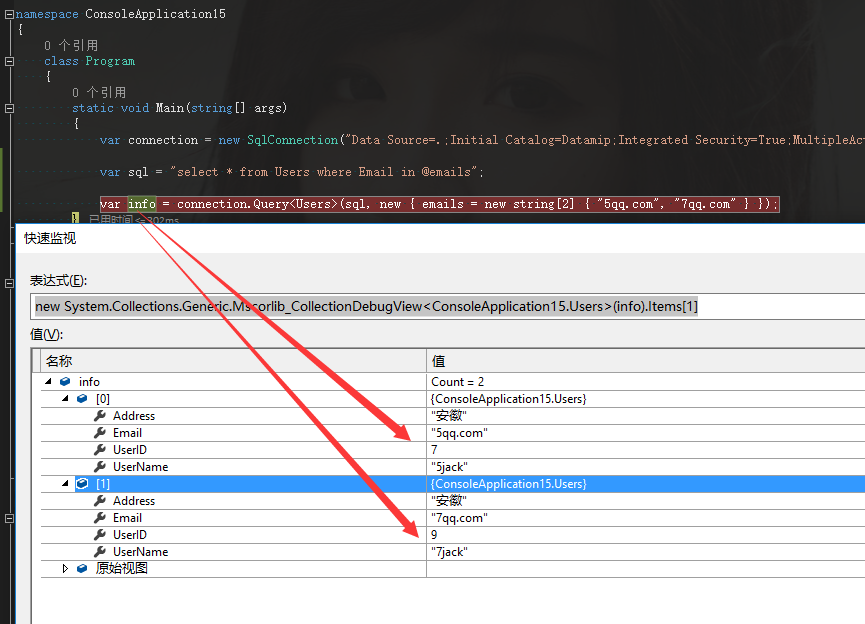
看了上面的操作,是不是很简单,只要我们的参数类型是Array的时候,dappper会自动将其转化。。。
三:多条sql一起执行
有时候我们会想在一条sql中灌入很多的snippet sql,然后让其一起执行,此时让我想起了一个操作,我会在db中load data的时候会写到
select ... from marketing where id in (....); select .... from eventmarketing where in (...)类似这样的语句,然后进行结果合并,这篇
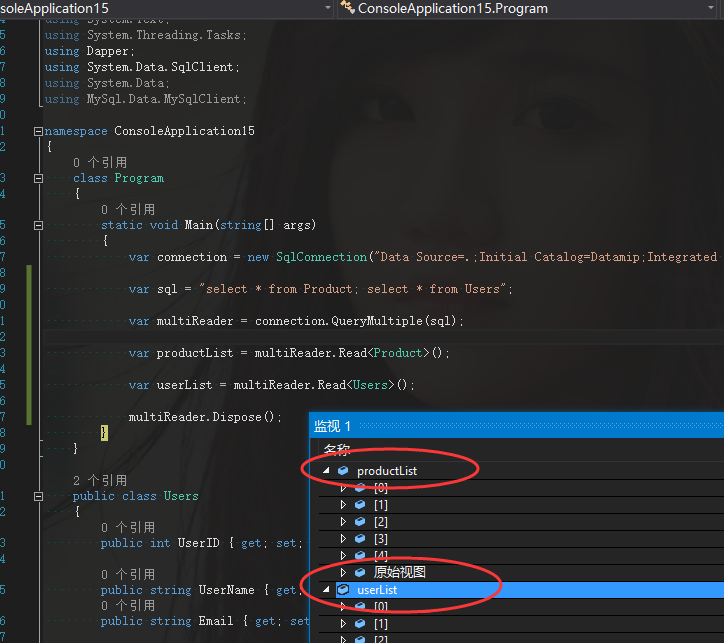
为了方便演示,在User上做一个*操作,在Product上做一个* 操作,比如下面这样:
 static void Main(string[] args)

        {

            var connection = new SqlConnection("Data Source=.;Initial Catalog=Datamip;Integrated Security=True;MultipleActiveResultSets=True");

            var sql = "select * from Product; select * from Users";

            var multiReader = connection.QueryMultiple(sql);

            var productList = multiReader.Read<Product>();

            var userList = multiReader.Read<Users>();

            multiReader.Dispose();

        }
四:多表join操作
不管sql写的多么好或者多么烂,接触一个月还是接触到十年,都必然跑不了多表查询,那么在多表查询上dapper该如何使用呢???比如
说我要找到2015-12-12之后的商品信息和个人信息,很显然这是一个多表查询,可以先来看一下users和product的关系。

可以发现其实他们有一个外键关系,然后我们在Product Entity上做一下小修改,将Users作为Product的一个entity property。。。
   public class Product

    {

        public int ProductID { get; set; }

        public string ProductName { get; set; }

        public string ProductDesc { get; set; }

        public Users UserOwner { get; set; }

        public string CreateTime { get; set; }

    }
有了这些储备,我们大概就可以写出如下的sql。
 static void Main(string[] args)

        {

            var connection = new SqlConnection("Data Source=.;Initial Catalog=Datamip;Integrated Security=True;MultipleActiveResultSets=True");

            var sql = @"select  p.ProductName,p.CreateTime,u.UserName

                        from Product as p

                        join Users as u

                        on p.UserID = u.UserID

                        where p.CreateTime > '2015-12-12'; ";

            var result = connection.Query<Product, Users, Product>(sql,

                                    (product, users) =>

                                    {

                                        product.UserOwner = users; return product;

                                    });

        }
结果就是”操!!!!“。。。。。。。。。。。。

从错误信息中可以看到:当你使用multi-mapping的时候要确保设置了splitOn参数,除了Id。。。从这句话中好像也看不出什么名堂,也就是说
除了Id,你都需要设置SplitOn参数,好吧,这是逼着哥哥看源代码。。。。看看SplitOn到底是个什么样的鸟玩法。。。然后我从Call Stack往上
面找,发现了非常”至关重要“的一段话。

然来splitOn就是Dapper对DataReader进行”从右到左“的扫描,这样就可以从sequent中获取到一个subsequent,然后遇到设置的splitOn
就停止。。。然来是这样,哈哈。。。这回我就知道了,将splitOn设置为”userName“就好了。。。比如下面这样。。。
   static void Main(string[] args)

        {

            var connection = new SqlConnection("Data Source=.;Initial Catalog=Datamip;Integrated Security=True;MultipleActiveResultSets=True");

            var sql = @"select  p.ProductName,p.CreateTime,u.UserName

                        from Product as p

                        join Users as u

                        on p.UserID = u.UserID

                        where p.CreateTime > '2015-12-12'; ";

            var result = connection.Query<Product, Users, Product>(sql,

                                    (product, users) =>

                                    {

                                        product.UserOwner = users; return product;

                                    },splitOn: "UserName");

        }

当然如果你觉得我上面说的太啰嗦了,注意事项还tmd的多,又是泛型,又是Lambda的。。。你也可以不指定这些具体Type,而默认使用
dynamic也是可以的,比如下面这样:

五:支持存储过程
对于存储过程,也是一个不得不说的话题,我们的dapper同样也是可以执行的,只需要在Query中的CommandType中标记一下当前就是一个
StoredProcedure就八九不离十了,比如现在在Users表上创建一个简单的StoredProcedure。
USE [Datamip]

GO

/****** Object:  StoredProcedure [dbo].[sp_GetUsers]    Script Date: 09/02/2016 09:14:04 ******/

SET ANSI_NULLS ON

GO

SET QUOTED_IDENTIFIER ON

GO

Create proc [dbo].[sp_GetUsers]

 @id int

as

begin

select * from Users where UserID = @id ;

end
在这里,我们需要向存储过程塞入一个@id参数,返回具体的Users EntityList,好了,下面再看一下Query如何构造。
  static void Main(string[] args)

        {

            var connection = new SqlConnection("Data Source=.;Initial Catalog=Datamip;Integrated Security=True;MultipleActiveResultSets=True");

            var info = connection.Query<Users>("sp_GetUsers", new { id =  },

                                   commandType: CommandType.StoredProcedure);

        }

搞定,感觉用Dapper是不是就这么简单,先就说到这里,希望对大家有帮助。
轻量级ORM框架——第二篇:Dapper中的一些复杂操作和inner join应该注意的坑的更多相关文章
- 轻量级ORM框架:Dapper中的一些复杂操作和inner join应该注意的坑
上一篇博文中我们快速的介绍了dapper的一些基本CURD操作,也是我们manipulate db不可或缺的最小单元,这一篇我们介绍下相对复杂 一点的操作,源码分析暂时就不在这里介绍了. 一:tabl ...
- 轻量级ORM框架——第一篇:Dapper快速学习
我们都知道ORM全称叫做Object Relationship Mapper,也就是可以用object来map我们的db,而且市面上的orm框架有很多,其中有一个框架 叫做dapper,而且被称为th ...
- 分享自己写的基于Dapper的轻量级ORM框架~
1.说明 本项目是一个使用.NET Standard 2.0开发的,基于 Dapper 的轻量级 ORM 框架,包含基本的CRUD以及根据表达式进行一些操作的方法,目前只针对单表,不包含多表连接操作. ...
- C# 性能优化 之 秒表 Stopwatch。 Dapper一个和petapoco差不多的轻量级ORM框架
Sweet小马 小马同学的编程日记. C# 性能优化 之 秒表 Stopwatch. 生词解释:Diagnostics[,daɪəg'nɑstɪks] n.诊断学 using System.Diagn ...
- .NET轻量级ORM框架Dapper入门精通
一.课程介绍 本次分享课程包含两个部分<.NET轻量级ORM框架Dapper修炼手册>和<.NET轻量级ORM框架Dapper葵花宝典>,阿笨将带领大家一起领略轻量级ORM框架 ...
- 轻量级ORM框架Dapper应用一:Dapper安装
一.Dapper简介 Dapper是一款轻量级ORM框架,为解决网站访问流量极高而产生的性能问题而构造,主要通过执行TSQL表达式而实现数据库的CQRS. 如果你在项目中遇到性能访问问题,选择Dapp ...
- Farseer.net轻量级开源框架 中级篇:探究ORM(Mapping)
导航 目 录:Farseer.net轻量级开源框架 目录 上一篇:Farseer.net轻量级开源框架 中级篇: SQL执行报告 下一篇:Farseer.net轻量级开源框架 中级篇: Cooki ...
- 轻量级ORM框架初探-Dapper与PetaPoco的基本使用
一.EntityFramework EF是传统的ORM框架,也是一个比较重量级的ORM框架.这里仍然使用EF的原因在于为了突出轻量级ORM框架的性能,所谓有对比才有更优的选择. 1.1 准备一张数据库 ...
- Farseer.net轻量级开源框架 中级篇:UrlRewriter 地址重写
导航 目 录:Farseer.net轻量级开源框架 目录 上一篇:Farseer.net轻量级开源框架 中级篇: Cookies.Session.Request 下一篇:Farseer.net轻量 ...
随机推荐
- Entity Framework 6 Recipes 2nd Edition(13-6)译 -> 自动编译的LINQ查询
问题 你想为多次用到的查询提高性能,而且你不想添加额外的编码或配置. 解决方案 假设你有如Figure 13-8 所示的模型 Figure 13-8. A model with an Associat ...
- ubuntu 启动MySql和安装python的MySQLdb模块
ubuntu一般会自己预安装mysql,你只需 /etc/init.d/mysql start|stop|restart|reload|force-reload|status 命令便可以实现mysq ...
- Retrofit2.0起步篇
retrofit 英文名字是改装的意思,也就是说他是对网络请求的一种改装,他不负责进行网络请求,他是对请求方式的一种封装.真正进行网络请求的是okhttp. 以下所有内容在Android Studio ...
- rsync 笔记之 list
通过 rsync --list-only 可以列出可用的 文件/目录或者 module 下面两者的含义是完全不同的: rsync --list-only root@192.168.4.140: 使用系 ...
- Electron中Jquery的引入方式
原文链接http://huisky.com/blog/16122220522957 Electron默认启用了Node.js的require模块,而jQuery等新版本框架为了支持commondJS标 ...
- SQLite的基本使用
SQLite 创建表 SQLite 的 CREATE TABLE 语句用于在任何给定的数据库创建一个新表.创建基本表,涉及到命名表.定义列及每一列的数据类型. 语法 CREATE TABLE 语句的基 ...
- LLBL Gen Pro 5.0 企业应用开发入门
Solutions Design 公司于2016年5月发布了LLBL Gen Pro 5.0,这个新版本的发布出乎于我的意料.我的猜想是从4.2升级到4.5,再升级5.x版本,主版本号的变更会给原有客 ...
- 前端学HTTP之URL
× 目录 [1]URI [2]URL语法 [3]字符[4]编码方法 前面的话 一般地,URL和URI比较难以区分.接下来,本文以区分URL和URI为引子,详细介绍URL的用法 URI与URL的区别 U ...
- 安卓Design之NavigationView的使用
前面讲解了Design包下的TabLayout的使用,下面将带来NavagationView和DrawLayout以及toolbar的联动. 项目已经同步至:https://github.com/na ...
- 网页或微信小程序中使元素占满整个屏幕高度
在项目中经常要用到一个容器元素占满屏幕高度和宽度,然后再在这个容器元素里放置其他元素. 宽度很简单就是width:100% 但是高度呢,我们知道的是height:100%必须是在父元素的高度给定了的情 ...