
Python爬虫从入门到放弃(十二)之 Scrapy框架的架构和原理
这一篇文章主要是为了对scrapy框架的工作流程以及各个组件功能的介绍
Scrapy目前已经可以很好的在python3上运行
Scrapy使用了Twisted作为框架,Twisted有些特殊的地方是它是事件驱动的,并且比较适合异步的代码。对于会阻塞线程的操作包含访问文件、数据库或者Web、产生新的进程并需要处理新进程的输出(如运行shell命令)、执行系统层次操作的代码(如等待系统队列),Twisted提供了允许执行上面的操作但不会阻塞代码执行的方法。
Scrapy data flow(流程图)
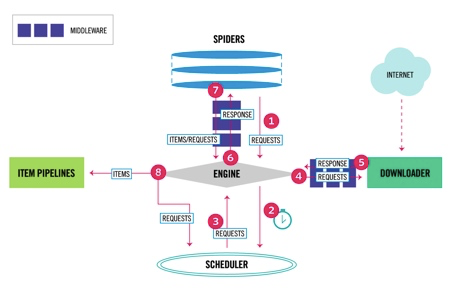
Scrapy数据流是由执行的核心引擎(engine)控制,流程是这样的:
1、爬虫引擎ENGINE获得初始请求开始抓取。
2、爬虫引擎ENGINE开始请求调度程序SCHEDULER,并准备对下一次的请求进行抓取。
3、爬虫调度器返回下一个请求给爬虫引擎。
4、引擎请求发送到下载器DOWNLOADER,通过下载中间件下载网络数据。
5、一旦下载器完成页面下载,将下载结果返回给爬虫引擎ENGINE。
6、爬虫引擎ENGINE将下载器DOWNLOADER的响应通过中间件MIDDLEWARES返回给爬虫SPIDERS进行处理。
7、爬虫SPIDERS处理响应,并通过中间件MIDDLEWARES返回处理后的items,以及新的请求给引擎。
8、引擎发送处理后的items到项目管道,然后把处理结果返回给调度器SCHEDULER,调度器计划处理下一个请求抓取。
9、重复该过程(继续步骤1),直到爬取完所有的url请求。
各个组件介绍
爬虫引擎(ENGINE)
爬虫引擎负责控制各个组件之间的数据流,当某些操作触发事件后都是通过engine来处理。
调度器(SCHEDULER)
调度接收来engine的请求并将请求放入队列中,并通过事件返回给engine。
下载器(DOWNLOADER)
通过engine请求下载网络数据并将结果响应给engine。
Spider
Spider发出请求,并处理engine返回给它下载器响应数据,以items和规则内的数据请求(urls)返回给engine。
管道项目(item pipeline)
负责处理engine返回spider解析后的数据,并且将数据持久化,例如将数据存入数据库或者文件。
下载中间件
下载中间件是engine和下载器交互组件,以钩子(插件)的形式存在,可以代替接收请求、处理数据的下载以及将结果响应给engine。
spider中间件
spider中间件是engine和spider之间的交互组件,以钩子(插件)的形式存在,可以代替处理response以及返回给engine items及新的请求集。
如何创建Scrapy项目
创建Scrapy项目
创建scrapy项目的命令是scrapy startproject 项目名,创建一个爬虫
进入到项目目录scrapy genspider 爬虫名字 爬虫的域名,例子如下:
zhaofandeMBP:python_project zhaofan$ scrapy startproject test1

New Scrapy project 'test1', using template directory '/Library/Frameworks/Python.framework/Versions/3.5/lib/python3.5/site-packages/scrapy/templates/project', created in:

    /Users/zhaofan/Documents/python_project/test1

You can start your first spider with:

    cd test1

    scrapy genspider example example.com

zhaofandeMBP:python_project zhaofan$

zhaofandeMBP:test1 zhaofan$ scrapy genspider shSpider hshfy.sh.cn

Created spider 'shSpider' using template 'basic' in module:

  test1.spiders.shSpider
scrapy项目结构
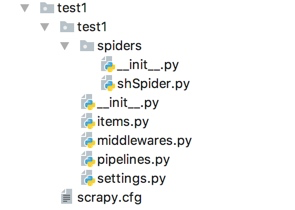
items.py 负责数据模型的建立,类似于实体类。
middlewares.py 自己定义的中间件。
pipelines.py 负责对spider返回数据的处理。
settings.py 负责对整个爬虫的配置。
spiders目录 负责存放继承自scrapy的爬虫类。
scrapy.cfg scrapy基础配置
Python爬虫从入门到放弃(十二)之 Scrapy框架的架构和原理的更多相关文章
- Python之爬虫从入门到放弃(十三) Scrapy框架整体的了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
- Python之爬虫(十四) Scrapy框架的架构和原理
这一篇文章主要是为了对scrapy框架的工作流程以及各个组件功能的介绍 Scrapy目前已经可以很好的在python3上运行Scrapy使用了Twisted作为框架,Twisted有些特殊的地方是它是 ...
- Python爬虫从入门到放弃(二十)之 Scrapy分布式原理
关于Scrapy工作流程回顾 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享爬取队列. 分布式架 ...
- Python爬虫从入门到放弃(二十二)之 爬虫与反爬虫大战
爬虫与发爬虫的厮杀,一方为了拿到数据,一方为了防止爬虫拿到数据,谁是最后的赢家? 重新理解爬虫中的一些概念 爬虫:自动获取网站数据的程序反爬虫:使用技术手段防止爬虫程序爬取数据误伤:反爬虫技术将普通用 ...
- Python爬虫从入门到放弃(二十四)之 Scrapy登录知乎
因为现在很多网站为了限制爬虫,设置了为只有登录才能看更多的内容,不登录只能看到部分内容,这也是一种反爬虫的手段,所以这个文章通过模拟登录知乎来作为例子,演示如何通过scrapy登录知乎 在通过scra ...
- Python爬虫从入门到放弃(二十一)之 Scrapy分布式部署
按照上一篇文章中我们将代码放到远程主机是通过拷贝或者git的方式,但是如果考虑到我们又多台远程主机的情况,这种方式就比较麻烦,那有没有好用的方法呢?这里其实可以通过scrapyd,下面是这个scrap ...
- python爬虫从入门到放弃(二)之爬虫的原理
在上文中我们说了:爬虫就是请求网站并提取数据的自动化程序.其中请求,提取,自动化是爬虫的关键!下面我们分析爬虫的基本流程 爬虫的基本流程 发起请求通过HTTP库向目标站点发起请求,也就是发送一个Req ...
- Python爬虫从入门到放弃(二十三)之 Scrapy的中间件Downloader Middleware实现User-Agent随机切换
总架构理解Middleware 通过scrapy官网最新的架构图来理解: 这个图较之前的图顺序更加清晰,从图中我们可以看出,在spiders和ENGINE提及ENGINE和DOWNLOADER之间都可 ...
- python爬虫从入门到放弃前奏之学习方法
首谈方法 最近在整理爬虫系列的博客,但是当整理几篇之后,发现一个问题,不管学习任何内容,其实方法是最重要的,按照我之前写的博客内容,其实学起来还是很点枯燥不能解决传统学习过程中的几个问题: 这个是普通 ...
随机推荐
- 读阿里巴巴Java开发手册v1.2.0之编程规约有感【架构篇】
不为过去蹉跎,改变当下. 为什么开篇就送这么一句话给大家,我相信很多处于1-3年码龄的哥们儿们,在平时的编码历程中编码的个性可能是多彩的,每个人都有每个人特定的风格,但是我们现在这么随意写,以后这么 ...
- Windows 7 下安装mysql-5.7.18-winx64.zip
mysql-5.7以后压缩包安装有了不小的变化 第一步:到官网下载https://dev.mysql.com/downloads/mysql/ 第二步:解压到一个文件夹 第三步:配置环境变量 把;%M ...
- 当react框架遇上百度地图
百度地图官方文档的使用指导是这样说的:在页面中引入<script type="text/javascript" src="http://api.map.baid ...
- Asp.Net Core写个共享磁盘文件Web查看器
本篇和大家分享的是一个磁盘文件查看系统,严格来说是使用NetCore写的一个Web系统应用,由于NetCore跨平台特性,我生成了exe的运行包,只需要配置运行电脑ip+端口,即可在浏览器中通过IP+ ...
- JVM-4.类加载机制
目录 一.类加载的基础 二.类加载的过程 三.类加载器:分类 四.类加载器:双亲委托模型 五.类加载器:补充 六.初始化时机/主动引用和被动引用[关于实例初始化,参考<Java编程思想05-初始 ...
- Python给多个变量赋值
# Assign values directly a, b = 0, 1 assert a == 0 assert b == 1 # Assign values from a list (r,g,b) ...
- socket套接字编程
一.概述 1.socket是一种进程间通信方式,既可以用于一台机器,也可以用于网络.常用语C/S模型. 2.可以跨越Windows和Linux操作系统,可以跨越不同语言. 3.注意网络字节序和主机字节 ...
- 为什么使用bootstrap在一个页面同时做两个轮播效果时,只有第一个有效??
我们都知道使用bootstrap做轮播效果非常快,但是有时候一个页面会需要两个轮播:但这个时候再次使用bootstrap做轮播效果时就会失效:原因在于bootstrap的Carousel问题,只要修改 ...
- WCF学习——构建一个简单的WCF应用(一)
本文的WCF服务应用功能很简单,却涵盖了一个完整WCF应用的基本结构.希望本文能对那些准备开始学习WCF的初学者提供一些帮助. 在这个例子中,我们将实现一个简单的计算器和传统的分布式通信框架一样,WC ...
- java hascode
有部分代码如下: Cat cat=new Cat("Kitty",2);system.out.println(cat):问题:输出什么? 调用并执行toString()方法,两种情 ...