
Spark编程模型(中)
创建RDD
- 方式一:从集合创建RDD
- makeRDD
- Parallelize
注意:makeRDD可以指定每个分区perferredLocations参数parallelize则没有。
- 方式二:读取外部存储创建RDD
Spark与Hadoop完全兼容,所以对Hadoop所支持的文件类型或者数据库类型,Spark同样支持。
1. 多文件格式支持:
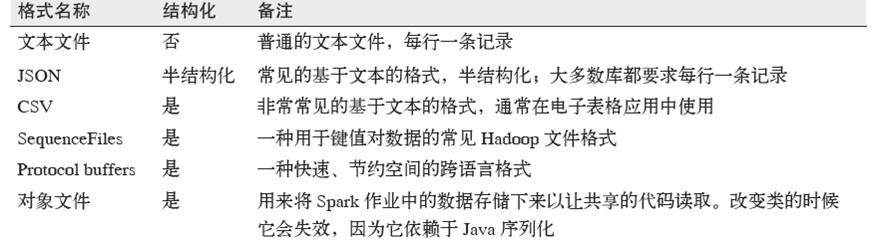
2. 多文件系统支持:
1)本地文件系统
2)S3
3)HDFS
3. 数据库
1)JdbcRDD
2)spark-cassandra-connector(datastax/spark-cassandra-connector)
3)org.apache.hadoop.hbase.mapreduce.TableInputFormat(SparkContext.newAPIHadoopRDD)
4)Elasticsearch-Hadoop
控制操作
1. persist操作,可以将RDD持久化到不同层次的存储介质,以便后续操作重复使用。
1)cache:RDD[T]
2)persist:RDD[T]
3)Persist(level:StorageLevel):RDD[T]
2. checkpoint
将RDD持久化到HDFS中,与persist操作不同的是checkpoint会切断此RDD之前的依赖关系,而persist依然保留RDD的依赖关系。
注意:控制操作的细节会在后续章节专门讲解
转换操作
- 基本转换操作1
(1)RDD的转化操作是返回新的RDD的操作;
(2)我们不应该把RDD看作存放着特定数据的数据集,而最好把每个RDD当作我们通过转化操作构建出来的、记录如何计算数据的指令列表。
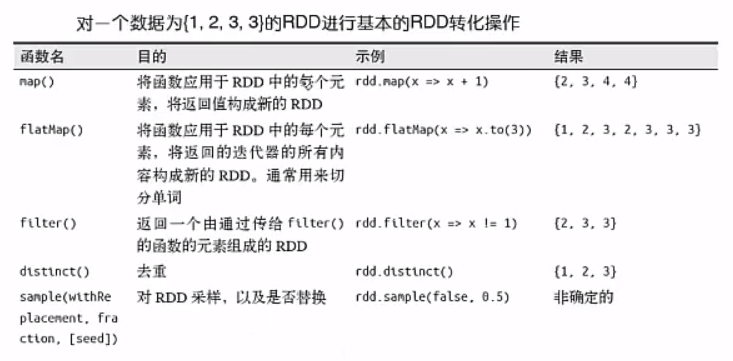
- 基本转换操作2
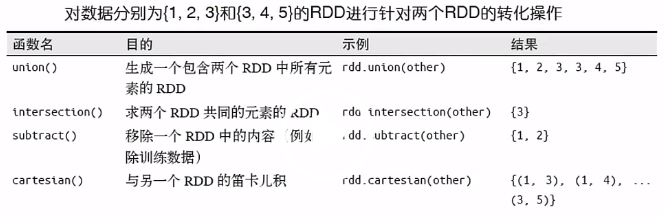
action操作

以上就是博主为大家介绍的这一板块的主要内容,这都是博主自己的学习过程,希望能给大家带来一定的指导作用,有用的还望大家点个支持,如果对你没用也望包涵,有错误烦请指出。如有期待可关注博主以第一时间获取更新哦,谢谢!
Spark编程模型(中)的更多相关文章
- Spark 编程模型(中)
先在IDEA新建一个maven项目 我这里用的是jdk1.8,选择相应的骨架 这里选择本地在window下安装的maven 新的项目创建成功 我的开始pom.xml文件配置 <project x ...
- Spark编程模型(下)
创建Pair RDD 什么是Pair RDD 包含键值对类型的RDD类型被称作Pair RDD: Pair RDD通常用来进行聚合计算: Pair RDD通常由普通RDD做ETL转化而来. Pytho ...
- Spark编程模型(博主推荐)
福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 Java全栈大联盟 ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Spark入门实战系列--3.Spark编程模型(下)--IDEA搭建及实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 . 安装IntelliJ IDEA IDEA 全称 IntelliJ IDEA,是java语 ...
- Spark中文指南(入门篇)-Spark编程模型(一)
前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apache Spark简介 Spark的四种运行模式 Spark基于Standlone的运行流程 Spark ...
- Spark:Spark 编程模型及快速入门
http://blog.csdn.net/pipisorry/article/details/52366356 Spark编程模型 SparkContext类和SparkConf类 代码中初始化 我们 ...
- 转载:Spark中文指南(入门篇)-Spark编程模型(一)
原文:https://www.cnblogs.com/miqi1992/p/5621268.html 前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apac ...
- Spark编程模型(RDD编程模型)
Spark编程模型(RDD编程模型) 下图给出了rdd 编程模型,并将下例中用 到的四个算子映射到四种算子类型.spark 程序工作在两个空间中:spark rdd空间和 scala原生数据空间.在原 ...
随机推荐
- Python:正则表达式(三)*、+、?的用法
一.功能*——表示匹配前面的字符0个或多个:+——表示前面的字符1个或多个:?——(1)放在其他字符后面:表示匹配0次或1次: (2)放在*.+后面:表示匹配尽可能少的字符 二.例 字符串fooooo ...
- play 学习 一 : 构建SBT的play项目
因为帮一个朋友做一个简单的项目,档案管理.同时也为了自己能学习PLay框架,所以记录一下. 项目GitHub地址: https://github.com/liufeiSAP/ArchiveManage ...
- 用C语言实现中文到unicode码的转换
转自: http://blog.csdn.net/qq_21792169/article/details/50379275 源文件用不同的编码方式编写,会导致执行结果不一样 由于本人喜欢用Notep ...
- Python-Redis的List操作
Redis列表是简单的字符串列表,一个列表可以包含超过40亿个元素 lpush(name,values):在name对应的list中添加元素,每个新的元素都添加到列表的最左边 rpush(name, ...
- com.mysql.jdbc.exceptions.jdbc4.MySQLSyntaxErrorException: You have an error in your SQL syntax; che
出现此种错误,我暂时遇到了两次. 1 我的字段的名称和数据库的关键字重合. 上图中的desc是默认降序排列的意思. 2 第二次出现的异常是我在重构代码阶段遇到的一个bug.不过我暂时不能理解,虽然解决 ...
- 关于overflow:hidden (转)
关于overflow:hidden (本文只针对hidden这个值的用处进行阐述) 关于overflow:hidden;很多人都知道他是溢出隐藏的一个属性,但是并不是很多人知道它的一些神奇的地方! ...
- URL中#符号的作用
转自http://blog.sina.com.cn/s/blog_6f9eb2dd0100sk97.html 一.#的涵义 #代表网页中的一个位置.其右面的字符,就是该位置的标识符.比如, ...
- Storm在zookeeper上的目录结构
storm操作zookeeper的主要函数都定义在命名空间backtype.storm.cluster中(即cluster.clj文件中). backtype.storm.cluster定义了两个重要 ...
- JavaScript中函数作为值
function myfunc() { // .. } 这是个函数,这样理解, myfunc只是外层作用域的一个变量,指向刚刚声明的function. 也就是说,function本身就是一个值, 就像 ...
- Python短小精悍的Orator查询构造器
查询构造器 介绍 这个数据库查询构造器,提供便利的接口可以创建和执行查询操作,可以在大多数数据库中使用. 查询select操作 查询表中所有的数据. users = db.table('users') ...