
Kafka:ZK+Kafka+Spark Streaming集群环境搭建(三十):使用flatMapGroupsWithState替换agg
flatMapGroupsWithState的出现解决了什么问题:
flatMapGroupsWithState的出现在spark structured streaming原因(从spark.2.2.0开始才开始支持):
1)可以实现agg函数;
2)就目前最新spark2.3.2版本来说在spark structured streming中依然不支持对dataset多次agg操作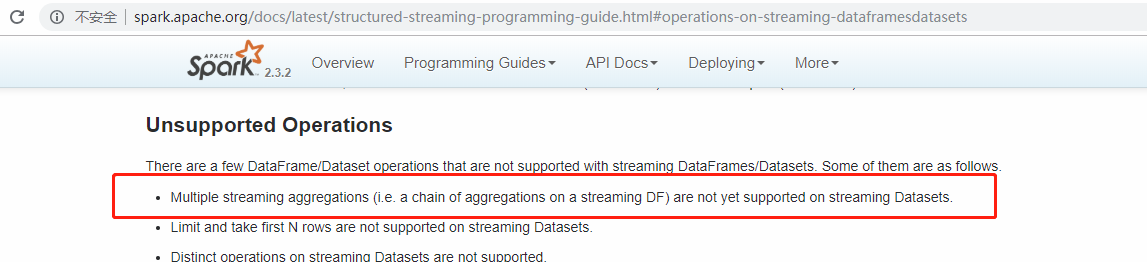
,而flatMapGroupsWithState可以替代agg的作用,同时它允许在sink为append模式下在agg之前使用。
注意:尽管允许agg之前使用,但前提是:输出(sink)方式Append方式。

flatMapGroupsWithState的使用示例(从网上找到):
参考:《https://jaceklaskowski.gitbooks.io/spark-structured-streaming/spark-sql-streaming-KeyValueGroupedDataset-flatMapGroupsWithState.html》
说明:以下示例代码实现了“select deviceId,count(0) as count from tbName group by deviceId.”。
1)spark2.3.0版本下定义一个Signal实体类:
scala> spark.version

res0: String = 2.3.0-SNAPSHOT

import java.sql.Timestamp

type DeviceId = Int

case class Signal(timestamp: java.sql.Timestamp, value: Long, deviceId: DeviceId)
2)使用Rate source方式生成一些测试数据(随机实时流方式),并查看执行计划:
// input stream

import org.apache.spark.sql.functions._

val signals = spark.

  readStream.

  format("rate").

  option("rowsPerSecond", 1).

  load.

  withColumn("value", $"value" % 10).  // <-- randomize the values (just for fun)

  withColumn("deviceId", rint(rand() * 10) cast "int"). // <-- 10 devices randomly assigned to values

  as[Signal] // <-- convert to our type (from "unpleasant" Row)

scala> signals.explain

== Physical Plan ==

*Project [timestamp#0, (value#1L % 10) AS value#5L, cast(ROUND((rand(4440296395341152993) * 10.0)) as int) AS deviceId#9]

+- StreamingRelation rate, [timestamp#0, value#1L]
3)对Rate source流对象进行groupBy,使用flatMapGroupsWithState实现agg
// stream processing using flatMapGroupsWithState operator

val device: Signal => DeviceId = { case Signal(_, _, deviceId) => deviceId }

val signalsByDevice = signals.groupByKey(device)

import org.apache.spark.sql.streaming.GroupState

type Key = Int

type Count = Long

type State = Map[Key, Count]

case class EventsCounted(deviceId: DeviceId, count: Long)

def countValuesPerKey(deviceId: Int, signalsPerDevice: Iterator[Signal], state: GroupState[State]): Iterator[EventsCounted] = {

  val values = signalsPerDevice.toList

  println(s"Device: $deviceId")

  println(s"Signals (${values.size}):")

  values.zipWithIndex.foreach { case (v, idx) => println(s"$idx. $v") }

  println(s"State: $state")

  // update the state with the count of elements for the key

  val initialState: State = Map(deviceId -> 0)

  val oldState = state.getOption.getOrElse(initialState)

  // the name to highlight that the state is for the key only

  val newValue = oldState(deviceId) + values.size

  val newState = Map(deviceId -> newValue)

  state.update(newState)

  // you must not return as it's already consumed

  // that leads to a very subtle error where no elements are in an iterator

  // iterators are one-pass data structures

  Iterator(EventsCounted(deviceId, newValue))

}

import org.apache.spark.sql.streaming.{GroupStateTimeout, OutputMode}

val signalCounter = signalsByDevice.flatMapGroupsWithState(

  outputMode = OutputMode.Append,

  timeoutConf = GroupStateTimeout.NoTimeout)(func = countValuesPerKey)
4)使用Console Sink方式打印agg结果:
import org.apache.spark.sql.streaming.{OutputMode, Trigger}

import scala.concurrent.duration._

val sq = signalCounter.

  writeStream.

  format("console").

  option("truncate", false).

  trigger(Trigger.ProcessingTime(10.seconds)).

  outputMode(OutputMode.Append).

  start
5)console print
...

-------------------------------------------

Batch:

-------------------------------------------

+--------+-----+

|deviceId|count|

+--------+-----+

+--------+-----+

...

// :: INFO StreamExecution: Streaming query made progress: {

  "id" : "a43822a6-500b-4f02-9133-53e9d39eedbf",

  "runId" : "79cb037e-0f28-4faf-a03e-2572b4301afe",

  "name" : null,

  "timestamp" : "2017-08-21T06:57:26.719Z",

  "batchId" : ,

  "numInputRows" : ,

  "processedRowsPerSecond" : 0.0,

  "durationMs" : {

    "addBatch" : ,

    "getBatch" : ,

    "getOffset" : ,

    "queryPlanning" : ,

    "triggerExecution" : ,

    "walCommit" :

  },

  "stateOperators" : [ {

    "numRowsTotal" : ,

    "numRowsUpdated" : ,

    "memoryUsedBytes" :

  } ],

  "sources" : [ {

    "description" : "RateSource[rowsPerSecond=1, rampUpTimeSeconds=0, numPartitions=8]",

    "startOffset" : null,

    "endOffset" : ,

    "numInputRows" : ,

    "processedRowsPerSecond" : 0.0

  } ],

  "sink" : {

    "description" : "ConsoleSink[numRows=20, truncate=false]"

  }

}

// :: DEBUG StreamExecution: batch  committed

...

-------------------------------------------

Batch:

-------------------------------------------

Device:

Signals ():

. Signal(-- ::27.682,,)

State: GroupState(<undefined>)

Device:

Signals ():

. Signal(-- ::26.682,,)

State: GroupState(<undefined>)

Device:

Signals ():

. Signal(-- ::28.682,,)

State: GroupState(<undefined>)

+--------+-----+

|deviceId|count|

+--------+-----+

|       |    |

|       |    |

|       |    |

+--------+-----+

...

// :: INFO StreamExecution: Streaming query made progress: {

  "id" : "a43822a6-500b-4f02-9133-53e9d39eedbf",

  "runId" : "79cb037e-0f28-4faf-a03e-2572b4301afe",

  "name" : null,

  "timestamp" : "2017-08-21T06:57:30.004Z",

  "batchId" : ,

  "numInputRows" : ,

  "inputRowsPerSecond" : 0.91324200913242,

  "processedRowsPerSecond" : 2.2388059701492535,

  "durationMs" : {

    "addBatch" : ,

    "getBatch" : ,

    "getOffset" : ,

    "queryPlanning" : ,

    "triggerExecution" : ,

    "walCommit" :

  },

  "stateOperators" : [ {

    "numRowsTotal" : ,

    "numRowsUpdated" : ,

    "memoryUsedBytes" :

  } ],

  "sources" : [ {

    "description" : "RateSource[rowsPerSecond=1, rampUpTimeSeconds=0, numPartitions=8]",

    "startOffset" : ,

    "endOffset" : ,

    "numInputRows" : ,

    "inputRowsPerSecond" : 0.91324200913242,

    "processedRowsPerSecond" : 2.2388059701492535

  } ],

  "sink" : {

    "description" : "ConsoleSink[numRows=20, truncate=false]"

  }

}

// :: DEBUG StreamExecution: batch  committed

...

-------------------------------------------

Batch:

-------------------------------------------

Device:

Signals ():

. Signal(-- ::36.682,,)

State: GroupState(<undefined>)

Device:

Signals ():

. Signal(-- ::32.682,,)

. Signal(-- ::35.682,,)

State: GroupState(Map( -> ))

Device:

Signals ():

. Signal(-- ::34.682,,)

State: GroupState(<undefined>)

Device:

Signals ():

. Signal(-- ::29.682,,)

State: GroupState(<undefined>)

Device:

Signals ():

. Signal(-- ::31.682,,)

. Signal(-- ::33.682,,)

State: GroupState(Map( -> ))

Device:

Signals ():

. Signal(-- ::30.682,,)

. Signal(-- ::37.682,,)

State: GroupState(Map( -> ))

Device:

Signals ():

. Signal(-- ::38.682,,)

State: GroupState(<undefined>)

+--------+-----+

|deviceId|count|

+--------+-----+

|       |    |

|       |    |

|       |    |

|       |    |

|       |    |

|       |    |

|       |    |

+--------+-----+

...

// :: INFO StreamExecution: Streaming query made progress: {

  "id" : "a43822a6-500b-4f02-9133-53e9d39eedbf",

  "runId" : "79cb037e-0f28-4faf-a03e-2572b4301afe",

  "name" : null,

  "timestamp" : "2017-08-21T06:57:40.005Z",

  "batchId" : ,

  "numInputRows" : ,

  "inputRowsPerSecond" : 0.9999000099990002,

  "processedRowsPerSecond" : 9.242144177449168,

  "durationMs" : {

    "addBatch" : ,

    "getBatch" : ,

    "getOffset" : ,

    "queryPlanning" : ,

    "triggerExecution" : ,

    "walCommit" :

  },

  "stateOperators" : [ {

    "numRowsTotal" : ,

    "numRowsUpdated" : ,

    "memoryUsedBytes" :

  } ],

  "sources" : [ {

    "description" : "RateSource[rowsPerSecond=1, rampUpTimeSeconds=0, numPartitions=8]",

    "startOffset" : ,

    "endOffset" : ,

    "numInputRows" : ,

    "inputRowsPerSecond" : 0.9999000099990002,

    "processedRowsPerSecond" : 9.242144177449168

  } ],

  "sink" : {

    "description" : "ConsoleSink[numRows=20, truncate=false]"

  }

}

// :: DEBUG StreamExecution: batch  committed

// In the end...

sq.stop

// Use stateOperators to access the stats

scala> println(sq.lastProgress.stateOperators().prettyJson)

{

  "numRowsTotal" : ,

  "numRowsUpdated" : ,

  "memoryUsedBytes" :

}
Kafka:ZK+Kafka+Spark Streaming集群环境搭建(三十):使用flatMapGroupsWithState替换agg的更多相关文章
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十二)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网。
Centos7出现异常:Failed to start LSB: Bring up/down networking. 按照<Kafka:ZK+Kafka+Spark Streaming集群环境搭 ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十)安装hadoop2.9.0搭建HA
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十九)ES6.2.2 安装Ik中文分词器
注: elasticsearch 版本6.2.2 1)集群模式,则每个节点都需要安装ik分词,安装插件完毕后需要重启服务,创建mapping前如果有机器未安装分词,则可能该索引可能为RED,需要删除后 ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十五)Spark编写UDF、UDAF、Agg函数
Spark Sql提供了丰富的内置函数让开发者来使用,但实际开发业务场景可能很复杂,内置函数不能够满足业务需求,因此spark sql提供了可扩展的内置函数. UDF:是普通函数,输入一个或多个参数, ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十六)Structured Streaming中ForeachSink的用法
Structured Streaming默认支持的sink类型有File sink,Foreach sink,Console sink,Memory sink. ForeachWriter实现: 以写 ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十四)定义一个avro schema使用comsumer发送avro字符流,producer接受avro字符流并解析
参考<在Kafka中使用Avro编码消息:Consumer篇>.<在Kafka中使用Avro编码消息:Producter篇> 在了解如何avro发送到kafka,再从kafka ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十八)ES6.2.2 增删改查基本操作
#文档元数据 一个文档不仅仅包含它的数据 ,也包含 元数据 —— 有关 文档的信息. 三个必须的元数据元素如下:## _index 文档在哪存放 ## _type 文档表示的对象类别 ## ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十三)kafka+spark streaming打包好的程序提交时提示虚拟内存不足(Container is running beyond virtual memory limits. Current usage: 119.5 MB of 1 GB physical memory used; 2.2 GB of 2.1 G)
异常问题:Container is running beyond virtual memory limits. Current usage: 119.5 MB of 1 GB physical mem ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(九)安装kafka_2.11-1.1.0
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(八)安装zookeeper-3.4.12
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
随机推荐
- kmp算法专题总结
next数组的含义:next[i]表示以字符串s的第i个字符为结尾的后缀与s前缀匹配的长度 next数组也可以当做fail数组,即当模式串s[j]与串t[i]不匹配时,只要将j转换到next[j]继续 ...
- poj3349 散列表(hash)
就是散列表的应用,把每片哈希值相同的雪花排到一条链上去即可,每片雪花x的哈希值 hash(x)=sum(x的六角)+mul(x的六角),会爆int #include<iostream> # ...
- js中数组去重
编写函数norepeat(arr) 将数组的重复元素去掉,并返回新的数组 [注]正序去重,会漏掉一些元素. [注]去重倒序. var arr = [10, 20, 30, 40, 30, 20, 20 ...
- 怎样在win7 IIS中部署网站?
IIS作为微软web服务器的平台,可以轻松的部署网站,让网站轻而易举的搭建成功,那么如何在IIS中部署一个网站呢,下面就跟小编一起学习一下吧. 第一步:发布IIS文件 1:发布你所要在IIS上部署的网 ...
- IDA Pro的patch插件 KeyPatch
本来这个是没什么可写的,但是安这个插件的时候真是气到爆炸,安装文档写的不明不白,几万行的代码都写了就差那么点时间写个几十字的详细说明吗? 1.下载keypatch.py放到\IDA\plugins里 ...
- 【C++ Primer 第11章 练习答案】2. 关联容器概述
11.2.1节练习 [练习11.7]代码: #include<iostream> #include<string> #include<vector> #includ ...
- Unity3d 之 理解Gameobject ,gameObject,Transform,transform的区别和关联
Gameobject是一个类型,所有的游戏物件都是这个类型的对象. gameobject是一个对象, 就跟java里面的this一样, 指的是这个脚本所附着的游戏物件 public class Sho ...
- webstorm 格式化代码及常用快捷键
mac 下 webstorm 格式化代码的快捷键 Option+Command+l windows 下 webstorm 格式化代码的快键键 Ctrl+Alt+l centOS 下webstorm 格 ...
- lintcode 最大子数组III
题目描述 给定一个整数数组和一个整数 k,找出 k 个不重叠子数组使得它们的和最大.每个子数组的数字在数组中的位置应该是连续的. 返回最大的和. 注意事项 子数组最少包含一个数 样例 给出数组 [-1 ...
- 算法进阶面试题01——KMP算法详解、输出含两次原子串的最短串、判断T1是否包含T2子树、Manacher算法详解、使字符串成为最短回文串
1.KMP算法详解与应用 子序列:可以连续可以不连续. 子数组/串:要连续 暴力方法:逐个位置比对. KMP:让前面的,指导后面. 概念建设: d的最长前缀与最长后缀的匹配长度为3.(前缀不能到最后一 ...