
ML: 聚类算法R包-K中心点聚类
K-medodis与K-means比较相似,但是K-medoids和K-means是有区别的,不一样的地方在于中心点的选取,在K-means中,我们将中心点取为当前cluster中所有数据点的平均值,在 K-medoids算法中,我们将从当前cluster 中选取这样一个点——它到其他所有(当前cluster中的)点的距离之和最小——作为中心点。K-medodis算法不容易受到那些由于误差之类的原因产生的脏数据的影响,但计算量显然要比K-means要大,一般只适合小数据量。 K-medoids 主要运用到了R语言中cluster包中的pam函数
K中心点聚类
- cluster::pam
- fpc::pamk
cluster::pam
Usage: pam(x, k, diss = inherits(x, "dist"), metric = "euclidean", medoids = NULL, stand = FALSE, cluster.only = FALSE, do.swap = TRUE, keep.diss = !diss && !cluster.only && n < 100, keep.data = !diss && !cluster.only, pamonce = FALSE, trace.lev = 0)
- x:聚类对象
- k: 是聚类个数 ( positive integer specifying the number of clusters, less than the number of observations)
示例代码
> newiris <- iris[,-5]

> library(cluster)

> kc <- pam(x=newiris,k=3)

> #kc$clustering

> #kc[1:length(kc)]

>

> table(iris$Species, kc$clustering)

              1  2  3

  setosa     50  0  0

  versicolor  0 48  2

  virginica   0 14 36
小结:
针对K-均值算法易受极值影响这一缺点的改进算法.在原理上的差异在于选择个类别中心点时不取样本均值点,而在类别内选取到其余样本距离之和最小的样本为中心。
fpc::pamk
相比于pam函数,可以给出参考的聚类个数, 参考 kmenas 与 kmeansrun
Usage: pamk(data,krange=2:10,criterion="asw", usepam=TRUE, scaling=FALSE, alpha=0.001, diss=inherits(data, "dist"), critout=FALSE, ns=10, seed=NULL, ...)
示例代码
newiris <- iris

newiris$Species <- NULL

library(fpc)

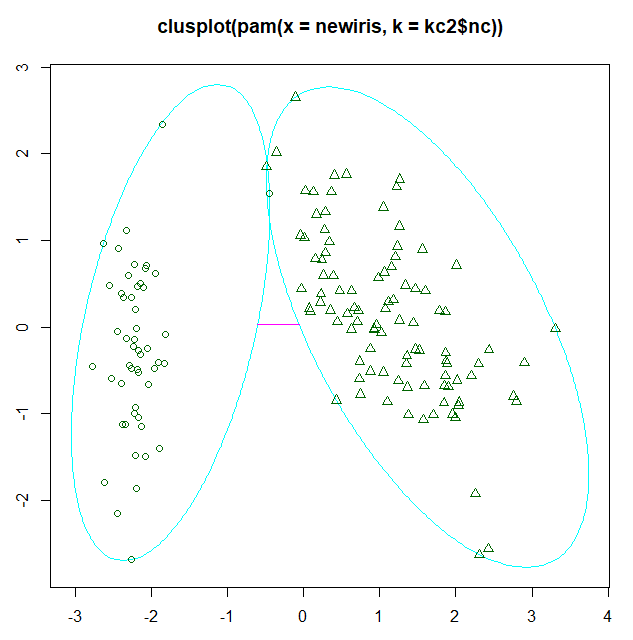
kc2 <- pamk(newiris,krang=1:5)

plot(pam(newiris, kc2$nc))
图例
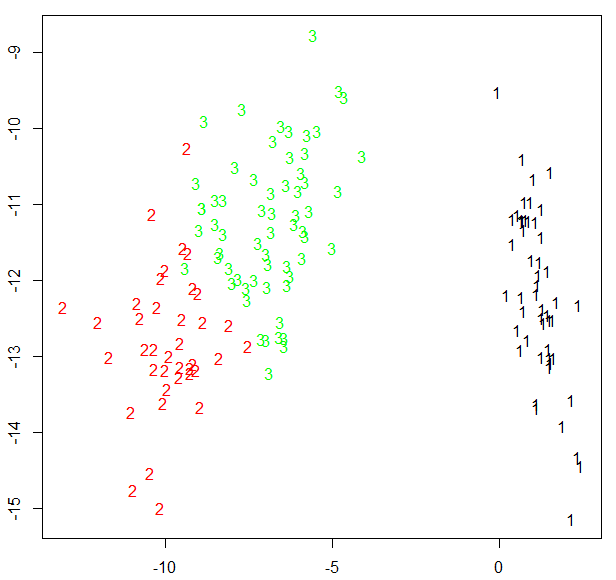
fpc包还提供了另一个展示聚类分析的函数plotcluster(),值得一提的是,数据将被投影到不同的簇中
plotcluster(newiris,kc2$cluster)
待验证:
为什么仅出现两个聚类?
参考资料:
ML: 聚类算法R包-K中心点聚类的更多相关文章
- ML: 聚类算法R包-层次聚类
层次聚类 stats::hclust stats::dist R使用dist()函数来计算距离,Usage: dist(x, method = "euclidean", di ...
- ML: 聚类算法R包 - 模型聚类
模型聚类 mclust::Mclust RWeka::Cobweb mclust::Mclust EM算法也称为期望最大化算法,在是使用该算法聚类时,将数据集看作一个有隐形变量的概率模型,并实现模型最 ...
- ML: 聚类算法R包-模糊聚类
1965年美国加州大学柏克莱分校的扎德教授第一次提出了'集合'的概念.经过十多年的发展,模糊集合理论渐渐被应用到各个实际应用方面.为克服非此即彼的分类缺点,出现了以模糊集合论为数学基础的聚类分析.用模 ...
- ML: 聚类算法R包-对比
测试验证环境 数据: 7w+ 条,数据结构如下图: > head(car.train) DV DC RV RC SOC HV LV HT LT Type TypeName 1 379 85.09 ...
- ML: 聚类算法R包-网格聚类
网格聚类算法 optpart::clique optpart::clique CLIQUE(Clustering In QUEst)是一种简单的基于网格的聚类方法,用于发现子空间中基于密度的簇.CLI ...
- ML: 聚类算法R包 - 密度聚类
密度聚类 fpc::dbscan fpc::dbscan DBSCAN核心思想:如果一个点,在距它Eps的范围内有不少于MinPts个点,则该点就是核心点.核心和它Eps范围内的邻居形成一个簇.在一个 ...
- Python聚类算法之基本K均值实例详解
Python聚类算法之基本K均值实例详解 本文实例讲述了Python聚类算法之基本K均值运算技巧.分享给大家供大家参考,具体如下: 基本K均值 :选择 K 个初始质心,其中 K 是用户指定的参数,即所 ...
- 机器学习算法总结(五)——聚类算法(K-means,密度聚类,层次聚类)
本文介绍无监督学习算法,无监督学习是在样本的标签未知的情况下,根据样本的内在规律对样本进行分类,常见的无监督学习就是聚类算法. 在监督学习中我们常根据模型的误差来衡量模型的好坏,通过优化损失函数来改善 ...
- 模式识别之聚类算法k-均值---k-均值聚类算法c实现
//写个简单的先练习一下,测试通过 //k-均值聚类算法C语言版 #include <stdlib.h> #include <stdio.h> #inc ...
随机推荐
- 使用grafana cli重置grafana密码
Grafana CLIgrafana cli是grafana server自带的一个小巧的二进制工具,用来在运行grafana server的机器上执行命令.插件grafana cli工具允许你安装升 ...
- 在Microsoft Power BI中创建地图的10种方法
今天,我们来简单聊一聊“地图”. 在我们日常生活中,地图地位已经提升的越来越高,出门聚餐.驾驶.坐车.旅行......应运而生的就是各种Map APP. 作为数据分析师,我们今天不讲生活地图,要跟大家 ...
- 异常值检测 —— MAD(median absolute deviation)
MAD 定义为,一元序列 Xi" role="presentation">XiXi 同其中位数偏差的绝对值的中位数(deviation,偏差本身有正有负): MAD ...
- Python之路PythonNet,第四篇,网络4
pythonnet 网络4 select 支持水平触发 poll 支持水平触发 epoll epoll 也是一种IO多路复用的方式,效率比select和poll 要高一点: epol ...
- conda创建虚拟环境
可能自己常常会遇到一个这样的问题,自己服务器安装的是python2,但是现在有的代码是基于python3的啊 怎么办?自己将代码转换成python2的呗,是的,我曾经就这样做过,但是真的是很鸡肋 更有 ...
- Ubuntu16.04通过GPT挂载硬盘
一般而言,服务器上挂载的硬盘都是比较大的,传统的对硬盘进行分区需要在终端敲sudo fdisk进行操作,但是, 当挂载的硬盘的容量大于2T的时候,是无法通过sudo fdisk进行挂载的,这个时候必须 ...
- 服务器上安装caffe的过程记录
1. 前言 因为新的实验室东西都是新的,所以在服务器上要自己重新配置CAFFE 这里假设所有依赖包学长们都安装好了,我是没有sudo权限的 服务器的配置: CUDA 8.0 Ubuntu 16.04 ...
- JAVA基础部分复习(三、泛型)
JAVA泛型的基本使用: /** * JAVA泛型的使用 * 定义:泛型的本质是参数化类型,就是说所操作的数据类型被指定为一个参数. * * 定义泛型方法的规则 * 1.所有泛型方法声明都有一个类型参 ...
- eclipse如何为java项目生成API文档、JavaDoc
当我们的项目很大,编写了很多代码的时候,就需要生成一个标准的API文档,让后续的开发人员,或者合作者可以清晰的了解您方法的使用,那么如何将自己的项目生成API文档呢? 1.点击eclipse的[Pro ...
- hdoj-1022(栈的模拟)
#include <iostream> #include <cstring> #include <algorithm> #include <stack> ...