
Python 网页解析器
Python 有几种网页解析器?
1、 正则表达式
2、html.parser (Python自动)
3、BeautifulSoup(第三方)(功能比较强大) 是一个HTML/XML的解析器
4、lxml (第三方)
BeautifulSoup 栗子:
地址:https://www.crummy.com/software/BeautifulSoup/bs4/download/
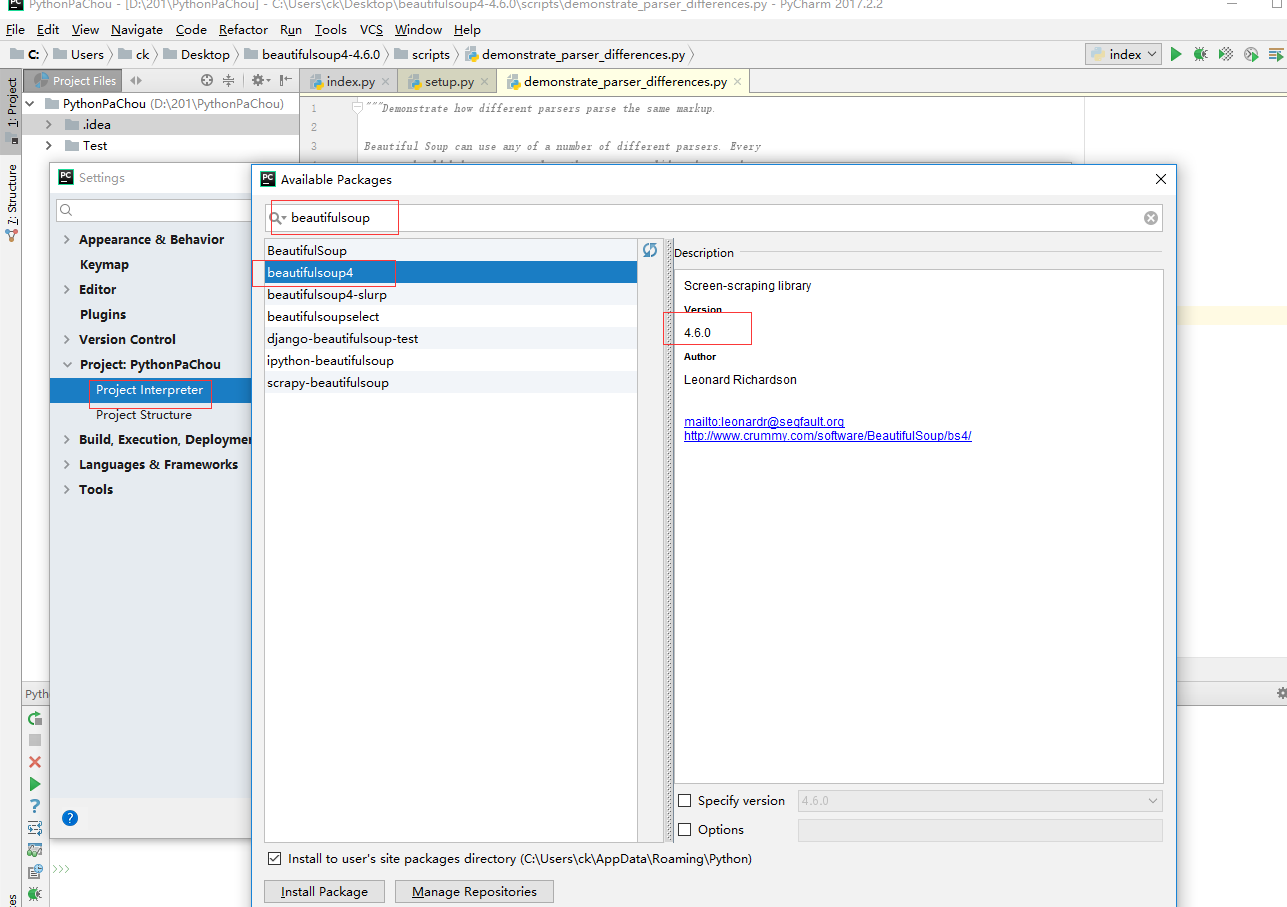
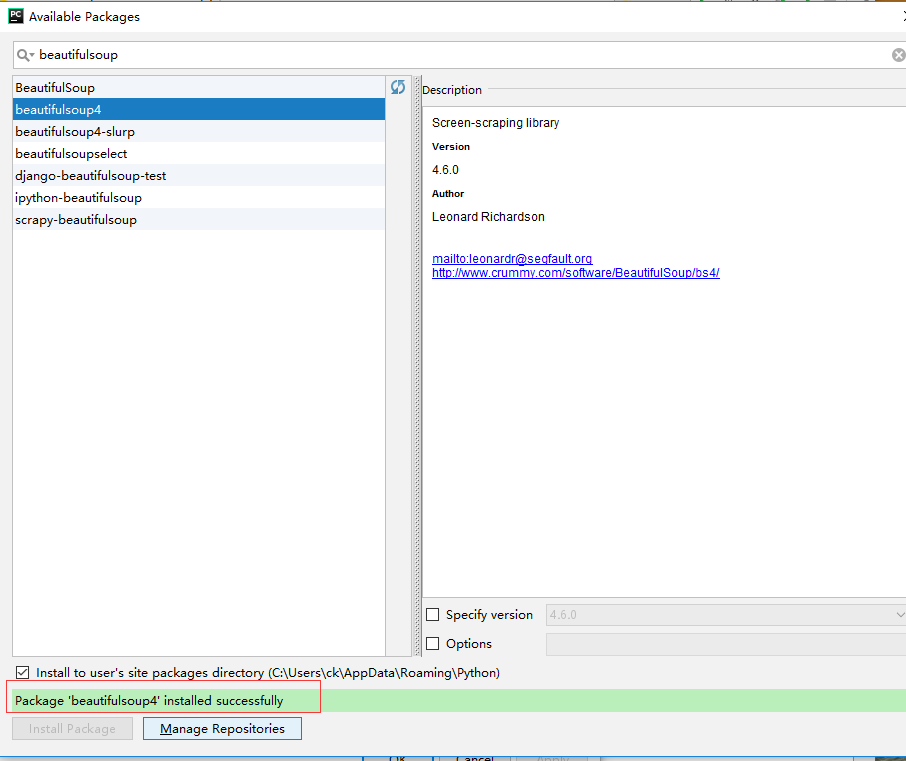
PyCharm安装方法
file → Settings → Project Interpreter(这一步需要你自己找一下),点击右边 "+" 加号,输入 beautifulsoup 选择对应的版本就ok了,上图:
来一个栗子:
from bs4 import BeautifulSoup

import re

html_doc = """

<html><head><title>The Dormouse's story</title></head>

<body>

<p class="title"><b>The Dormouse's story</b></p>

<p class="story">Once upon a time there were three little sisters; and their names were

<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,

<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and

<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;

and they lived at the bottom of a well.</p>

<p class="story">...</p>

"""

soup = BeautifulSoup(html_doc,'html.parser',from_encoding='utf-8')

print('获取所有的连接')

links = soup.find_all('a')

for link in links:

    print(link.name,link['href'],link.get_text())

print('获取lacie的连接')

link_node = soup.find('a',href='http://example.com/lacie')

print(link.name, link['href'], link.get_text())

#模糊匹配

print('正则匹配')

link_node = soup.find('a',href=re.compile(r'lll'))

print(link.name, link['href'], link.get_text())

print('获取P段落文字')

param = input('请输入要检索的样式名称:')

p_node = soup.find('p',class_='story')

print(p_node.name, p_node.get_text())
Python 网页解析器的更多相关文章
- python 之网页解析器
一.什么是网页解析器 1.网页解析器名词解释 首先让我们来了解下,什么是网页解析器,简单的说就是用来解析html网页的工具,准确的说:它是一个HTML网页信息提取工具,就是从html网页中解析提取出“ ...
- Python 文本解析器
Python 文本解析器 一.课程介绍 本课程讲解一个使用 Python 来解析纯文本生成一个 HTML 页面的小程序. 二.相关技术 Python:一种面向对象.解释型计算机程序设计语言,用它可以做 ...
- 第6章 网页解析器和BeautifulSoup第三方插件
第一节 网页解析器简介作用:从网页中提取有价值数据的工具python有哪几种网页解析器?其实就是解析HTML页面正则表达式:模糊匹配结构化解析-DOM树:html.parserBeautiful So ...
- python3 爬虫五大模块之四:网页解析器
Python的爬虫框架主要可以分为以下五个部分: 爬虫调度器:用于各个模块之间的通信,可以理解为爬虫的入口与核心(main函数),爬虫的执行策略在此模块进行定义: URL管理器:负责URL的管理,包括 ...
- Python网页解析库:用requests-html爬取网页
Python网页解析库:用requests-html爬取网页 1. 开始 Python 中可以进行网页解析的库有很多,常见的有 BeautifulSoup 和 lxml 等.在网上玩爬虫的文章通常都是 ...
- Python HTML解析器BeautifulSoup(爬虫解析器)
BeautifulSoup简介 我们知道,Python拥有出色的内置HTML解析器模块——HTMLParser,然而还有一个功能更为强大的HTML或XML解析工具——BeautifulSoup(美味的 ...
- Python网页解析
续上篇文章,网页抓取到手之后就是解析网页了. 在Python中解析网页的库不少,我最开始使用的是BeautifulSoup,貌似这个也是Python中最知名的HTML解析库.它主要的特点就是容错性很好 ...
- 转:Python网页解析:BeautifulSoup vs lxml.html
转自:http://www.cnblogs.com/rzhang/archive/2011/12/29/python-html-parsing.html Python里常用的网页解析库有Beautif ...
- python——BS解析器
随机推荐
- javanio1----传统io
import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; import ...
- calendar 模块
calendar模块,即日历模块,提供了对日期的一些操作方法,和生成日历的方法 注:星期一是默认的每周第一天,星期天是默认的最后一天.更改设置需调用calendar.setfirstweekday() ...
- EditPlus配置Java
--Java Compile-- 命令:D:\Program Files\Java\jdk1.7.0_79\bin\javac.exe 参数:$(FileName) 初始目录:$(FileDir) 动 ...
- Linux的常用路由配置
1.配置默认路由 ip route add default via 192.168.10.1 dev eth0 route add default gw 192.168.10.1 2.间接路由: ip ...
- ztree实现表格风格的树状结构
zTree官方api: http://www.treejs.cn/v3/api.php 原理很简单:利用zTree的addDiyDom方法,自定义每个DOM节点,在原来的节点后面加一些div,再利用c ...
- Fiddler(三)Fiddler设置手机抓包
一.前提 我们要实现手机抓包,必须要手机连接的wifi和PC段连接的wifi所处同一个局域网内,如果你使用的是笔记本,那么这个就好办了,如果你使用的是台式机,那么你还需要准备一个无线网卡.我使用的是F ...
- P3157 [CQOI2011]动态逆序对(树状数组套线段树)
P3157 [CQOI2011]动态逆序对 树状数组套线段树 静态逆序对咋做?树状数组(别管归并QWQ) 然鹅动态的咋做? 我们考虑每次删除一个元素. 减去的就是与这个元素有关的逆序对数,介个可以预处 ...
- 使用maven profile实现多环境配置相关打包
项目开发需要有多个环境,一般为开发,测试,预发,正式4个环境,通过maven可以实现按不同环境进行打包部署,命令为: mvn package -P dev 在eclipse中可以右击选项run con ...
- DL_WITH_PY系统学习(第3章)
本节提示: 1.DL的核心构建 2.Keras的简单介绍 3.搭建DL机器训练环境 4.使用DL模型解决基础问题 3.1 DL的基本构建:layer layer的定义:以1个或多个tensor作为输入 ...
- QML使用的内置对象
QML从ECMAScript继承而来,所以支持这个ECMAScript.经常在QML工程中看到Math.Data.....等方法,但是在Qt手册里搜索不到,这是因为这些方法不是QtQuick的,而是E ...