
centos7+hadoop完全分布式集群搭建
Hadoop集群部署,就是以Cluster mode方式进行部署。本文是基于JDK1.7.0_79,hadoop2.7.5。
1.Hadoop的节点构成如下:
HDFS daemon: NameNode, SecondaryNameNode, DataNode
YARN damones: ResourceManager, NodeManager, WebAppProxy
MapReduce Job History Server
本次测试的分布式环境为:Master 1台 (test166),Slave 1台(test167)
2.1 安装JDK及下载解压hadoop
JDK安装可参考:https://www.cnblogs.com/Dylansuns/p/6974272.html 或者简单安装:https://www.cnblogs.com/shihaiming/p/5809553.html
从官网下载Hadoop最新版2.7.5
[hadoop@hadoop-master ~]$ su - hadoop
[hadoop@hadoop-master ~]$ cd /usr/hadoop/

[hadoop@hadoop-master ~]$ wget http://mirrors.shu.edu.cn/apache/hadoop/common/hadoop-2.7.5/hadoop-2.7.5.tar.gz
将hadoop解压到/usr/hadoop/下
[hadoop@hadoop-master ~]$ tar zxvf /root/hadoop-2.7..tar.gz
结果:
[hadoop@hadoop-master ~]$ ll

total

drwxr-xr-x.   hadoop hadoop          Jan  : Desktop

drwxr-xr-x.   hadoop hadoop          Jan  : Documents

drwxr-xr-x.   hadoop hadoop          Jan  : Downloads

drwxr-xr-x.  hadoop hadoop       Feb  : hadoop-2.7.

-rw-rw-r--.   hadoop hadoop  Dec  : hadoop-2.7..tar.gz

drwxr-xr-x.   hadoop hadoop          Jan  : Music

drwxr-xr-x.   hadoop hadoop          Jan  : Pictures

drwxr-xr-x.   hadoop hadoop          Jan  : Public

drwxr-xr-x.   hadoop hadoop          Jan  : Templates

drwxr-xr-x.   hadoop hadoop          Jan  : Videos

[hadoop@hadoop-master ~]$
2.2 在各节点上设置主机名及创建hadoop组和用户
所有节点(master,slave)
 [root@hadoop-master ~]#  su - root

 [root@hadoop-master ~]#  vi /etc/hosts

 10.86.255.166 hadoop-master

 10.86.255.167 slave1

 注意:修改hosts中,是立即生效的,无需source或者. 。
先使用
建立hadoop用户组
新建用户,useradd -d /usr/hadoop -g hadoop -m hadoop (新建用户hadoop指定用户主目录/usr/hadoop 及所属组hadoop)
passwd hadoop 设置hadoop密码(这里设置密码为hadoop)
[root@hadoop-master ~]# groupadd hadoop
[root@hadoop-master ~]# useradd -d /usr/hadoop -g hadoop -m hadoop
[root@hadoop-master ~]# passwd hadoop
2.3 在各节点上设置SSH无密码登录
最终达到目的:即在master:节点执行 ssh hadoop@salve1不需要密码,此处只需配置master访问slave1免密。
su - hadoop
进入~/.ssh目录
执行:ssh-keygen -t rsa,一路回车
生成两个文件,一个私钥,一个公钥,在master1中执行:cp id_rsa.pub authorized_keys
[hadoop@hadoop-master ~]$ su - hadoop
[hadoop@hadoop-master ~]$ pwd

/usr/hadoop

[hadoop@hadoop-master ~]$ cd .ssh

[hadoop@hadoop-master .ssh]$ ssh-keygen -t rsa

Generating public/private rsa key pair.

Enter file in which to save the key (/usr/hadoop/.ssh/id_rsa):

Enter passphrase (empty for no passphrase):

Enter same passphrase again:

Your identification has been saved in /usr/hadoop/.ssh/id_rsa.

Your public key has been saved in /usr/hadoop/.ssh/id_rsa.pub.

The key fingerprint is:

:b2::8c:e7::1d:4c:2f:::1a:::bb:de hadoop@hadoop-master

The key's randomart image is:

+--[ RSA ]----+

|=+*.. . .        |

|oo O . o .       |

|. o B + .        |

|   = + . .       |

|  + o   S        |

| . +             |

|  . E            |

|                 |

|                 |

+-----------------+

[hadoop@hadoop-master .ssh]$
[hadoop@hadoop-master .ssh]$ cp id_rsa.pub authorized_keys
[hadoop@hadoop-master .ssh]$ ll
total 16
-rwx------. 1 hadoop hadoop 1230 Jan 31 23:27 authorized_keys
-rwx------. 1 hadoop hadoop 1675 Feb 23 19:07 id_rsa
-rwx------. 1 hadoop hadoop  402 Feb 23 19:07 id_rsa.pub
-rwx------. 1 hadoop hadoop  874 Feb 13 19:40 known_hosts
[hadoop@hadoop-master .ssh]$
2.3.1:本机无密钥登录
[hadoop@hadoop-master ~]$ pwd
/usr/hadoop
[hadoop@hadoop-master ~]$ chmod -R  .ssh
[hadoop@hadoop-master ~]$ cd .ssh
[hadoop@hadoop-master .ssh]$ chmod 600 authorized_keys
[hadoop@hadoop-master .ssh]$ ll
total 16
-rwx------. 1 hadoop hadoop 1230 Jan 31 23:27 authorized_keys
-rwx------. 1 hadoop hadoop 1679 Jan 31 23:26 id_rsa
-rwx------. 1 hadoop hadoop  410 Jan 31 23:26 id_rsa.pub
-rwx------. 1 hadoop hadoop  874 Feb 13 19:40 known_hosts
验证:
没有提示输入密码则表示本机无密钥登录成功,如果此步不成功,后续启动hdfs脚本会要求输入密码
[hadoop@hadoop-master ~]$ ssh hadoop@hadoop-master

Last login: Fri Feb  ::  from hadoop-master

[hadoop@hadoop-master ~]$
2.3.2:master与其他节点无密钥登录
( 若已有authorized_keys,则执行ssh-copy-id ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop@slave1 上面命令的功能ssh-copy-id将pub值写入远程机器的~/.ssh/authorized_key中
)
从master中把authorized_keys分发到各个结点上(会提示输入密码,输入slave1相应的密码即可):
scp /usr/hadoop/.ssh/authorized_keys hadoop@slave1:/home/master/.ssh
/usr/bin/ssh-copy-id: INFO: attempting to log in with the new key(s), to filter out any that are already installed
/usr/bin/ssh-copy-id: INFO: 1 key(s) remain to be installed -- if you are prompted now it is to install the new keys
hadoop@slave1's password:
Number of key(s) added: 1
Now try logging into the machine, with: "ssh 'hadoop@slave1'" and check to make sure that only the key(s) you wanted were added.
[hadoop@hadoop-master .ssh]$
然后在各个节点对authorized_keys执行(一定要执行该步,否则会报错):chmod 600 authorized_keys
保证.ssh 700,.ssh/authorized_keys 600权限
测试如下(第一次ssh时会提示输入yes/no,输入yes即可):
[hadoop@hadoop-master ~]$ ssh hadoop@slave1

Last login: Fri Feb  ::

[hadoop@slave1 ~]$
[hadoop@slave1 ~]$ exit
logout
Connection to slave1 closed.
[hadoop@hadoop-master ~]$
2.4 设置Hadoop的环境变量
Master及slave1都需操作
[root@hadoop-master ~]#  su - root

[root@hadoop-master ~]#  vi /etc/profile  末尾添加,保证任何路径下可执行hadoop命令

JAVA_HOME=/usr/java/jdk1..0_79

CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

PATH=/usr/hadoop/hadoop-2.7./bin:$JAVA_HOME/bin:$PATH
让设置生效
[root@hadoop-master ~]# source /etc/profile

或者

[root@hadoop-master ~]# . /etc/profile
Master设置hadoop环境
su - hadoop
1 # vi etc/hadoop/hadoop-env.sh   新增以下内容

2 export   JAVA_HOME=/usr/java/jdk1..0_79

 export   HADOOP_HOME=/usr/hadoop/hadoop-2.7.
此时hadoop安装已完成,可执行hadoop命令,后续步骤为集群部署
[hadoop@hadoop-master ~]$ hadoop

Usage: hadoop [--config confdir] [COMMAND | CLASSNAME]

  CLASSNAME            run the class named CLASSNAME

 or

  where COMMAND is one of:

  fs                   run a generic filesystem user client

  version              print the version

  jar <jar>            run a jar file

                       note: please use "yarn jar" to launch

                             YARN applications, not this command.

  checknative [-a|-h]  check native hadoop and compression libraries availability

  distcp <srcurl> <desturl> copy file or directories recursively

  archive -archiveName NAME -p <parent path> <src>* <dest> create a hadoop archive

  classpath            prints the class path needed to get the

  credential           interact with credential providers

                       Hadoop jar and the required libraries

  daemonlog            get/set the log level for each daemon

  trace                view and modify Hadoop tracing settings

Most commands print help when invoked w/o parameters.

[hadoop@hadoop-master ~]$
2.5 Hadoop设定
2.5.0 开放端口50070
注:centos7版本对防火墙进行 加强,不再使用原来的iptables,启用firewall
Master节点:
su - root

firewall-cmd --state 查看状态(若关闭,则先开启systemctl start firewalld)

firewall-cmd --list-ports 查看已开放的端口

开启8000端口:firewall-cmd --zone=public(作用域) --add-port=/tcp(端口和访问类型) --permanent(永久生效)

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --zone=public --add-port=/tcp --permanent

firewall-cmd --reload -重启防火墙

firewall-cmd --list-ports 查看已开放的端口

systemctl stop firewalld.service停止防火墙

systemctl disable firewalld.service禁止防火墙开机启动

关闭端口:firewall-cmd --zone= public --remove-port=/tcp --permanent
Slave1节点:
su - root
systemctl stop firewalld.service停止防火墙

systemctl disable firewalld.service禁止防火墙开机启动
2.5.1 在Master节点的设定文件中指定Slave节点
[hadoop@hadoop-master hadoop]$ pwd

/usr/hadoop/hadoop-2.7./etc/hadoop

[hadoop@hadoop-master hadoop]$ vi slaves

slave1
2.5.2 在各节点指定HDFS文件存储的位置(默认是/tmp)
Master节点: namenode
创建目录并赋予权限
Su - root

# mkdir -p   /usr/local/hadoop-2.7./tmp/dfs/name

# chmod -R    /usr/local/hadoop-2.7./tmp

# chown   -R hadoop:hadoop /usr/local/hadoop-2.7.
Slave节点:datanode
创建目录并赋予权限,改变所有者
Su - root

# mkdir -p   /usr/local/hadoop-2.7./tmp/dfs/data

# chmod -R    /usr/local/hadoop-2.7./tmp

# chown -R   hadoop:hadoop /usr/local/hadoop-2.7.
2.5.3 在Master中设置配置文件(包括yarn)
su - hadoop
 1 # vi   etc/hadoop/core-site.xml

 <configuration>

 <property>

         <name>fs.default.name</name>

         <value>hdfs://hadoop-master:9000</value>

     </property>

 <property>

           <name>hadoop.tmp.dir</name>

           <value>/usr/local/hadoop-2.7./tmp</value>

     </property>

 </configuration>
 # vi   etc/hadoop/hdfs-site.xml

 <configuration>

 <property>

         <name>dfs.replication</name>

       <value></value>

 </property>

   <property>

       <name>dfs.name.dir</name>

         <value>/usr/local/hadoop-2.7./tmp/dfs/name</value>

 </property>

     <property>

       <name>dfs.data.dir</name>

       <value>/usr/local/hadoop-2.7./tmp/dfs/data</value>

     </property>

 </configuration>
 #cp mapred-site.xml.template   mapred-site.xml

 # vi   etc/hadoop/mapred-site.xml

 <configuration>

     <property>

         <name>mapreduce.framework.name</name>

         <value>yarn</value>

     </property>

 </configuration>
YARN设定
yarn的组成(Master节点: resourcemanager ,Slave节点: nodemanager)
以下仅在master操作,后面步骤会统一分发至salve1。
 # vi   etc/hadoop/yarn-site.xml

 <configuration>

     <property>

         <name>yarn.resourcemanager.hostname</name>

         <value>hadoop-master</value>

     </property>

     <property>

         <name>yarn.nodemanager.aux-services</name>

         <value>mapreduce_shuffle</value>

     </property>

 </configuration>
2.5.4将Master的文件分发至slave1节点。
cd /usr/hadoop

scp -r  hadoop-2.7. hadoop@hadoop-master:/usr/hadoop
2.5.5 Master上启动job history server,Slave节点上指定
此步2.5.5可跳过
Mater:
启动jobhistory daemon
# sbin/mr-jobhistory-daemon.sh start historyserver
确认
# jps
访问Job History Server的web页面
http://localhost:19888/
Slave节点:
 # vi   etc/hadoop/mapred-site.xml

     <property>

         <name>mapreduce.jobhistory.address</name>

         <value>hadoop-master:</value>

     </property>
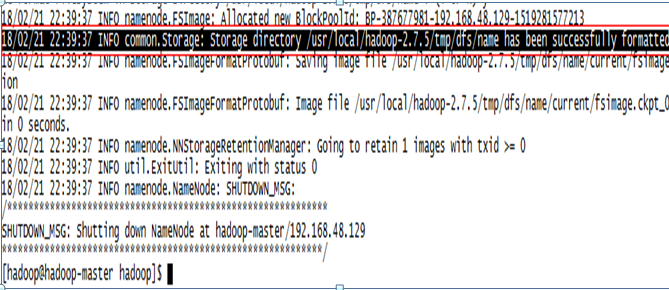
2.5.6 格式化HDFS(Master)
# hadoop namenode -format
Master结果:
2.5.7 在Master上启动daemon,Slave上的服务会一起启动
启动:
[hadoop@hadoop-master hadoop-2.7.]$ pwd

/usr/hadoop/hadoop-2.7.[hadoop@hadoop-master hadoop-2.7.]$ sbin/start-all.sh

This script is Deprecated. Instead use start-dfs.sh and start-yarn.sh

Starting namenodes on [hadoop-master]

hadoop-master: starting namenode, logging to /usr/hadoop/hadoop-2.7./logs/hadoop-hadoop-namenode-hadoop-master.out

slave1: starting datanode, logging to /usr/hadoop/hadoop-2.7./logs/hadoop-hadoop-datanode-slave1.out

Starting secondary namenodes [0.0.0.0]

0.0.0.0: starting secondarynamenode, logging to /usr/hadoop/hadoop-2.7./logs/hadoop-hadoop-secondarynamenode-hadoop-master.out

starting yarn daemons

starting resourcemanager, logging to /usr/hadoop/hadoop-2.7./logs/yarn-hadoop-resourcemanager-hadoop-master.out

slave1: starting nodemanager, logging to /usr/hadoop/hadoop-2.7./logs/yarn-hadoop-nodemanager-slave1.out

[hadoop@hadoop-master hadoop-2.7.]$
确认
Master节点:
[hadoop@hadoop-master hadoop-2.7.]$ jps

 NameNode

 SecondaryNameNode

 Jps

 ResourceManager
Slave节点:
[hadoop@slave1 ~]$ jps

 NodeManager

 Jps

 DataNode
停止(需要的时候再停止,后续步骤需running状态):
[hadoop@hadoop-master hadoop-2.7.5]$ sbin/stop-all.sh

This script is Deprecated. Instead use stop-dfs.sh and stop-yarn.sh

Stopping namenodes on [hadoop-master]

hadoop-master: stopping namenode

slave1: stopping datanode

Stopping secondary namenodes [0.0.0.0]

0.0.0.0: stopping secondarynamenode

stopping yarn daemons

stopping resourcemanager

slave1: stopping nodemanager

no proxyserver to stop
2.5.8 创建HDFS
# hdfs dfs -mkdir /user

# hdfs dfs -mkdir   /user/test22
2.5.9 拷贝input文件到HDFS目录下
# hdfs dfs -put etc/hadoop/*.sh /user/test22/input
查看
# hdfs dfs -ls /user/test22/input
2.5.10 执行hadoop job
统计单词的例子,此时的output是hdfs中的目录,hdfs dfs -ls可查看
# hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7..jar wordcount /user/test22/input output
确认执行结果
# hdfs dfs -cat output/*
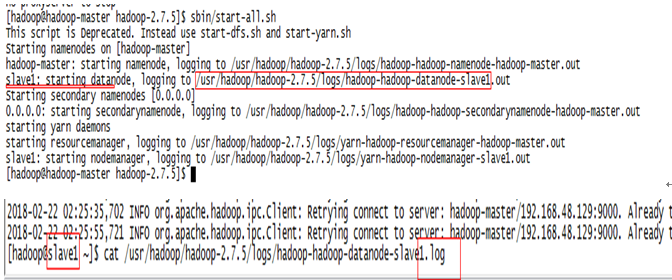
2.5.11 查看错误日志
注:日志在salve1的*.log中而不是在master或*.out中
2.6 Q&A
1. hdfs dfs -put 报错如下,解决关闭master&salve防火墙
hdfs.DFSClient: Exception in createBlockOutputStream
java.net.NoRouteToHostException: No route to host
centos7+hadoop完全分布式集群搭建的更多相关文章
- hadoop伪分布式集群搭建与安装(ubuntu系统)
1:Vmware虚拟软件里面安装好Ubuntu操作系统之后使用ifconfig命令查看一下ip; 2:使用Xsheel软件远程链接自己的虚拟机,方便操作.输入自己ubuntu操作系统的账号密码之后就链 ...
- Hadoop完全分布式集群搭建
Hadoop的运行模式 Hadoop一般有三种运行模式,分别是: 单机模式(Standalone Mode),默认情况下,Hadoop即处于该模式,使用本地文件系统,而不是分布式文件系统.,用于开发和 ...
- 大数据之Hadoop完全分布式集群搭建
1.准备阶段 1.1.新建三台虚拟机 Hadoop完全分市式集群是典型的主从架构(master-slave),一般需要使用多台服务器来组建.我们准备3台服务器(关闭防火墙.静态IP.主机名称).如果没 ...
- 基于Hadoop伪分布式集群搭建Spark
一.前置安装 1)JDK 2)Hadoop伪分布式集群 二.Scala安装 1)解压Scala安装包 2)环境变量 SCALA_HOME = C:\ProgramData\scala-2.10.6 P ...
- Hadoop学习笔记(一):ubuntu虚拟机下的hadoop伪分布式集群搭建
hadoop百度百科:https://baike.baidu.com/item/Hadoop/3526507?fr=aladdin hadoop官网:http://hadoop.apache.org/ ...
- hadoop HA分布式集群搭建
概述 hadoop2中NameNode可以有多个(目前只支持2个).每一个都有相同的职能.一个是active状态的,一个是standby状态的.当集群运行时,只有active状态的NameNode是正 ...
- 1、hadoop HA分布式集群搭建
概述 hadoop2中NameNode可以有多个(目前只支持2个).每一个都有相同的职能.一个是active状态的,一个是standby状态的.当集群运行时,只有active状态的NameNode是正 ...
- hadoop 完全分布式集群搭建
1.在伪分布式基础上搭建,伪分布式搭建参见VM上Hadoop3.1伪分布式模式搭建 2.虚拟机准备,本次集群采用2.8.3版本与3.X版本差别不大,端口号所有差别 192.168.44.10 vmho ...
- linux运维、架构之路-Hadoop完全分布式集群搭建
一.介绍 Hadoop实现了一个分布式文件系统(Hadoop Distributed File System),简称HDFS.HDFS有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件 ...
随机推荐
- 【linux】之查看物理CPU个数、核数、逻辑CPU个数
# 总核数 = 物理CPU个数 X 每颗物理CPU的核数 # 总逻辑CPU数 = 物理CPU个数 X 每颗物理CPU的核数 X 超线程数 # 查看物理CPU个数 cat /proc/cpuinfo| ...
- Hadoop 管理工具HUE配置-Yarn Resource Manager HA配置
安装HUE之后,需要配置很多东西才能将这个系统的功能发挥出来,因为Yarn是配置的HA模式,所以在配置HUE的时候,会有些不用,下面一段文字是官网拿来的 # Configuration for YAR ...
- vue-router2.0
在使用vue.js创建单页运用的时候,我们通常的做法是配合vue-router一起使用,通过vue-router将组建映射到路由并进行渲染. 例如我们要实现两个页面的切换跳转,就需要使用路由,这里不再 ...
- Spring MVC + Mybatis项目搭建
1.参考<Java Spring MVC项目搭建(一)——Spring MVC框架集成>配置spring mvc需要的jar包及eclipse配置(主要是针对servlet-api.jar ...
- 小程序踩坑异步请求json时,headers设置 "content-type": "application/x-www-form-urlencoded"
wx.request({ url: url, method:params.method, data: params.data, header: { "content-type": ...
- 基于JMX动态配置Log4J日志级别
先来看比较low的修改日志级别的方式,在写程序里面. http://blog.gssxgss.me/java%E8%BF%90%E8%A1%8C%E6%97%B6%E5%8A%A8%E6%80%81% ...
- android判断adb调试是否打开及代码跳转到开发者选项界面
boolean enableAdb = (Settings.Secure.getInt(getContentResolver(), Settings.Secure.ADB_ENABLED, 0) &g ...
- Gini系数的原理
转载:https://blog.csdn.net/u010665216/article/details/78528261 首先,我们直接构造赛题结果:真实数据与预测数据: predictions = ...
- mysql 5.7主从库复制设置
先要修改配置文件,重启mysql服务 log-bin= mysql-binlog # 打开二进制日志 ,最好放在不同的硬盘上,减小 IO 消耗 expire_logs_day= # 设置二进制日志保存 ...
- JS一个算法题
题目:实现超出整数存储范围的两个大整数想加function(a,b).注意:参数a和b以及函数返回值都是字符串. 目的:考算法, 基本逻辑. 我实现的基本思路是: ①两个数字字符串长度补成一样,用字符 ...