
大数据之路Week10_day04 (Hbase的二级索引,二级索引的本质就是建立各列值与行键之间的映射关系)
二级索引的本质就是建立各列值与行键之间的映射关系
HBASE是在hadoop之上构建非关系型,面向列存储的开源分布式结构化数据存储系统。
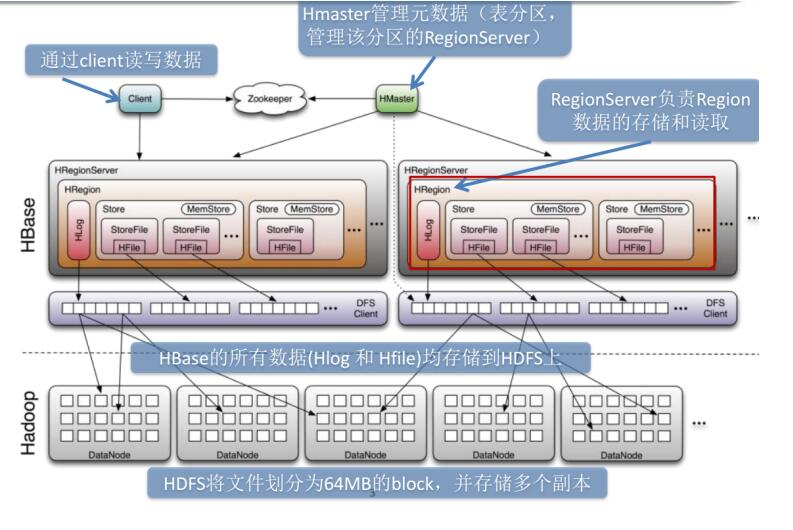
Hbase的局限性:
HBase本身只提供基于行键和全表扫描的查询,而行键索引单一,对于多维度的查询困难。
所以我们引进一个二级索引的概念
常见的二级索引:
HBase的一级索引就是rowkey,我们只能通过rowkey进行检索。如果我们相对hbase里面列族的列列进行一些组合查询,就需要采用HBase的二级索引方案来进行多条件的查询。
1. MapReduce方案
2. ITHBASE(Indexed-Transanctional HBase)方案
3. IHBASE(Index HBase)方案
4. Hbase Coprocessor(协处理器)方案
5. Solr+hbase方案
6. CCIndex(complementalclustering index)方案
二级索引的种类
1、创建单列索引
2、同时创建多个单列索引
3、创建联合索引(最多同时支持3个列)
4、只根据rowkey创建索引
单表建立二级索引
1.首先disable ‘表名’

2.然后修改表

alter 'LogTable',METHOD=>'table_att','coprocessor'=>'hdfs:///写好的Hbase协处理器(coprocessor)的jar包名|类的绝对路径名|1001'

3. enable '表名'
二级索引的设计思路

二级索引的本质就是建立各列值与行键之间的映射关系
如上图1,当要对F:C1这列建立索引时,只需要建立F:C1各列值到其对应行键的映射关系,如C11->RK1等,这样就完成了对F:C1列值的二级索引的构建,当要查询符合F:C1=C11对应的F:C2的列值时(即根据C1=C11来查询C2的值,图1青色部分)
其查询步骤如下:
1. 根据C1=C11到索引数据中查找其对应的RK,查询得到其对应的RK=RK1
2. 得到RK1后就自然能根据RK1来查询C2的值了 这是构建二级索引大概思路,其他组合查询的联合索引的建立也类似。
Mapreduce的方式创建二级索引
使用整合MapReduce的方式创建hbase索引。主要的流程如下:
1.1扫描输入表,使用hbase继承类TableMapper
1.2获取rowkey和指定字段名称和字段值
1.3创建Put实例, value=” “, rowkey=班级,column=学号
1.4使用IdentityTableReducer将数据写入索引表
实例:
1、在hbase中创建索引表 student_index
create 'student_index','info'
2、编写mapreduce代码
package com.wyh.Hbase_MR;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.hbase.client.Put;

import org.apache.hadoop.hbase.client.Result;

import org.apache.hadoop.hbase.client.Scan;

import org.apache.hadoop.hbase.io.ImmutableBytesWritable;

import org.apache.hadoop.hbase.mapreduce.TableMapReduceUtil;

import org.apache.hadoop.hbase.mapreduce.TableMapper;

import org.apache.hadoop.hbase.mapreduce.TableReducer;

import org.apache.hadoop.hbase.util.Bytes;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import java.io.IOException;

/**

 * 建立索引表

 *

 */

public class HbaseToIndex {

    /**

     * Map段 将读取到的数据,设置班级+学号当作key

     */

    public static class IndexMap extends TableMapper<Text,NullWritable>{

        @Override

        protected void map(ImmutableBytesWritable key, Result value, Context context) throws IOException, InterruptedException {

            String id = Bytes.toString(key.get());

            String clazz = Bytes.toString(value.getValue("info".getBytes(), "clazz".getBytes()));

            String key1 = id+"_"+clazz;

            context.write(new Text(key1),NullWritable.get());

        }

    }

    /**

     * Reduce段 获取Map传过来的key

     */

    public static class IndexReduce extends TableReducer<Text,NullWritable,NullWritable>{

        @Override

        protected void reduce(Text key, Iterable<NullWritable> values, Context context) throws IOException, InterruptedException {

            String[] split = key.toString().split("_");

            String id = split[0];

            String clazz = split[1];

            Put put = new Put(clazz.getBytes());

            put.add("info".getBytes(),id.getBytes(),"".getBytes());

            context.write(NullWritable.get(),put);

        }

    }

    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {

        Configuration conf = new Configuration();

        conf.set("hbase.zookeeper.quorum","master:2181,node1:2181,node2:2181");

        Job job = Job.getInstance(conf);

        job.setJobName("HbaseToIndex");

        job.setJarByClass(HbaseToIndex.class);

        Scan scan = new Scan();

        scan.addFamily("info".getBytes());

        TableMapReduceUtil.initTableMapperJob("students",scan,IndexMap.class,Text.class,NullWritable.class,job);

        TableMapReduceUtil.initTableReducerJob("student_index",IndexReduce.class,job);

        job.waitForCompletion(true);

    }

}
3、打成jar包上传到hadoop中运行
hadoop jar hadoop-1.0-SNAPSHOT-jar-with-dependencies.jar com.wyh.Hbase_MR.HbaseToIndex
4、编写查询代码,测试结果
package com.wyh.Hbase_MR;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.hbase.Cell;

import org.apache.hadoop.hbase.CellUtil;

import org.apache.hadoop.hbase.client.*;

import org.apache.hadoop.hbase.util.Bytes;

import org.junit.After;

import org.junit.Before;

import org.junit.Test;

import java.io.IOException;

import java.util.ArrayList;

import java.util.List;

public class OpIndex {

    private Configuration conf;

    private HConnection connection;

    private HBaseAdmin admin;

    /**

     * 连接到Hbase

     */

    @Before

    public void Cline(){

        try {

            conf = new Configuration();

            conf.set("hbase.zookeeper.quorum","master:2181,node1:2181,node2:2181");

            connection = HConnectionManager.createConnection(conf);

            admin = new HBaseAdmin(conf);

            System.out.println("建立连接成功。。。"+connection);

        } catch (IOException e) {

            e.printStackTrace();

        }

    }

    /**

     * 通过索引表进行查询数据

     */

    @Test

    public void scanData(){

        try {

            //创建一个集合存放查询到的学号

            ArrayList<Get> gets = new ArrayList<>();

            //获取到索引表

            HTableInterface student_index = connection.getTable("student_index");

            Get get = new Get("理科二班".getBytes());

            Result result = student_index.get(get);

            List<Cell> cells = result.listCells();

            for (Cell cell : cells) {

                String id = Bytes.toString(CellUtil.cloneQualifier(cell));

                gets.add(new Get(id.getBytes()));

            }

            //获取到学生表

            HTableInterface students = connection.getTable("students");

            Result[] results = students.get(gets);

            for (Result result1 : results) {

                String id = Bytes.toString(result1.getRow());

                String name = Bytes.toString(result1.getValue("info".getBytes(), "name".getBytes()));

                String age = Bytes.toString(result1.getValue("info".getBytes(), "age".getBytes()));

                String gender = Bytes.toString(result1.getValue("info".getBytes(), "gender".getBytes()));

                String clazz = Bytes.toString(result1.getValue("info".getBytes(), "clazz".getBytes()));

                System.out.println(id+"\t"+name+"\t"+age+"\t"+gender+"\t"+clazz);

            }

        } catch (IOException e) {

            e.printStackTrace();

        }

    }

    @After

    public void Close(){

        if(admin!=null){

            try {

                admin.close();

                System.out.println("admin已经关闭。。。。");

            } catch (IOException e) {

                e.printStackTrace();

            }

        }

        if(connection!=null){

            try {

                connection.close();

                System.out.println("connection已经关闭。。。。");

            } catch (IOException e) {

                e.printStackTrace();

            }

        }

    }

}
运行结果:

大数据之路Week10_day04 (Hbase的二级索引,二级索引的本质就是建立各列值与行键之间的映射关系)的更多相关文章
- 大数据学习系列之—HBASE
hadoop生态系统 zookeeper负责协调 hbase必须依赖zookeeper flume 日志工具 sqoop 负责 hdfs dbms 数据转换 数据到关系型数据库转换 大数据学习群119 ...
- MongoDB 大数据技术之mongodb中在嵌套子文档的文档上面建立索引
一.给collection objectid赋自定义的值 MongoDB Enterprise > db.testid.insert({_id:{imsi:"4567890123&qu ...
- 胖子哥的大数据之路(6)- NoSQL生态圈全景介绍
引言: NoSQL高级培训课程的基础理论篇的部分课件,是从一本英文原著中做的摘选,中文部分参考自互联网.给大家分享. 正文: The NoSQL Ecosystem 目录 The NoSQL Eco ...
- 大数据时代数据库-云HBase架构&生态&实践
业务的挑战 存储量量/并发计算增大 现如今大量的中小型公司并没有大规模的数据,如果一家公司的数据量超过100T,且能通过数据产生新的价值,基本可以说是大数据公司了 .起初,一个创业公司的基本思路就是首 ...
- 大数据核心知识点:Hbase、Spark、Hive、MapReduce概念理解,特点及机制
今天,上海尚学堂大数据培训班毕业的一位学生去参加易普软件公司面试,应聘的职位是大数据开发.面试官问了他10个问题,主要集中在Hbase.Spark.Hive和MapReduce上,基础概念.特点.应用 ...
- 大数据-05-Spark之读写HBase数据
本文主要来自于 http://dblab.xmu.edu.cn/blog/1316-2/ 谢谢原作者 准备工作一:创建一个HBase表 这里依然是以student表为例进行演示.这里假设你已经成功安装 ...
- 胖子哥的大数据之路(7)- 传统企业切入核心or外围
一.引言 昨天和一个做互联网大数据(零售行业)的朋友交流,关于大数据传统企业实施的切入点产生了争执,主要围绕两个问题进行了深入的探讨: 问题1:对于一个传统企业而言什么是核心业务,什么是外围业务? 问 ...
- 胖子哥的大数据之路(四)- VisualHBase功能需求框架
一.引言 大数据在结构化数据存储方面的应用需求越来越明确,但是大数据环境下辅助开发工具的不完善,给数据库管理人员和开发人员带来的不变难以言表,基于此创建了开源项目VisualHBase,同时创建了Vi ...
- 大数据之路week06--day07(Hadoop生态圈的介绍)
Hadoop 基本概念 一.Hadoop出现的前提环境 随着数据量的增大带来了以下的问题 (1)如何存储大量的数据? (2)怎么处理这些数据? (3)怎样的高效的分析这些数据? (4)在数据增长的情况 ...
- 大数据之路week04--day06(I/O流阶段一 之异常)
从这节开始,进入对I/O流的系统学习,I/O流在往后大数据的学习道路上尤为重要!!!极为重要,必须要提起重视,它与集合,多线程,网络编程,可以说在往后学习或者是工作上,起到一个基石的作用,没了地基,房 ...
随机推荐
- 【Amadeus原创】centos中挖矿病毒kdevtmpfsi的终极解决方法
试了很久,最终的解决方法如下: 1,编写sh脚本:rm_wk.sh #!/bin/bash PATH=/bin:/sbin:/usr/bin:/usr/sbin:/usr/local/bin:/usr ...
- 基于SpringMVC XML配置文件的Dubbo开发与使用
[模块一] 首先引入Dubbo的依赖资源,这里我们使用基于SpringMVC的项目于Dubbo进行整合 先进行依赖导入. pom.xml <!--zookeeper--> ...
- LocalDateTime 简述
Java 8 更新的部分内容中,有一部分代替了以往比较难用的 java.util.Date 类,并且创建了一套新的时间类型,该类型为: java.time.LocalDateTime. LocalDa ...
- CentOS7 安装git 配置秘钥公钥克隆代码
建议购买阿里云香港服务器可以免备案,系统镜像选择CentOS7测试 第一步:安装git客户端,默认安装在/usr/libexec/git-core目录 yum -y install git #查看版本 ...
- Qt/C++音视频开发63-设置视频旋转角度/支持0-90-180-270度旋转/自定义旋转角度
一.前言 设置旋转角度,相对来说是一个比较小众的需求,如果视频本身带了旋转角度,则解码播放的时候本身就会旋转到对应的角度显示,比如手机上拍摄的视频一般是旋转了90度的,如果该视频文件放到电脑上打开,一 ...
- Qt/C++开发经验小技巧286-290
国内站点:https://gitee.com/feiyangqingyun 国际站点:https://github.com/feiyangqingyun 很多时候项目越写越大,然后就可能遇到,明明之前 ...
- IM跨平台技术学习(十一):环信基于Electron打包Web IM桌面端的技术实践
本文由环信技术黄飞鹏分享,原题"实战|如何利用 Electron 快速开发一个桌面端应用",本文进行了排版和内容优化等. 1.引言 早就听说利用Electron可以非常便捷的将网页 ...
- 如何像专家一样高效使用 Google 搜索
如何像专家一样高效使用 Google 搜索 你几乎可以在互联网上搜索到任何内容,而Google是大多数人选择搜索信息的主要途径之一. 尽管频繁地使用Google,但是大部分互联网用户都不知道如何快速和 ...
- 《深入理解Mybatis原理》MyBatis的sqlSession执行流程
sqlSessionFactory 与 SqlSession 正如其名,Sqlsession对应着一次数据库会话.由于数据库会话不是永久的,因此Sqlsession的生命周期也不应该是永久的,相反,在 ...
- 记录实现倒计时的方法,配合按钮的disabled
记录一个自己实现倒计时的方法,现在可以网上有很多插件,自己实现记录一下 // 倒计时 countDown() { this.disabled = true let number = 60 this.c ...