
一起学Hadoop——使用自定义Partition实现hadoop部分排序
 public class PartSortMap extends Mapper<LongWritable,Text,Text,Text> {

     public void map(LongWritable key,Text value,Context context)throws IOException,InterruptedException{

         String line = value.toString();//读取一行数据,数据格式为“Apple 201701 30”

         String str[] = line.split(" ");//

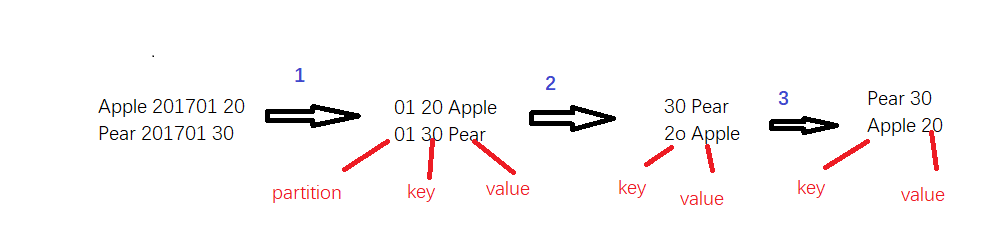
         //年月当做key值,因为要根据key值设置分区,而Apple+“_”+销量当做value

         context.write(new Text(str[1]),new Text(str[0] + "_" + str[2]));

     }

 }
 public class PartParttition extends Partitioner<Text, Text> {

     public int getPartition(Text arg0, Text arg1, int arg2) {

         String key = arg0.toString();

         int month = Integer.parseInt(key.substring(4, key.length()));

         if (month == 1) {

             return 1 % arg2;

         } else if (month == 2) {

             return 2 % arg2;

         } else if (month == 3) {

             return 3 % arg2;

         }else if (month == 4) {

             return 4 % arg2;

         }else if (month == 5) {

             return 5 % arg2;

         }else if (month == 6) {

             return 6 % arg2;

         }else if (month == 7) {

             return 7 % arg2;

         }else if (month == 8) {

             return 8 % arg2;

         }else if (month == 9) {

             return 9 % arg2;

         }else if (month == 10) {

             return 10 % arg2;

         }else if (month == 11) {

             return 11 % arg2;

         }else if (month == 12) {

             return 12 % arg2;

         }

         return 0;

     }

 }
 public class PartSortReduce extends Reducer<Text,Text,Text,Text> {

     class FruitSales implements  Comparable<FruitSales>{

         private String name;//水果名字

         private double sales;//水果销量

         public void setName(String name){

             this.name = name;

         }

         public String getName(){

             return this.name;

         }

         public void setSales(double sales){

             this.sales = sales;

         }

         public double getSales() {

             return this.sales;

         }

         @Override

         public int compareTo(FruitSales o) {

             if(this.getSales() > o.getSales()){

                 return -1;

             }else if(this.getSales() == o.getSales()){

                 return 0;

             }else {

                 return 1;

             }

         }

     }

     public void reduce(Text key, Iterable<Text> values,Context context)throws IOException,InterruptedException{

         List<FruitSales> fruitList = new ArrayList<FruitSales>();

         for(Text value: values) {

             String[] str = value.toString().split("_");

             FruitSales f = new FruitSales();

             f.setName(str[0]);

             f.setSales(Double.parseDouble(str[1]));

             fruitList.add(f);

         }

         Collections.sort(fruitList);

         for(FruitSales f : fruitList){

             context.write(new Text(f.getName()),new Text(String.valueOf(f.getSales())));

         }

     }

 }
 public class PartSortMain {

     public static void main(String[] args)throws Exception{

         Configuration conf = new Configuration();

         //获取运行时输入的参数,一般是通过shell脚本文件传进来。

         String [] otherArgs = new GenericOptionsParser(conf,args).getRemainingArgs();

         if(otherArgs.length < 2){

             System.err.println("必须输入读取文件路径和输出路径");

             System.exit(2);

         }

         Job job = new Job();

         job.setJarByClass(PartSortMain.class);

         job.setJobName("PartSort app");

         //设置读取文件的路径,都是从HDFS中读取。读取文件路径从脚本文件中传进来

         FileInputFormat.addInputPath(job,new Path(args[0]));

         //设置mapreduce程序的输出路径,MapReduce的结果都是输入到文件中

         FileOutputFormat.setOutputPath(job,new Path(args[1]));

         job.setPartitionerClass(PartParttition.class);//设置自定义partition类

         job.setNumReduceTasks(12);//设置为partiton数量

         //设置实现了map函数的类

         job.setMapperClass(PartSortMap.class);

         //设置实现了reduce函数的类

         job.setReducerClass(PartSortReduce.class);

         //设置reduce函数的key值

         job.setOutputKeyClass(Text.class);

         //设置reduce函数的value值

         job.setOutputValueClass(Text.class);

         System.exit(job.waitForCompletion(true) ? 0 :1);

     }

 }
 #!/usr/bin/python

 import sys

 base_numer = 99999

 for line in sys.stdin:

     ss = line.strip().split(' ')

     fruit = ss[0]

     yearmm = ss[1]

     sales = ss[2]

     new_key = base_number - int(sales)

     mm = yearmm[4:6]

     print "%s\t%s\t%s" % (int(mm), int(new_key), fruit)
 #!/usr/bin/python

 import sys

 base_number = 99999

 for line in sys.stdin:

     idx_id, sales, fruit = line.strip().split('\t')

     new_key = base_number -  int(sales)

     print '\t'.join([val, str(new_key)])
 set -e -x

 HADOOP_CMD="/usr/local/src/hadoop-2.6.1/bin/hadoop"

 STREAM_JAR_PATH="/usr/local/src/hadoop-2.6.1/share/hadoop/tools/lib/hadoop-streaming-2.6.1.jar"

 INPUT_FILE_PATH_A="/data/fruit.txt"

 OUTPUT_SORT_PATH="/output_sort"

 $HADOOP_CMD fs -rmr -skipTrash $OUTPUT_SORT_PATH

 $HADOOP_CMD jar $STREAM_JAR_PATH \

     -input $INPUT_FILE_PATH_A\

     -output $OUTPUT_SORT_PATH \

     -mapper "python map_sort.py" \

     -reducer "python reduce_sort.py" \

     -file ./map_sort.py \

     -file ./red_sort.py \

     -jobconf mapred.reduce.tasks= \

     -jobconf stream.num.map.output.key.fields= \

     -jobconf num.key.fields.for.partition= \

     -partitioner org.apache.hadoop.mapred.lib.KeyFieldBasedPartitioner
一起学Hadoop——使用自定义Partition实现hadoop部分排序的更多相关文章
- 2 weekend110的hadoop的自定义排序实现 + mr程序中自定义分组的实现
我想得到按流量来排序,而且还是倒序,怎么达到实现呢? 达到下面这种效果, 默认是根据key来排, 我想根据value里的某个排, 解决思路:将value里的某个,放到key里去,然后来排 下面,开始w ...
- Hadoop mapreduce自定义分区HashPartitioner
本文发表于本人博客. 在上一篇文章我写了个简单的WordCount程序,也大致了解了下关于mapreduce运行原来,其中说到还可以自定义分区.排序.分组这些,那今天我就接上一次的代码继续完善实现自定 ...
- hadoop的自定义数据类型和与关系型数据库交互
最近有一个需求就是在建模的时候,有少部分数据是postgres的,只能读取postgres里面的数据到hadoop里面进行建模测试,而不能导出数据到hdfs上去. 读取postgres里面的数据库有两 ...
- commoncrawl 源码库是用于 Hadoop 的自定义 InputFormat 配送实现
commoncrawl 源码库是用于 Hadoop 的自定义 InputFormat 配送实现. Common Crawl 提供一个示例程序 BasicArcFileReaderSample.java ...
- Hadoop mapreduce自定义分组RawComparator
本文发表于本人博客. 今天接着上次[Hadoop mapreduce自定义排序WritableComparable]文章写,按照顺序那么这次应该是讲解自定义分组如何实现,关于操作顺序在这里不多说了,需 ...
- 大数据学习笔记之Hadoop(一):Hadoop入门
文章目录 大数据概论 一.大数据概念 二.大数据的特点 三.大数据能干啥? 四.大数据发展前景 五.企业数据部的业务流程分析 六.企业数据部的一般组织结构 Hadoop(入门) 一 从Hadoop框架 ...
- 《Hadoop》对于高级编程Hadoop实现构建企业级安全解决方案
本章小结 ● 理解企业级应用的安全顾虑 ● 理解Hadoop尚未为企业级应用提供的安全机制 ● 考察用于构建企业级安全解决方式的方法 第10章讨论了Hadoop安全性以及Hadoop ...
- [BigData - Hadoop - YARN] YARN:下一代 Hadoop 计算平台
Apache Hadoop 是最流行的大数据处理工具之一.它多年来被许多公司成功部署在生产中.尽管 Hadoop 被视为可靠的.可扩展的.富有成本效益的解决方案,但大型开发人员社区仍在不断改进它.最终 ...
- hadoop分布式存储(2)-hadoop的安装(毕业设计)
总共分三步:1.准备linux环境 租用"云主机",阿里云,unitedStack等,云主机不受本机性能影响(或者直接安转linux操作系统或者虚拟机也行): PuTTy Conf ...
随机推荐
- HTML中添加音乐video embed audio
做H5页面时需要添加背景音乐,方法如下 方式一:<video controls="" autoplay="" name="media" ...
- 基于Hadoop2.7.3集群数据仓库Hive1.2.2的部署及使用
基于Hadoop2.7.3集群数据仓库Hive1.2.2的部署及使用 HBase是一种分布式.面向列的NoSQL数据库,基于HDFS存储,以表的形式存储数据,表由行和列组成,列划分到列族中.HBase ...
- linux中shell变量$#,$@,$0,$1,$2的含义解释 (转载)
变量说明: $$Shell本身的PID(ProcessID)$!Shell最后运行的后台Process的PID$?最后运行的命令的结束代码(返回值)$-使用Set命令设定的Flag一览$*所有参数列表 ...
- 如何在eclipse中对项目进行重新编译
有时由于eclipse异常关闭,当我们重启Eclipse,在启动项目时,会报错,说:ClassNotFound类似的错误,引起这种问题的原因可能是由于,Eclipse异常关闭引起的. 解决:在一个项目 ...
- appium+java(五)微信小程序自动化测试实践
前言: 上一篇<appium+java(四)微信公众号自动化测试实践>中,尝试使用appium实现微信公众号自动化测试,接着尝试小程序自动化,以学院小程序为例 准备工作 1.java-cl ...
- [nodejs]er_bad_field_error NaN in where clause
1 前言 nodejs 运行时,出现以下情况er_bad_field_error NaN in where clause. 2 分析 原来是userid = NAN传进来了,生成userid时出错了. ...
- Boostrap轮图片可以左右滑动
记得引用Boostrap的js和css html代码: <div id="Mycarousel" class="carousel slide col-md-12&q ...
- GDOI2018 涛涛摘苹果 [CDQ分治]
传送门我会让你知道哪里有题面吗(逃 思路 显然不能模拟苹果下掉的过程,考虑计算每个苹果对询问的贡献. 显然一开始就有的苹果可以看做第0天变出来的,于是只需要考虑变出来的苹果了. 设当前询问节点\(x\ ...
- MySql两种存储引擎的区别
MyISAM是MySQL的默认数据库引擎(5.5版之前),由早期的ISAM(Indexed Sequential Access Method:有索引的顺序访问方法)所改良.虽然性能极佳,但却有一个缺点 ...
- Java 开源博客 Solo 2.5.0 发布
Java 开源博客 Solo 2.5.0 发布 Solo 是一款一个命令就能搭建好的 Java 开源博客系统,如果你想开个独立博客,请一定不要错过! 2.5.0 版本主要支持了 Markdown/JS ...