
Windows下基于python3使用word2vec训练中文维基百科语料(一)
在进行自然语言处理之前,首先需要一个语料,这里选择维基百科中文语料,由于维基百科是 .xml.bz2文件,所以要将其转换成.txt文件,下面就是相关步骤:
步骤一:下载维基百科中文语料
https://dumps.wikimedia.org/zhwiki/latest/zhwiki-latest-pages-articles.xml.bz2
然后解压文件

文件夹里是一个这个文件

步骤二:安装依赖库
我们需要安装一些依赖库,有numpy、scipy以及gensim,安装gensim依赖于scipy,安装scipy依赖于numpy。我们直接用pip安装numpy,在windows命令行下使用命令:
 pip install numpy

 pip install scipy

 pip install gensim
步骤三:将xml.bz2文件转换成.text文件
注意:我在网上找的代码,通常说会因为python2和python3的版本不同在使用python3进行解压会在output.write(space.join(text) + "\n")这一句出现提示关于byte或str的错误,
但是我用了python3修改的代码,反而出现错误,其实现在下载的语料直接用python2的代码也可以。
*********不过为了有些人可能采用下面代码会出现byte和str的错误,我将之前网上找的对于python3代码的修改依然保留(32-40行)***********************
(1)写代码 命名为process_wiki.py
 # -*- coding:utf-8 -*-

 # Author:Gao

 import logging

 import os.path

 import six

 import sys

 import warnings

 warnings.filterwarnings(action='ignore', category=UserWarning, module='gensim')

 from gensim.corpora import WikiCorpus

 if __name__ == '__main__':

     program = os.path.basename(sys.argv[0])

     logger = logging.getLogger(program)

     logging.basicConfig(format='%(asctime)s: %(levelname)s: %(message)s')

     logging.root.setLevel(level=logging.INFO)

     logger.info("running %s" % ' '.join(sys.argv))

     # check and process input arguments

     if len(sys.argv) != 3:

         print("Using: python process_wiki.py enwiki.xxx.xml.bz2 wiki.en.text")

         sys.exit(1)

     inp, outp = sys.argv[1:3]

     space = " "

     i = 0

     output = open(outp, 'w',encoding='utf-8')

     wiki = WikiCorpus(inp, lemmatize=False, dictionary={})

     for text in wiki.get_texts():

         # if six.PY3:

         #     output.write(b' '.join(text).decode('utf-8') + '\n')

         # else:

         #     output.write(space.join(text) + "\n")

         output.write(space.join(text) + "\n")

         i=i+1

         if (i%10000==0):

             logger.info("Saved " + str(i) + " articles")

     output.close()

     logger.info("Finished Saved " + str(i) + " articles")
(2)运行代码(在cmd中运行)
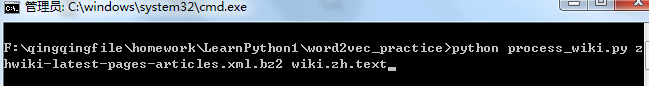
首先到自己下载的中文维基百科预料的文件夹下,将自己的语料库和执行文件放在同一个文件夹下,这样方便执行,然后进入放置这两个文件的文件夹下(我的在f盘)
python process_wiki.py zhwiki-latest-pages-articles.xml.bz2 wiki.zh.text
(3)运行结果(运行时间比较长,耐心等待,后面就出结果啦)
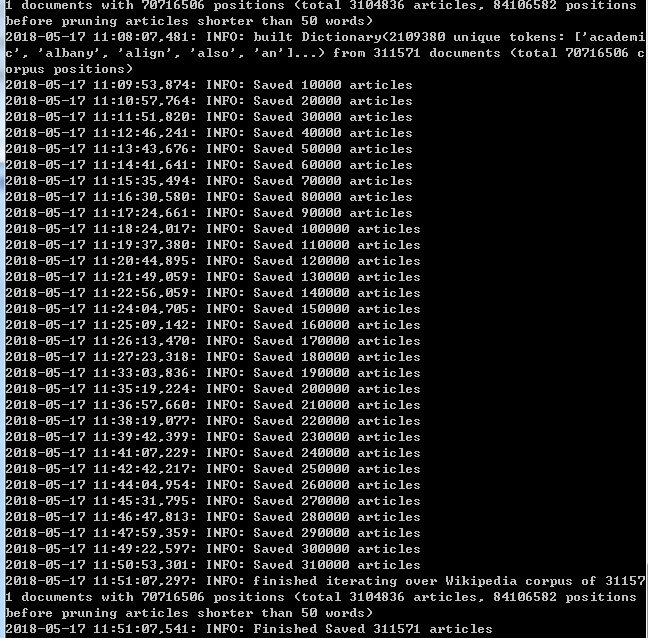
现在我们就得到了处理后的中文维基百科.txt文档,下一篇我们将进一步对文档进行处理
相关参考:https://www.jianshu.com/p/98d84854f7a3
Windows下基于python3使用word2vec训练中文维基百科语料(一)的更多相关文章
- Windows下基于python3使用word2vec训练中文维基百科语料(二)
在上一篇对中文维基百科语料处理将其转换成.txt的文本文档的基础上,我们要将为文本转换成向量,首先都要对文本进行预处理 步骤四:由于得到的中文维基百科中有许多繁体字,所以我们现在就是将繁体字转换成简体 ...
- Windows下基于python3使用word2vec训练中文维基百科语料(三)
对前两篇获取到的词向量模型进行使用: 代码如下: import gensim model = gensim.models.Word2Vec.load('wiki.zh.text.model') fla ...
- 使用word2vec对中文维基百科数据进行处理
一.下载中文维基百科数据https://dumps.wikimedia.org/zhwiki/并使用gensim中的wikicorpus解析提取xml中的内容 二.利用opencc繁体转简体 三.利用 ...
- Windows下基于Python3安装Ipython Notebook(即Jupyter)。python –m pip install XXX
1.安装Python3.x,注意修改环境变量path(追加上python安装目录,如:D:\Program Files\Python\Python36-32) 2.查看当前安装的第三方包:python ...
- windows下基于sublime text3的nodejs环境搭建
第一步:先安装sublime text3.详细教程可自行百度,这边不具体介绍了. 第二步.安装nodejs插件,有两种方式 第一种方式:直接下载https://github.com/tanepiper ...
- Windows下安装Python3.4.2
一.Windows下安装Python3.4.2 1.下载Windows下的Python3.4.2.exe 2.指定一个目录安装,然后下一步 3.配置环境变量包括Python.exe的文件.目录如下图所 ...
- 环境搭建文档——Windows下的Python3环境搭建
前言 背景介绍: 自己用Python开发了一些安卓性能自动化测试的脚本, 但是想要运行这些脚本的话, 本地需要Python的环境. 测试组的同事基本都没有安装Python环境, 于是乎, 我就想直接在 ...
- word2vec训练中文模型
-- 这篇文章是一个学习.分析的博客 --- 1.准备数据与预处理 首先需要一份比较大的中文语料数据,可以考虑中文的维基百科(也可以试试搜狗的新闻语料库).中文维基百科的打包文件地址为 https: ...
- Windows下基于http的git服务器搭建-gitstack
版权声明:若无来源注明,Techie亮博客文章均为原创. 转载请以链接形式标明本文标题和地址: 本文标题:Windows下基于http的git服务器搭建-gitstack 本文地址:http: ...
随机推荐
- hadoop fs 部分命令详解
1,Hadoop fs –fs [local | <file system URI>]:声明hadoop使用的文件系统,如果不声明的话,使用当前配置文件配置的,按如下顺序查找:hadoop ...
- 分享几个.Net计划任务组件
Quartz http://www.quartz-scheduler.net/ Hangfire http://hangfire.io/ Install-Package Hangfire 使用OWIN ...
- Hibernate使用详解(一)
一.前言 这些天都在为公司框架重构做准备,浏览了一下代码,挑了几个不熟或者没接触过的知识点进行攻坚,hibernate是其中之一.其实接触hibernate是在大学期间,应该是在2012年,已经201 ...
- [STL] vector基本用法
vector的数据安排以及操作方式,与array非常相似.两者的唯一区别在于空间的运用的灵活性.array是静态空间,一旦配置了就不能改变.vector是动态空间,随着元素的加入,它的内部机制会自行扩 ...
- ADO.NET中DataSet、DataTable、DataRow的数据复制方法
DataSet 对象是支持 ADO.NET的断开式.分布式数据方案的核心对象 ,用途非常广泛.我们很多时候需要使用其中的数据,比如取得一个DataTable的数据或者复制另一个DataTabe中的数据 ...
- Xcode开发技巧之code snippets(代码片段)
一.什么是代码片段 当在Xcode中输入dowhile并回车后,Xcode会出现下图所示的提示代码: 这就是代码片段,目的是使程序员以最快的速度输入常用的代码片段,提高编程效率.该功能是从Xcode4 ...
- Python 开篇及第一个Python程序
本节内容 python 简单介绍 python 2.x 或者python 3.x python 安装 第一个python程序 一.python简单介绍 python的创始人为吉多.范罗苏姆(Guido ...
- hdu 1596 find the safest road (最短路径)
find the safest road Time Limit: 10000/5000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Ot ...
- manacher算法详解+模板 P3805
前言: 记住manacher是一个很简单的算法. 首先我们来了解一下回文字串的定义:若一个字符串中的某一子串满足回文的性质,则称其是回文子串.(注意子串必须是连续的,而子序列是可以不连续的) 那么若给 ...
- Python面向对象—类的继承
一个子类可以继承父类的所有属性,不管是父类的数据属性还是方法. class Father(object): num = 0 def __init__(self): print "I'm Pa ...