
scrapy-redis 更改队列和分布式爬虫
这里分享两个技巧
1.scrapy-redis分布式爬虫
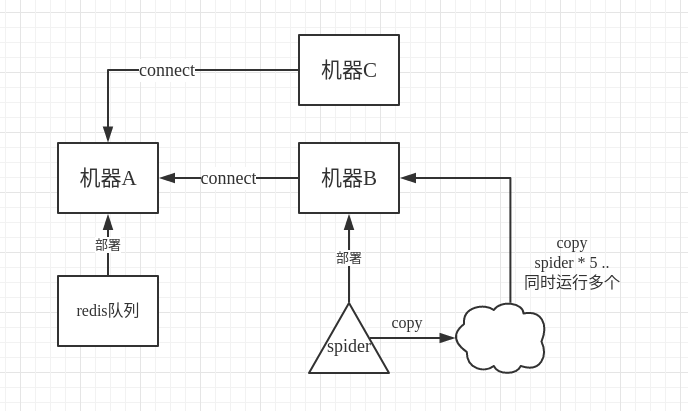
我们知道scrapy-redis的工作原理,就是把原来scrapy自带的queue队列用redis数据库替换,队列都在redis数据库里面了,每次存,取,删,去重,都在redis数据库里进行,那我们如何使用分布式呢,假设机器A有redis数据库,我们在A上把url push到redis里面,然后在机器B上启动scrapy-redis爬虫,在机器B上connect到A,有远程端口可以登入,在爬虫程序里,保存的时候注意启用追加模式,而不是每次保存都删除以前的东西,这样的话,我们可以在B上面多次运行同一个程序。
如图所示,其实连copy都不要,直接另开一个终端,接着运行同样的程序即可。
当然我们也可以在机器C上同样这样运行,所以这就是分布式爬虫。
2.队列不存url改为关键字。
我们的redis队列里保存的是url,正常情况下没毛病,当我们的url不是通过extract网页获取的时候,而是通过构造关键字得到的时候,而且关键字还是很大量的情况下,我们就没有必要在redis里面保存url了,而是直接保存关键字,这样省很大 的内存空间,我们把构造url的任务放到即将要request的时候进行。
当然,这里是改了源码的,如果想这么操作的话,建议在虚拟python环境下进行,安全可靠。
site-packages/scrapy_redis/spiders.py
    def make_request_from_data(self, data):

        """Returns a Request instance from data coming from Redis.

        By default, ``data`` is an encoded URL. You can override this method to

        provide your own message decoding.

        Parameters

        ----------

        data : bytes

            Message from redis.

        """

        data=data.split(',')

        if data[1]=='':

            a = data[0].strip()

            vb = {}

            vb['word'] = a

            vb['sid'] = 'e13f45a56c8e03b5a2262a6fcab43082'

            vb['pq'] = vb['word']

            url2 = 'https://sug.so.360.cn/suggest?callback=suggest_so&encodein=utf-8&encodeout=utf-8&format=json&fields=word'

            data2 = urllib.urlencode(vb)

            geturl2 = url2 + '&' + data2

        url = bytes_to_str(geturl2, self.redis_encoding)

        return self.make_requests_from_url(url)
而在我们的push程序里,是这样子了:
    for res in open(file_name,'r'):

        client.lpush('%s:start_urls' % redis_key, res+',360')
这里只改写了scrapy_redis/spiders.py文件里的类RedisMixin的 make_request_from_data 函数,人家作者吧接口单独预留了,让我们能够看得很清楚,还是很厉害的。
另外,scrapy-redis框架储存内容的时候,是以list形式 储存的,client.lpush ,redis关于list的操作详见 Redis 列表
scrapy-redis 更改队列和分布式爬虫的更多相关文章
- 基于Redis的三种分布式爬虫策略
前言: 爬虫是偏IO型的任务,分布式爬虫的实现难度比分布式计算和分布式存储简单得多. 个人以为分布式爬虫需要考虑的点主要有以下几个: 爬虫任务的统一调度 爬虫任务的统一去重 存储问题 速度问题 足够“ ...
- 基于docker+redis++urlib/request的分布式爬虫原理
一.整体思路及中心节点的配置 1.首先在虚拟机中运行一个docker,docker中运行的是一个linux系统,里面有我们所有需要的东西,linux系统,python,mysql,redis以及一些p ...
- scrapy分布式爬虫scrapy_redis一篇
分布式爬虫原理 首先我们来看一下scrapy的单机架构: 可以看到,scrapy单机模式,通过一个scrapy引擎通过一个调度器,将Requests队列中的request请求发给下载器,进行页 ...
- 【Python3爬虫】爬取美女图新姿势--Redis分布式爬虫初体验
一.写在前面 之前写的爬虫都是单机爬虫,还没有尝试过分布式爬虫,这次就是一个分布式爬虫的初体验.所谓分布式爬虫,就是要用多台电脑同时爬取数据,相比于单机爬虫,分布式爬虫的爬取速度更快,也能更好地应对I ...
- 【Python3爬虫】学习分布式爬虫第一步--Redis分布式爬虫初体验
一.写在前面 之前写的爬虫都是单机爬虫,还没有尝试过分布式爬虫,这次就是一个分布式爬虫的初体验.所谓分布式爬虫,就是要用多台电脑同时爬取数据,相比于单机爬虫,分布式爬虫的爬取速度更快,也能更好地应对I ...
- python3 分布式爬虫
背景 部门(东方IC.图虫)业务驱动,需要搜集大量图片资源,做数据分析,以及正版图片维权.前期主要用node做爬虫(业务比较简单,对node比较熟悉).随着业务需求的变化,大规模爬虫遇到各种问题.py ...
- 基于scrapy-redis的分布式爬虫
一.介绍 1.原生的scrapy框架 原生的scrapy框架是实现不了分布式的,其原因有: 1. 因为多台机器上部署的scrapy会各自拥有各自的调度器,这样就使得多台机器无法分配start_urls ...
- 爬虫--Scrapy-CrawlSpider&基于CrawlSpide的分布式爬虫
CrawlSpider 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调par ...
- 基于Python,scrapy,redis的分布式爬虫实现框架
原文 http://www.xgezhang.com/python_scrapy_redis_crawler.html 爬虫技术,无论是在学术领域,还是在工程领域,都扮演者非常重要的角色.相比于其他 ...
随机推荐
- 区间DP的思路(摘自NewErA)及自己的心得
以下为摘要 区间dp能解决的问题就是通过小区间更新大区间,最后得出指定区间的最优解 个人认为,想要用区间dp解决问题,首先要确定一个大问题能够剖分成几个相同较小问题,且小问题很容易组合成大问题,从而从 ...
- VS批处理命令使用
在项目开始生成或者生成完成后想做一些操作,比如去编译非解决方案下的的项目,完成编译后复制文件到某个文件夹之类的纠结需求. 1. 基本使用 预先生成事件命令行,可以在项目编译的过程中运行 后期生成事件命 ...
- python---CRM用户关系管理
Day1:项目分析 一:需求分析 二:CRM角色功能介绍 三:业务场景分析 销售: .销售A 从百度推广获取了一个客户,录入了CRM系统,咨询了Python课程,但是没有报名 .销售B 从qq群获取一 ...
- ip地址、子网掩码、DNS的关系与区别
首先ip地址可能表示内网或者外网地址: 内网也就是局域网,最直观的就是像网吧,公司内部的电脑用交换机,HUB,路由连起来的.再通过光钎.猫接入INTERNET的. 外网就像你家里的一台电脑.用猫拨号上 ...
- 手把手教你使用webpack搭建vue框架
我们在使用vue开发项目的时候,都是用vue-cli直接来搭建的.但是这是别人已经造好的轮子,我们既然要使用别人造好的轮子,我们总不能知其然而不知其所以然.所以呢,我这边文章就教你如何使用webpac ...
- NGINX配置详解及应用
目录 NGINX 1 1.1 目录结构 1 1.2 基础配置 1 1.3 location 5 1.4 虚拟主机 5 1.5 状态模块 ...
- stl第二级空间配置器详解(1)
SGI STL考虑到小型内存区块的碎片问题,设计了双层级配置器,第一级配置直接使用malloc()和free():第二级配置器则视情况采用不同的策略,当配置区大于128bytes时,直接调用第一级配置 ...
- Linux下编译Phantomjs
1.安装依赖的库 <pre> sudo apt-get install g++ flex bison gperf ruby perl \ libsqlite3-dev libfontcon ...
- 【BZOJ】3786: 星系探索
[题意]给定一棵带点权树,三种操作: 1.询问点x到根的路径和 2.子树x内的点权加定值y 3.将点x的父亲更换为y,保证仍是树. [算法]平衡树(fhq-treap) [题解] 将树的dfs序作为序 ...
- mysql 时区设置
##查看当前时间 select curtime(); ##查看当前时区设置 show variables like "%time_zone%"; ##修改mysql全局时区为北京时 ...