
PairRDD中算子combineByKey图解
1、combineByKey
combine 为结合意思。
作用: 将RDD[(K,V)] => RDD[(K,C)] 表示V的类型可以转成C两者可以不同类型。
def combineByKey[C](createCombiner:V =>C ,mergeValue:(C,V) =>C, mergeCombiners:(C,C) =>C):RDD[(K,C)]
def combineByKey[C](createCombiner:V =>C ,mergeValue:(C,V) =>C, mergeCombiners:(C,C) =>C,numPartitions:Int ):RDD[(K,C)]
def combineByKey[C](createCombiner:V =>C ,mergeValue:(C,V) =>C, mergeCombiners:(C,C) =>C,partitioner:Partitioner,mapSideCombine:Boolean=true,serializer:Serializer= null):RDD[(K,C)]
第一个函数和第二个函数默认使用的是HashPartitioner、serialize为null。
这个算子还是比较复杂,解释下:
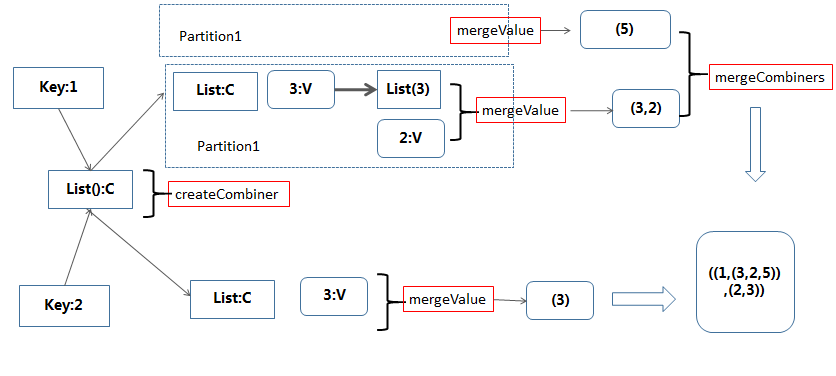
1)createCombiner:在遍历RDD的数据集合过程中,对于遍历到的(k,v),如果combineByKey第一次遇到值为k的Key(类型K),那么将对这个(k,v)调用 createCombiner函数,它的作用是将v转换为c(类型是C,聚合对象的类型,c作为局和对象的初始值)
2)mergeValue: 在遍历RDD的数据集合过程中,对于遍历到的(k,v),如果combineByKey不是第一次(或者第二次,第三次…)遇到值为k的Key(类型K),那么将对这个 (k,v)调用mergeValue函数,它的作用是将v累加到聚合对象(类型C)中,mergeValue的类型是(C,V)=>C,参数中的C遍历到此处的聚合对象,然后对v 进行聚合得到新的聚合对象值。
3)mergeCombiners:因为combineByKey是在分布式环境下执行,RDD的每个分区单独进行combineByKey操作,
最后需要对各个分区的结果进行最后的聚合,它的函数类型是(C,C)=>C,每个参数是分区聚合得到的聚合对象
例子:
scala> val data = sc.parallelize(List(("1","3"),("1","2"),("1","5"),("2","3")))
scala> val natPairRdd = data.combineByKey(List(_), (c: List[String], v: String) => v::c, (c1: List[String], c2: List[String]) => c1 ::: c2)
scala> natPairRdd.collect
res0: Array[(String, List[String])] = Array((1,List(3, 2, 5)), (2,List(3)))
PairRDD中算子combineByKey图解的更多相关文章
- PairRDD中算子aggregateByKey图解
PairRDD 有几个比较麻烦的算子,常理解了后面又忘记了,自己按照自己的理解记录好,以备查阅 1.aggregateByKey aggregate 是聚合意思,直观理解就是按照Key进行聚合. 转化 ...
- PairRDD中算子reduceByKey图解
reduceByKey 函数原型: def reduceByKey(func: (V, V) => V): RDD[(K, V)] def reduceByKey(func: (V, V) =& ...
- PairRDD中算子foldByKey图解
foldByKey 函数原型: def foldByKey(zeroValue: V)(func: (V, V) => V): RDD[(K, V)] def foldByKey(zeroVal ...
- pairRDD中算子reduceByKeyLocally
原型: def reduceByKeyLocally(func: (V, V) => V): Map[K, V] 该函数将RDD[K,V]中每个K对应的V值根据映射函数来运算,运算结果映射到一个 ...
- 带你学习MindSpore中算子使用方法
摘要:本文分享下MindSpore中算子的使用和遇到问题时的解决方法. 本文分享自华为云社区<[MindSpore易点通]算子使用问题与解决方法>,作者:chengxiaoli. 简介 算 ...
- 【Spark篇】---SparkStreaming中算子中OutPutOperator类算子
一.前述 SparkStreaming中的算子分为两类,一类是Transformation类算子,一类是OutPutOperator类算子. Transformation类算子updateStateB ...
- spark中的combineByKey函数的用法
一.函数的源码 /** * Simplified version of combineByKeyWithClassTag that hash-partitions the resulting RDD ...
- Spark中的术语图解总结
参考:http://www.raincent.com/content-85-11052-1.html 1.Application:Spark应用程序 指的是用户编写的Spark应用程序,包含了Driv ...
- ES5和ES6中的继承 图解
Javascript中的继承一直是个比较麻烦的问题,prototype.constructor.__proto__在构造函数,实例和原型之间有的 复杂的关系,不仔细捋下很难记得牢固.ES6中又新增了c ...
随机推荐
- 算法笔记_168:历届试题 矩阵翻硬币(Java)
目录 1 问题描述 2 解决方案 1 问题描述 问题描述 小明先把硬币摆成了一个 n 行 m 列的矩阵. 随后,小明对每一个硬币分别进行一次 Q 操作. 对第x行第y列的硬币进行 Q 操作的定义: ...
- POJ1679 The Unique MST 【次小生成树】
The Unique MST Time Limit: 1000MS Memory Limit: 10000K Total Submissions: 20421 Accepted: 7183 D ...
- C-main函数剖析。
对于main函数.我想不论什么一个接触到C语言的都不会陌生,可是说起main()函数有參数,你可能会产生非常多疑问了. 首先,我们来看下msdn,这个里面对main()函数有具体的说明. 在这里,我们 ...
- UI复习练习_优酷布局
还记得前一周,细致看了一下我自己的代码,特意看了下代码规范,一个好的代码习惯就应该慢慢增加自己寻常练习中. 看看UI吧 watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5 ...
- POJ2226
题意:给定一个矩阵,当中有一些地方有水,如今有一些长度随意,宽为1的木板,要求在全部板不跨越不论什么坑的前提下,用一些木板盖住这些有水的地方,问至少须要几块板子? 思路: watermark/2/te ...
- nginx1.9+新增tcp/udp代理stream
[root@rhel nginx-]# ./configure --help --help print this message --prefix=PATH set installation pref ...
- 微信小程序基于swiper组件的tab切换
代码地址如下:http://www.demodashi.com/demo/14010.html 一.前期准备工作 软件环境:微信开发者工具 官方下载地址:https://mp.weixin.qq.co ...
- pat1040:有几个PAT
https://www.patest.cn/contests/pat-b-practise/1040 #include "stdio.h" int main() { int p = ...
- deque容器的运用一点一点积累
#include<iostream> #include<deque> #include<cstdio> #include<cstring> #inclu ...
- 谈谈easyui datagrid 的数据加载(转)
这篇文章只谈jQuery easyui datagrid 的数据加载,因为这也是大家谈论最多的内容.其实easyui datagrid加载数据只有两种方式:一种是ajax加载目标url返回的json数 ...