
Pytorch实现YOLOv3训练自己的数据集
1.说明:
最近一直在研究深度学习框架PyTorch,就想使用pytorch去实现YOLOv3的object detection.在这个过程中也在各大论坛、贴吧、CSDN等中看了前辈们写的文章,在这里由衷的感谢帮助过我的朋友们,真的很感谢!!!!
接下来就将这一过程写在下面,希望对在学习计算机视觉的小伙伴有一定的帮助2.环境:
笔者的环境:
ubuntu18.04
PyTorch 1.1.0
anaconda
opencv-python
tqdm
matplotlib
pycocotools
如果没有实验环境可以使用如下的方法进行构建:
建议大家安装anaconda,安装过程自行Google,这里就不做过多的解释了
pip install opencv-python

pip install tqdm

pip install matplotlib

pip install pycocotools
制作数据集
制作数据集时,我们需要使用labelImge标注工具,安装过程请参考安装标注工具
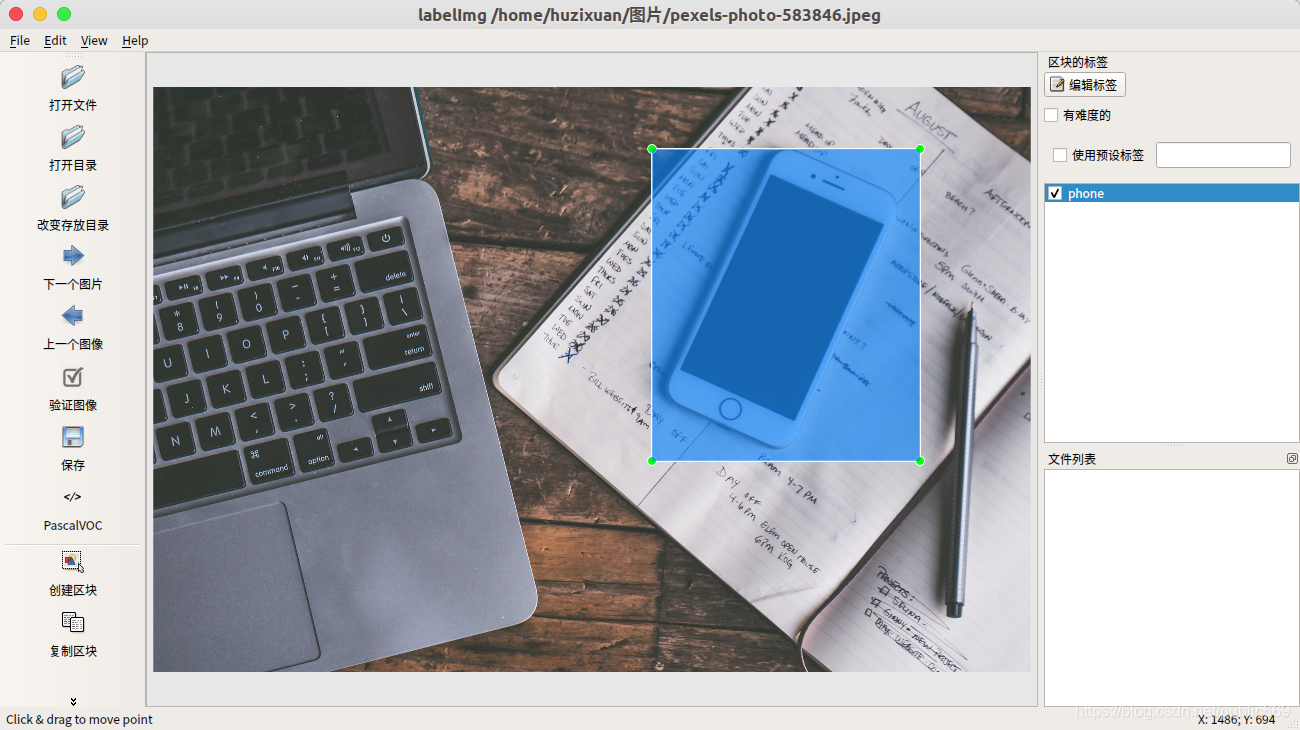
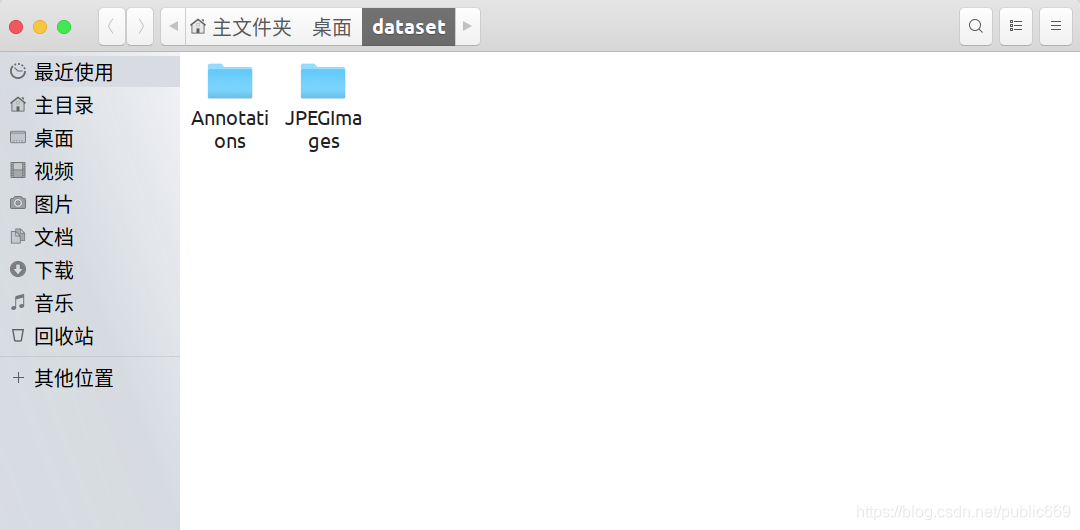
本次我们使用的数据集已经标注好了,我们直接拿过来用:https://github.com/cosmicad/dataset
相关准备
https://github.com/ultralytics/yolov3
首先从上述链接上将pytorch框架clone下来,放在pycharm的工程目录下,这里我把文件重新命名为YOLOV3,这个随便大家。
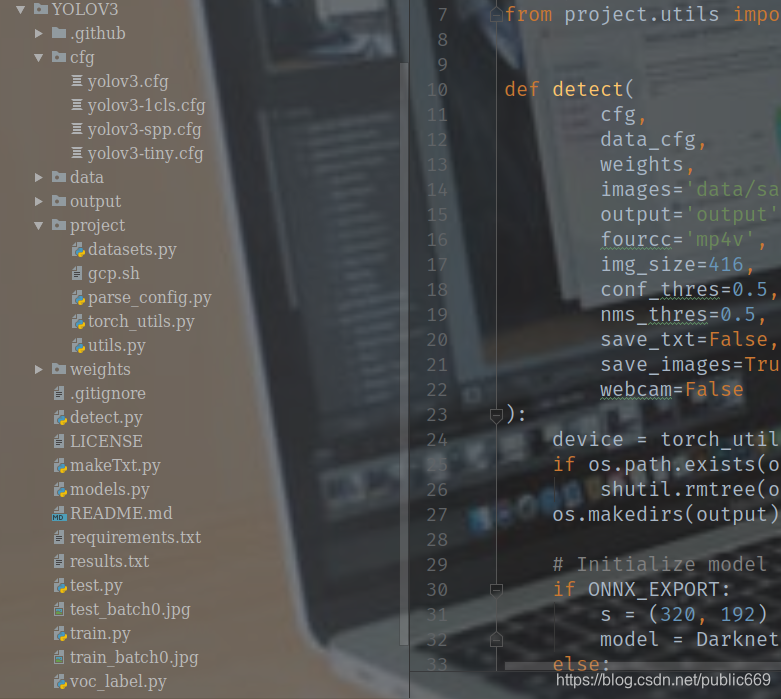
需要说明一下,clone下来的文件一开始是没有makeTxt.py和voc_label.py文件的,这两个需要我们后面自己写代码数据装载
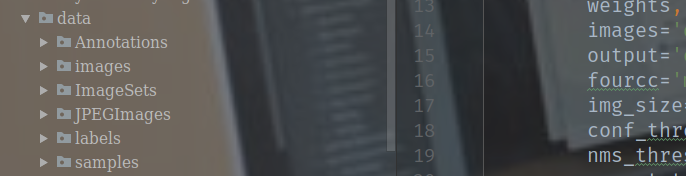
将数据集Annotations、JPEGImages复制到YOLOV3工程目录下的data文件下;同时新建两个文件夹,分别命名为ImageSets和labels,最后我们将JPEGImages文件夹复制粘贴一下,并将文件夹重命名为images
构建代码
在工程的根目录下新建一个文件makeTxt.py,代码如下:
import os

import random

trainval_percent = 0.1

train_percent = 0.9

xmlfilepath = 'data/Annotations'

txtsavepath = 'data/ImageSets'

total_xml = os.listdir(xmlfilepath)

num = len(total_xml)

list = range(num)

tv = int(num * trainval_percent)

tr = int(tv * train_percent)

trainval = random.sample(list, tv)

train = random.sample(trainval, tr)

ftrainval = open('data/ImageSets/trainval.txt', 'w')

ftest = open('data/ImageSets/test.txt', 'w')

ftrain = open('data/ImageSets/train.txt', 'w')

fval = open('data/ImageSets/val.txt', 'w')

for i in list:

    name = total_xml[i][:-4] + '\n'

    if i in trainval:

        ftrainval.write(name)

        if i in train:

            ftest.write(name)

        else:

            fval.write(name)

    else:

        ftrain.write(name)

ftrainval.close()

ftrain.close()

fval.close()

ftest.close()
接着再新建另一个文件voc_label.py,代码如下:
import xml.etree.ElementTree as ET

import pickle

import os

from os import listdir, getcwd

from os.path import join

sets = ['train', 'test','val']

classes = ["RBC"]

def convert(size, box):

    dw = 1. / size[0]

    dh = 1. / size[1]

    x = (box[0] + box[1]) / 2.0

    y = (box[2] + box[3]) / 2.0

    w = box[1] - box[0]

    h = box[3] - box[2]

    x = x * dw

    w = w * dw

    y = y * dh

    h = h * dh

    return (x, y, w, h)

def convert_annotation(image_id):

    in_file = open('data/Annotations/%s.xml' % (image_id))

    out_file = open('data/labels/%s.txt' % (image_id), 'w')

    tree = ET.parse(in_file)

    root = tree.getroot()

    size = root.find('size')

    w = int(size.find('width').text)

    h = int(size.find('height').text)

    for obj in root.iter('object'):

        difficult = obj.find('difficult').text

        cls = obj.find('name').text

        if cls not in classes or int(difficult) == 1:

            continue

        cls_id = classes.index(cls)

        xmlbox = obj.find('bndbox')

        b = (float(xmlbox.find('xmin').text), float(xmlbox.find('xmax').text), float(xmlbox.find('ymin').text),

             float(xmlbox.find('ymax').text))

        bb = convert((w, h), b)

        out_file.write(str(cls_id) + " " + " ".join([str(a) for a in bb]) + '\n')

wd = getcwd()

print(wd)

for image_set in sets:

    if not os.path.exists('data/labels/'):

        os.makedirs('data/labels/')

    image_ids = open('data/ImageSets/%s.txt' % (image_set)).read().strip().split()

    list_file = open('data/%s.txt' % (image_set), 'w')

    for image_id in image_ids:

        list_file.write('data/images/%s.jpg\n' % (image_id))

        convert_annotation(image_id)

    list_file.close()
分别运行makeTxt.py和voc_label.py
运行makeTxt.py后ImagesSets后面会出现四个文件,如下图:
主要存储图片名称
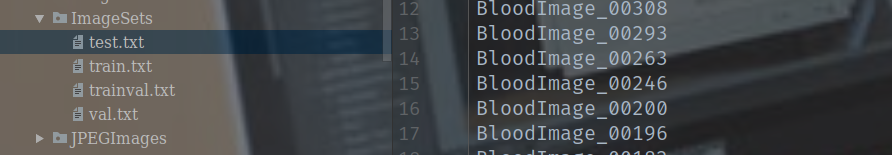
运行voc_label.py后labels后,如下图所示:
这里得到的不光是文件名,还有文件的具体路径

接着还要配置两个文件
在data文件下新建rbc.data,配置内容如下:
classes=1

train=data/train.txt

valid=data/test.txt

names=data/rbc.names

backup=backup/

eval=coco
再在data文件下新建rbc.names,配置内容如下:
RBC

修改cfg
我们需要将cfg下的yolov3-tiny.cfg文件进行修改,修改内容如下:
[net]

# Testing

batch=1

subdivisions=1

# Training

# batch=64

# subdivisions=2

width=416

height=416

channels=3

momentum=0.9

decay=0.0005

angle=0

saturation = 1.5

exposure = 1.5

hue=.1

learning_rate=0.001

burn_in=1000

max_batches = 500200

policy=steps

steps=400000,450000

scales=.1,.1

[convolutional]

batch_normalize=1

filters=16

size=3

stride=1

pad=1

activation=leaky

[maxpool]

size=2

stride=2

[convolutional]

batch_normalize=1

filters=32

size=3

stride=1

pad=1

activation=leaky

[maxpool]

size=2

stride=2

[convolutional]

batch_normalize=1

filters=64

size=3

stride=1

pad=1

activation=leaky

[maxpool]

size=2

stride=2

[convolutional]

batch_normalize=1

filters=128

size=3

stride=1

pad=1

activation=leaky

[maxpool]

size=2

stride=2

[convolutional]

batch_normalize=1

filters=256

size=3

stride=1

pad=1

activation=leaky

[maxpool]

size=2

stride=2

[convolutional]

batch_normalize=1

filters=512

size=3

stride=1

pad=1

activation=leaky

[maxpool]

size=2

stride=1

[convolutional]

batch_normalize=1

filters=1024

size=3

stride=1

pad=1

activation=leaky

###########

[convolutional]

batch_normalize=1

filters=256

size=1

stride=1

pad=1

activation=leaky

[convolutional]

batch_normalize=1

filters=512

size=3

stride=1

pad=1

activation=leaky

[convolutional]

size=1

stride=1

pad=1

filters=18

activation=linear

[yolo]

mask = 3,4,5

anchors = 10,14,  23,27,  37,58,  81,82,  135,169,  344,319

classes=1

num=6

jitter=.3

ignore_thresh = .7

truth_thresh = 1

random=1

[route]

layers = -4

[convolutional]

batch_normalize=1

filters=128

size=1

stride=1

pad=1

activation=leaky

[upsample]

stride=2

[route]

layers = -1, 8

[convolutional]

batch_normalize=1

filters=256

size=3

stride=1

pad=1

activation=leaky

[convolutional]

size=1

stride=1

pad=1

filters=18 #3*(class + 4 + 1)

activation=linear

[yolo]

mask = 0,1,2

anchors = 10,14,  23,27,  37,58,  81,82,  135,169,  344,319

classes=1

num=6

jitter=.3

ignore_thresh = .7

truth_thresh = 1

random=1
需要将filters=18 #3*(class + 4 + 1)这一行改为filters=18,否则会报如下的错误:
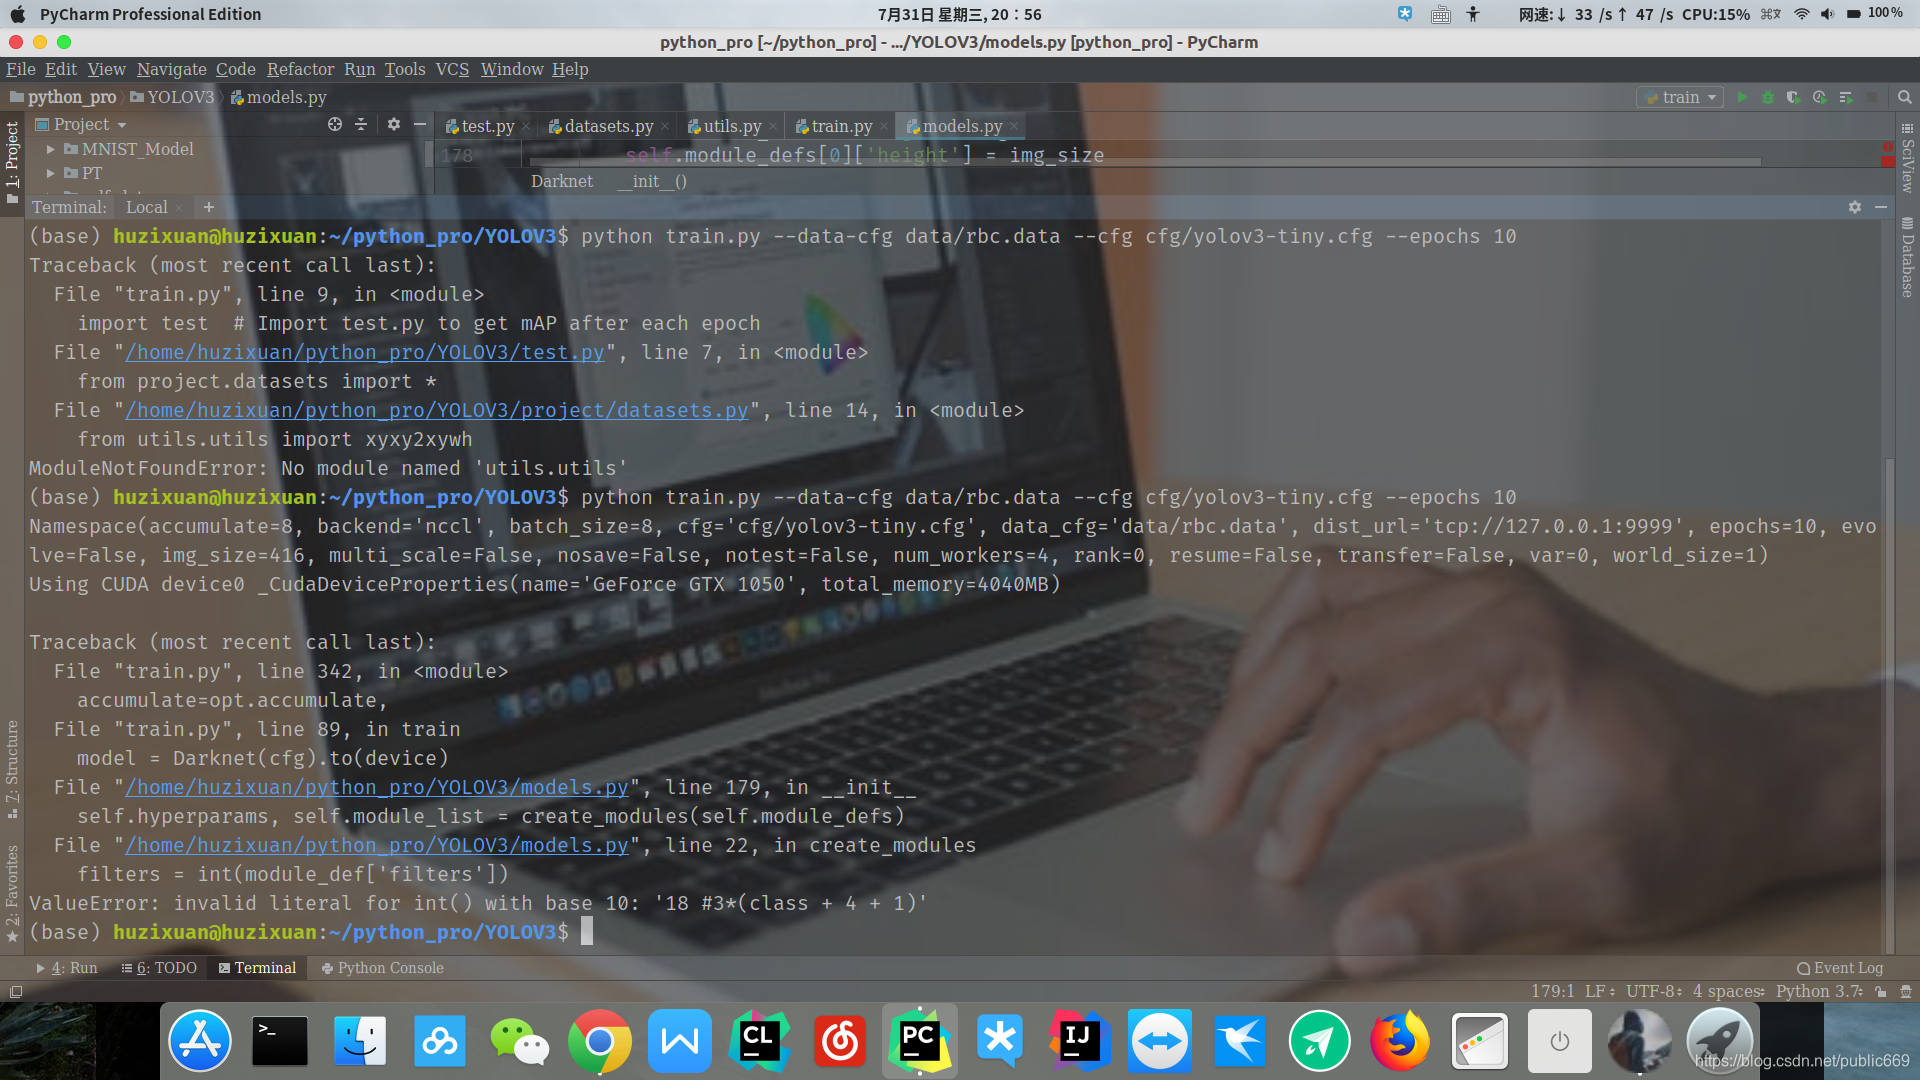
接着,获取网络参数yolov3-tiny.weights,下载链接https://pjreddie.com/media/files/yolov3-tiny.weights,下载后导入weights文件夹下;同样还需要下载yolov3-tiny.conv.15,下载导入weights文件夹下,下载链接如下:https://pan.baidu.com/s/1nv1cErZeb6s0A5UOhOmZcA
提取码:t7vp
训练
在当前项目文件下使用Terminal,可以使用pycharm中的Terminal,也可以使用liunx系统的Terminal,输入如下命令
说明:epoches 10 不是固定的,大家可以根据实际训练情况自行修改
python train.py --data-cfg data/rbc.data --cfg cfg/yolov3-tiny.cfg --epochs 10
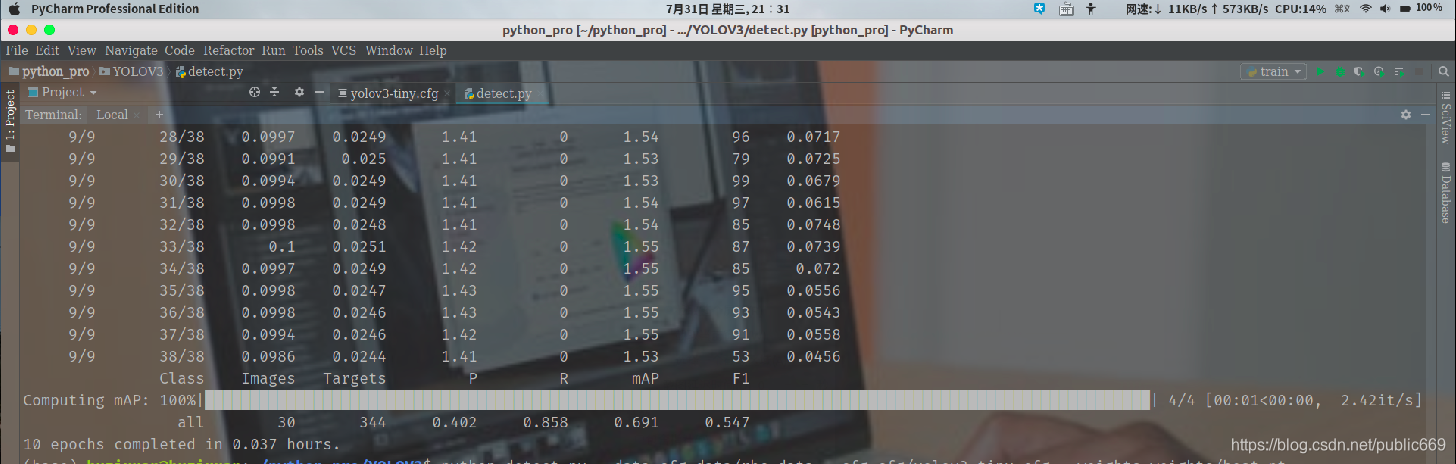
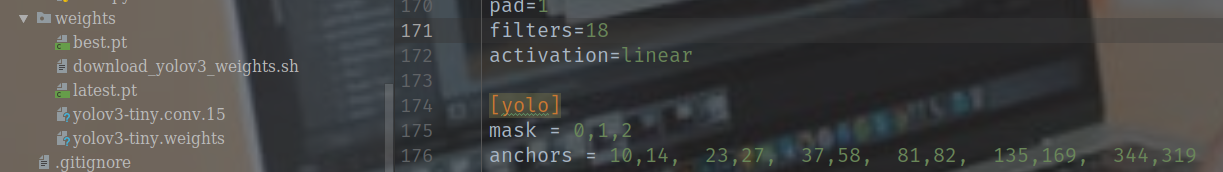
训练之后会得到模型:
预测
同样在Terminal下输入以下命令:
python detect.py --data-cfg data/rbc.data --cfg cfg/yolov3-tiny.cfg --weights weights/best.pt
解决一些小bug:
关于出现如下的情况
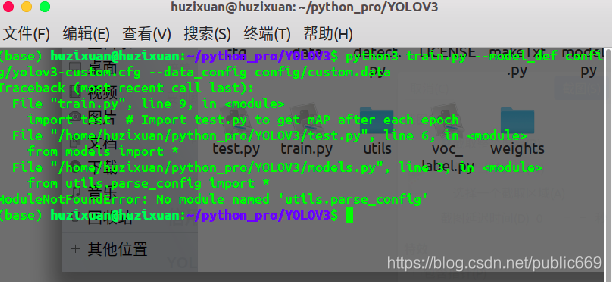
解决方法:
这个问题是由于本项目下有一个utils的文件目录,但是呢python本身就有一个utils;通常情况下我们是用import utils的方法导入的。解决这个问题我们只需将本项目的utils改一个名字即可,笔者是改为project的,同样也需要将相关文件进行修改,修改如下:
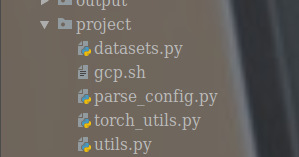
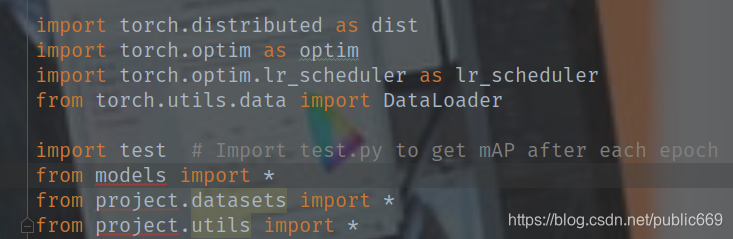
说明:我们需要将train.py和test.py等文件下的所有的utils全修改为project
有问题欢迎添加qq:1017190168讨论,进步
完整项目源码:
链接:https://pan.baidu.com/s/1dBaDP0ImTrAADg_KvB-0eQ
Pytorch实现YOLOv3训练自己的数据集的更多相关文章
- Win10中用yolov3训练自己的数据集全过程(VS、CUDA、CUDNN、OpenCV配置,训练和测试)
在Windows系统的Linux系统中用yolo训练自己的数据集的配置差异很大,今天总结在win10中配置yolo并进行训练和测试的全过程. 提纲: 1.下载适用于Windows的darknet 2. ...
- pytorch版yolov3训练自己数据集
目录 1. 环境搭建 2. 数据集构建 3. 训练模型 4. 测试模型 5. 评估模型 6. 可视化 7. 高级进阶-网络结构更改 1. 环境搭建 将github库download下来. git cl ...
- 第十一节,利用yolov3训练自己的数据集
1.环境配置 tensorflow1.12.0 Opencv3.4.2 keras pycharm 2.配置yolov3 下载yolov3代码:https://github.com/qqwweee/k ...
- Win7+keras+tensorflow使用YOLO-v3训练自己的数据集
一.下载和测试模型 1. 下载YOLO-v3 git clone https://github.com/qqwweee/keras-yolo3.git 这是在Ubuntu里的命令,windows直接去 ...
- YoLov3训练自己的数据集
工具:labelimg.MobaXterm 1.标注自己的数据集.用labelimg进行标注,保存后会生成与所标注图片文件名相同的xml文件,如图.我们标注的是井盖和路边栏,名称分了NoManhole ...
- Ubuntu16.04中用yolov3训练自己的数据集
一.配置yolo v3 参考yolo v3官网https://pjreddie.com/darknet/yolo/ 下载darknet后进行编译: git clone https://github.c ...
- 如何使用yolov3训练自己的数据集
博客主要结构 1. 如何在ubuntu18.04上安装yolo 2 .如何配置yolov3 3 .如何制作自己的训练集测试集 4 .如何在自己的数据集上运行yolov3 1. 在ubuntu18.04 ...
- 目标检测-基于Pytorch实现Yolov3(1)- 搭建模型
原文地址:https://www.cnblogs.com/jacklu/p/9853599.html 本人前段时间在T厂做了目标检测的项目,对一些目标检测框架也有了一定理解.其中Yolov3速度非常快 ...
- 利用YOLOV3训练自己的数据
写在前面:YOLOV3只有修改了源码才需要重新make,而且make之前要先make clean. 一.准备数据 在/darknet/VOCdevkit1下建立文件夹VOC2007. voc2007文 ...
- Pytorch多GPU训练
Pytorch多GPU训练 临近放假, 服务器上的GPU好多空闲, 博主顺便研究了一下如何用多卡同时训练 原理 多卡训练的基本过程 首先把模型加载到一个主设备 把模型只读复制到多个设备 把大的batc ...
随机推荐
- 深入探究API接口
作为程序员,我们经常会遇到需要获取外部数据或调用外部服务的情况.而API(Application Programming Interface,应用程序编程接口)接口就是这样的一种机制,它允许我们的应用 ...
- firefox对webview性能数据监控的模拟
现在为了降低手机端的开发成本,越来越多的手机应用采用html5在进行开发,这样可以保证一处开发,到处嵌入. 但是这样的手机性能经常会是个瓶颈,因为当体验要求变高时,大多依赖html渲染引擎来对dom数 ...
- 我的新书《Flink大数据分析实战》出版啦
- 【matplotlib基础】--图例
Matplotlib 中的图例是帮助观察者理解图像数据的重要工具.图例通常包含在图像中,用于解释不同的颜色.形状.标签和其他元素. 1. 主要参数 当不设置图例的参数时,默认的图例是这样的. impo ...
- jquery设置图片可手动拖拽
JQuery是一款流行的JavaScript框架,可以轻松实现网页交互效果.而其中一种常见效果是图片手动拖拽.以下是设置图片手动拖拽的JQuery代码. 1 2 3 4 5 6 7 8 9 10 11 ...
- CF1746F Kazaee
prologue 数组范围一定要看好了开,不然容易我一样,调试调了一页多. 还有就是不要傻乎乎地只跑一次和哈希,因为和哈希(从下面地佬的题解中才知道)它其实算作是一种 trick(类比SA(Stimu ...
- 2023 Visual Studio Code 插件推荐:18 个提高开发效率的常用插件
Visual Studio Code (简称VSCode) 是一款强大的开源代码编辑器,它拥有众多功能强大的扩展插件,使得开发者可以根据自己的需求来定制编辑器的功能和外观.在本文中,我们将分享一些非常 ...
- cv2 数学基础---矩阵微分
矩阵微分基础知识 定义 重要结论 应用 定义 (1) 向量对标量求导 矩阵对标量求导 我们可以看到上述求导过程实际上就是不同函数对变量求导,然后按照向量或者矩阵的形式排列,注意这里结果的结构应该与函数 ...
- Pinely Round 2 (Div. 1 + Div. 2) (CF1863)
本来开了某场远古 Div 1,然后学了一堆前置知识至今仍然不会 E.换一场写来得及吗? A. Channel 模拟,略. B. Split Sort Description 给你一个长度为 \(n\) ...
- 概率期望 DP 题解合集
期望这东西学了一次忘了,再学一次过了两天又不会了.我是鱼. 故写此博客以便加深记忆及日后复习. NOIP 前恶补期望(? 希望有用,RP++() 经典问题 1 某事件发生概率为 \(p\),则该事件首 ...